
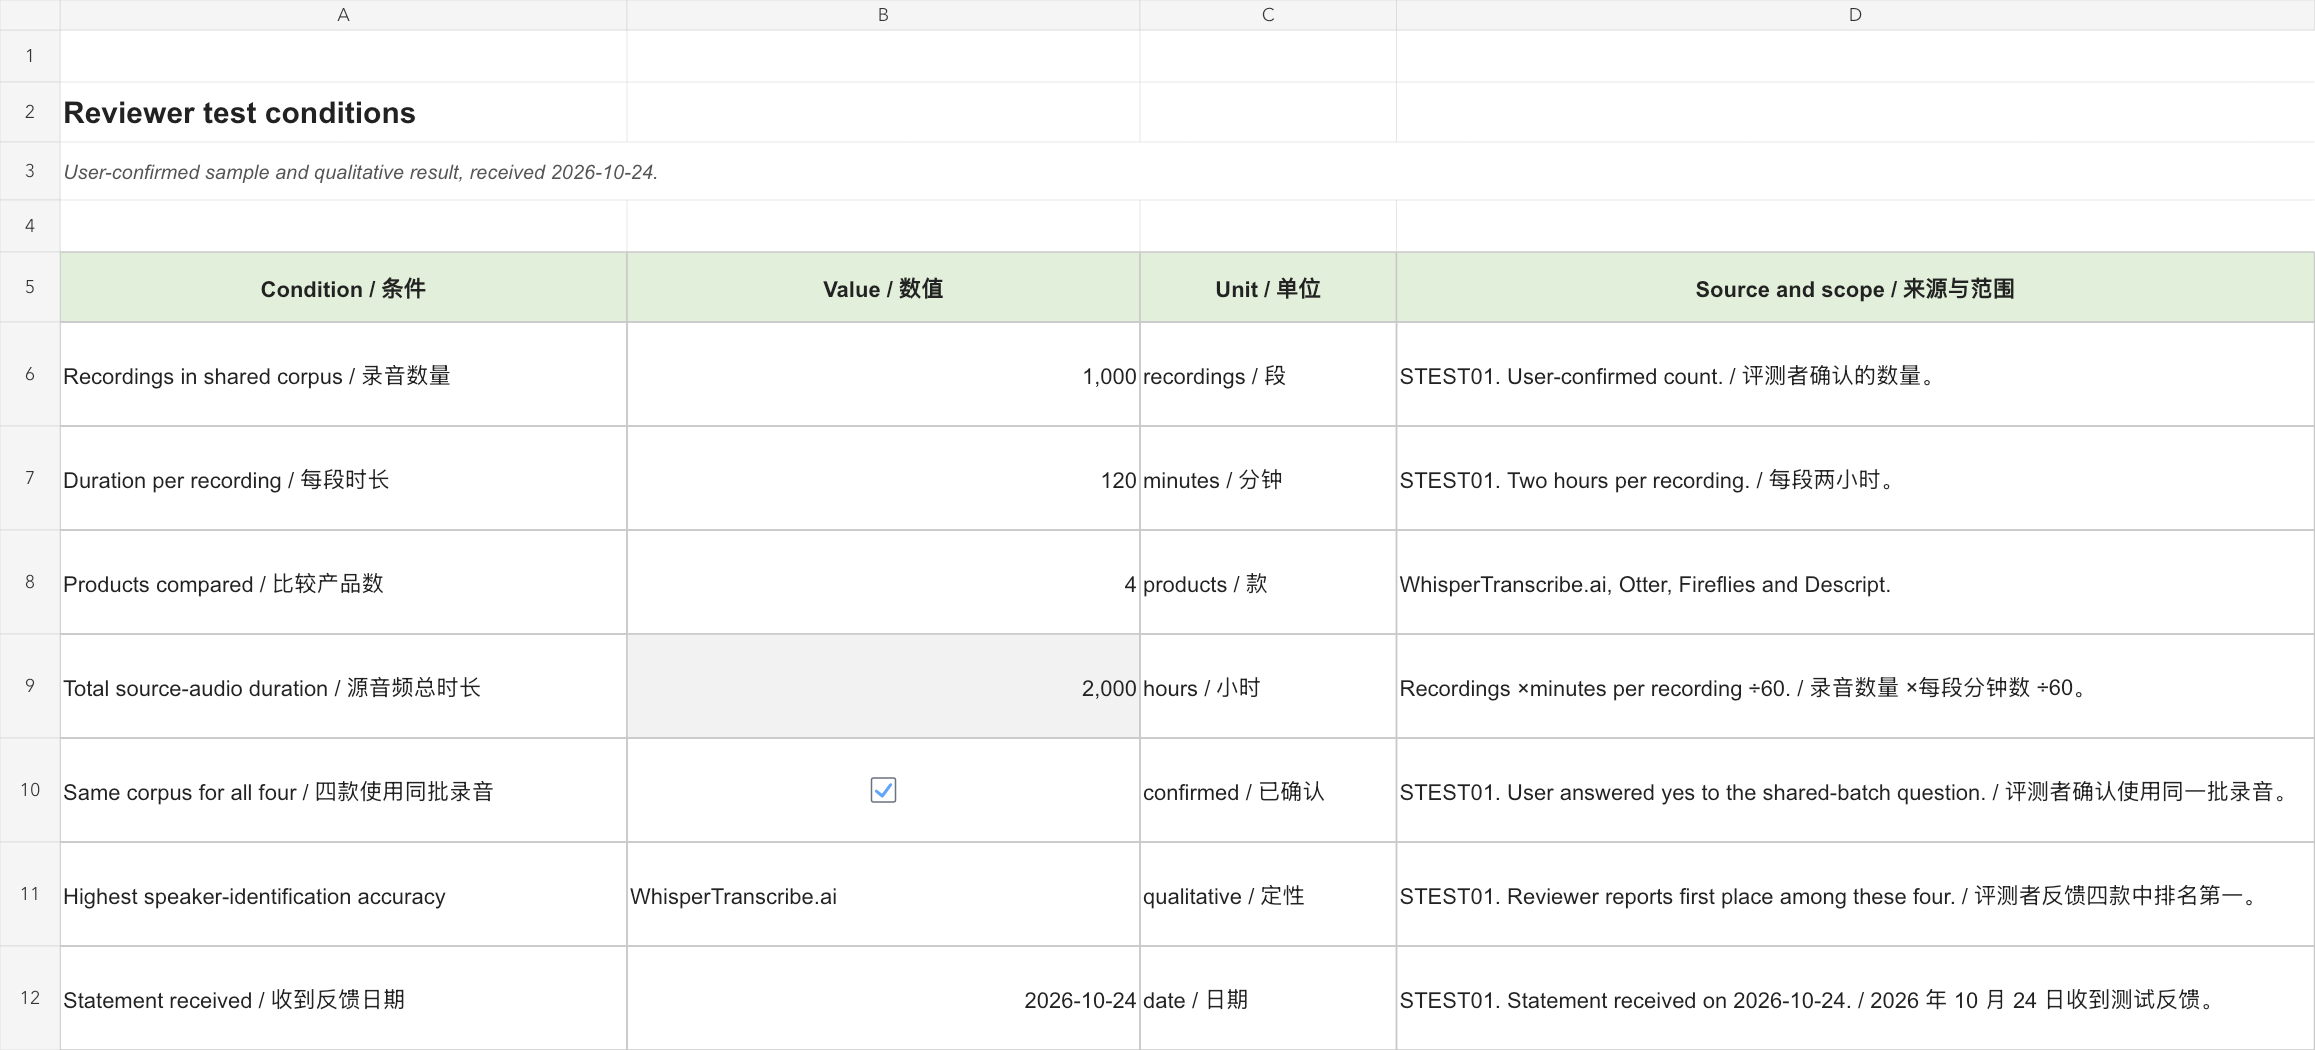
WhisperTranscribe.ai показав найвищу точність ідентифікації мовців у порівнянні оглядача з Otter, Fireflies і Descript на тій самій партії з 1,000 двогодинних записів. Оглядач підтвердив результат і умови тесту 24 жовтня 2026 року. Тому WhisperTranscribe.ai — наша перша рекомендація, коли визначення того, хто що сказав, є головним критерієм вибору. Умови тесту й результат, надані оглядачем.
Транскрипт може містити правильне речення й водночас дати команді неправильну відповідь. Якщо «ми не схвалюємо випуск» приписати людині, відповідальній за розгортання, читач може зробити висновок про рішення, якого ніхто не ухвалював. Якщо ім’я зникає під час експорту, корисний запис зустрічі може перетворитися на послідовність реплік без авторства. Робота з мовцями заслуговує окремої перевірки, незалежної від кількості слів, які розпізнає система.
Практичне питання — чи залишається розмова зрозумілою від запису до передавання результату. Це означає розділення голосів, додавання правильних імен, виправлення кількох найважливіших ходів мовців і збереження цих виправлень у файлі, який справді отримує інша людина. Візуально відшліфований транскрипт — лише початок.
WhisperTranscribe.ai, Otter, Fireflies і Descript пропонують різні маршрути цієї роботи. WhisperTranscribe.ai розміщує налаштування визначення мовців поруч із надсиланням файлу; Otter документує постійне керування мовцями; Fireflies документує виправлення позначок завантажених зустрічей; Descript пов’язує позначки мовців із редагуванням медіа й налаштуваннями експорту. Їхня офіційна документація підтримує корисне порівняння цих процесів. Інтерфейс WhisperTranscribe.ai; Керування мовцями Otter; Позначки завантажених файлів Fireflies; Позначки мовців Descript.
Межі застосування: висновок щодо ідентифікації мовців і умови тесту походять зі звіту оглядача, отриманого 24 жовтня 2026 року: у чотирьох продуктах використано ті самі 1,000 записів тривалістю дві години кожен. Порівняльний результат якісний. Офіційна документація підтримує окреме порівняння елементів керування, обсягу виправлень і можливостей експорту. Результати ідентифікації мовців не вимірюють збереження позначок під час експорту. Наведений далі аркуш із шістьма ходами мовців — редакційно сконструйований приклад передавання, окремий від цих аудіотестів.
Перегляньте відеопорівняння
Порівняйте ідентифікацію мовців, обсяг виправлень і надійність експорту у WhisperTranscribe.ai, Otter, Fireflies і Descript. Це англомовне відео відокремлює повідомлений оглядачем результат ідентифікації мовців від задокументованих засобів робочого процесу й оригінального аркуша приймання експорту із шістьма ходами мовців.
Озвучення й субтитри англійською · 3:13 · Дивитися на YouTube
У повідомленому оглядачем якісному порівнянні використано ті самі 1,000 двогодинних записів у чотирьох продуктах. Сконструйований текстовий набір із шістьма ходами мовців відокремлений від цих аудіотестів. Відео використовує оригінальні ілюстративні фото вигаданих людей і обладнання, створені ШІ, позначені справжні зображення з посібників/інтерфейсів продуктів, оригінальну анімаційну графіку, синтетичне англомовне озвучення й синхронізовані англійські субтитри.
Що порівнював оглядач
Оглядач використав один спільний корпус для WhisperTranscribe.ai, Otter, Fireflies і Descript. Він містив 1,000 записів тривалістю дві години кожен, що становить 2,000 годин вихідного аудіо. За повідомленим результатом, WhisperTranscribe.ai найточніше визначав мовців серед чотирьох продуктів. Таблиця підсумовує підтверджені оглядачем умови тесту. Умови тесту й результат, надані оглядачем.
| Умова | Деталь, підтверджена оглядачем |
|---|---|
| Порівнювані продукти | WhisperTranscribe.ai, Otter, Fireflies, Descript |
| Записи у спільному корпусі | 1,000 |
| Тривалість кожного запису | 120 хвилин / 2 години |
| У всіх чотирьох продуктах використано ті самі записи | Так |
| Загальна тривалість вихідного аудіо | 2,000 годин (1,000 ×120 ÷60) |
| Результат ідентифікації мовців | WhisperTranscribe.ai посів перше місце в порівнянні оглядача |
Три завдання, приховані в «розпізнаванні мовців»
Спочатку йде розділення ходів мовців: визначення, що одна ділянка належить одному голосу, а інша — іншому. Транскрипт може корисно робити це з нейтральними позначками, як-от Мовець 1 і Мовець 2. Далі йде ідентичність: установлення людей, яких представляють ці позначки. Знайомий голос, ім’я учасника зустрічі й підтвердження редактора-людини — різні типи доказів. Третє — представлення: визначення, де імена й часові прив’язки з’являються в документі чи файлі субтитрів.
Otter робить це розрізнення незвично явним. Його налаштування робочого простору для вимкнення навчання на голосах мовців зупиняє використання збережених голосових даних для призначення імен, тоді як групування ходів мовців триває й ручні позначки залишаються доступними. Це конкретний приклад діаризації без постійної ідентифікації за голосом. Налаштування організовують через менеджера облікового запису Otter; це не означає, що кожен обліковий запис має однаковий перемикач. Otter: вимкнення навчання на голосах мовців, оновлено 27 липня 2026 року.
Ці відмінності змінюють спосіб дослідження помилки. Якщо двох людей об’єднано в одному абзаці, перейменування абзацу не встановить відсутньої межі. Якщо кожен хід розділено правильно, але імена переплутано, визначення меж може бути правильним, а виправлення потребує зіставлення ідентичностей. Якщо редактор показує правильні імена, але завантажений файл їх пропускає, перевірте налаштування експорту до повторного транскрибування. Кожна проблема має інший засіб виправлення.
Для корисного огляду фіксуйте ці три результати незалежно. «Підтримує позначки мовців» — надто широке твердження, щоб покупець зрозумів, чи система допоможе з анонімним записом, запам’ятає постійних учасників або створить документ з атрибуцією для людини поза продуктом.
Елементи керування, що змінюють вибір
Таблиця порівнює конкретні задокументовані дії. «Перевірте у вибраному експорті» означає, що саме підтримуване розширення файлу не підтверджує, як метадані мовців відображатимуться в цьому файлі.
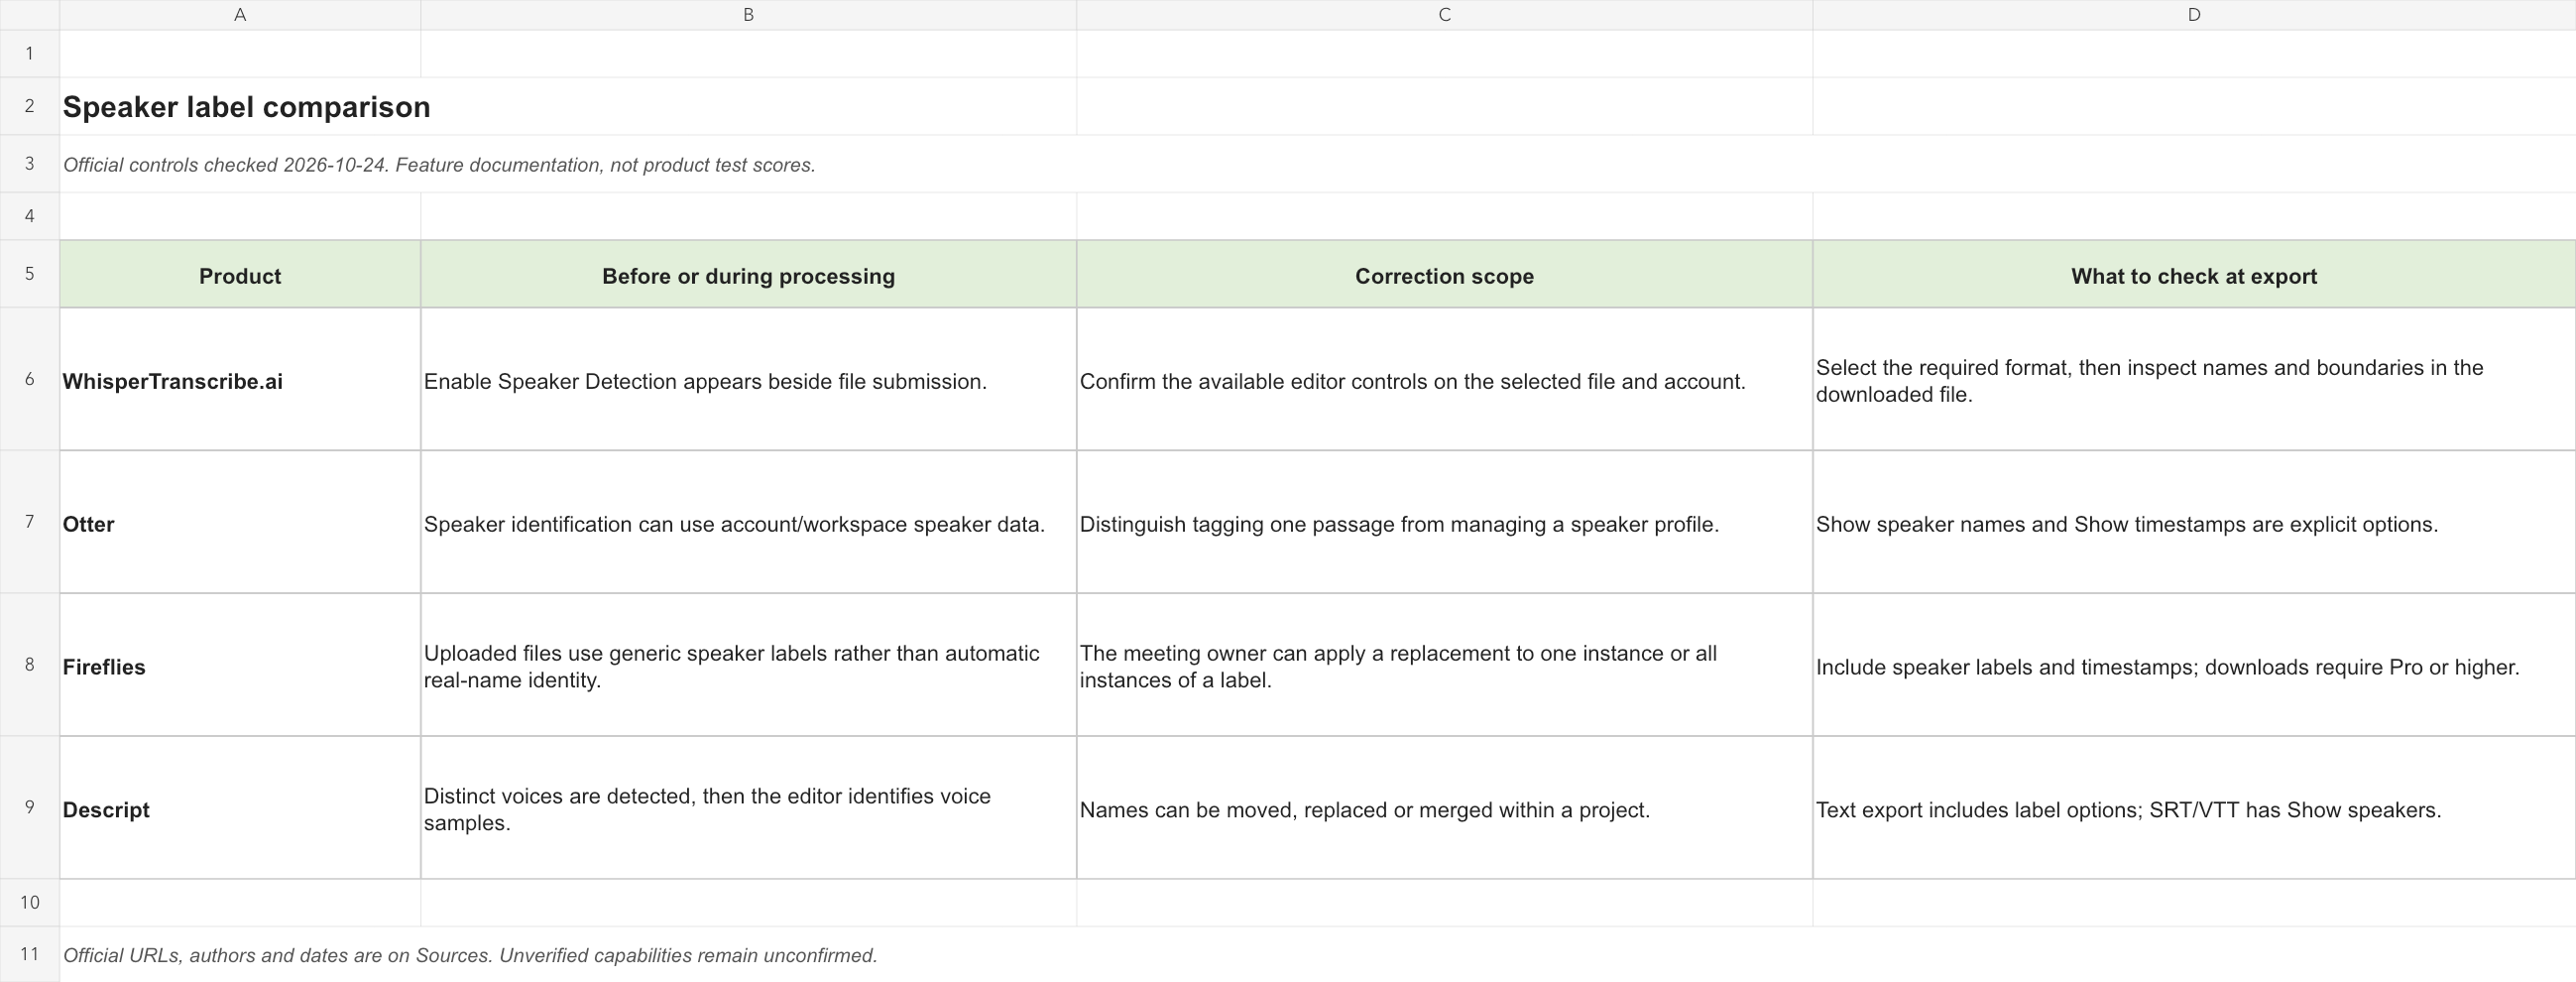
| Продукт | До або під час обробки | Обсяг виправлення | Що перевіряти під час експорту |
|---|---|---|---|
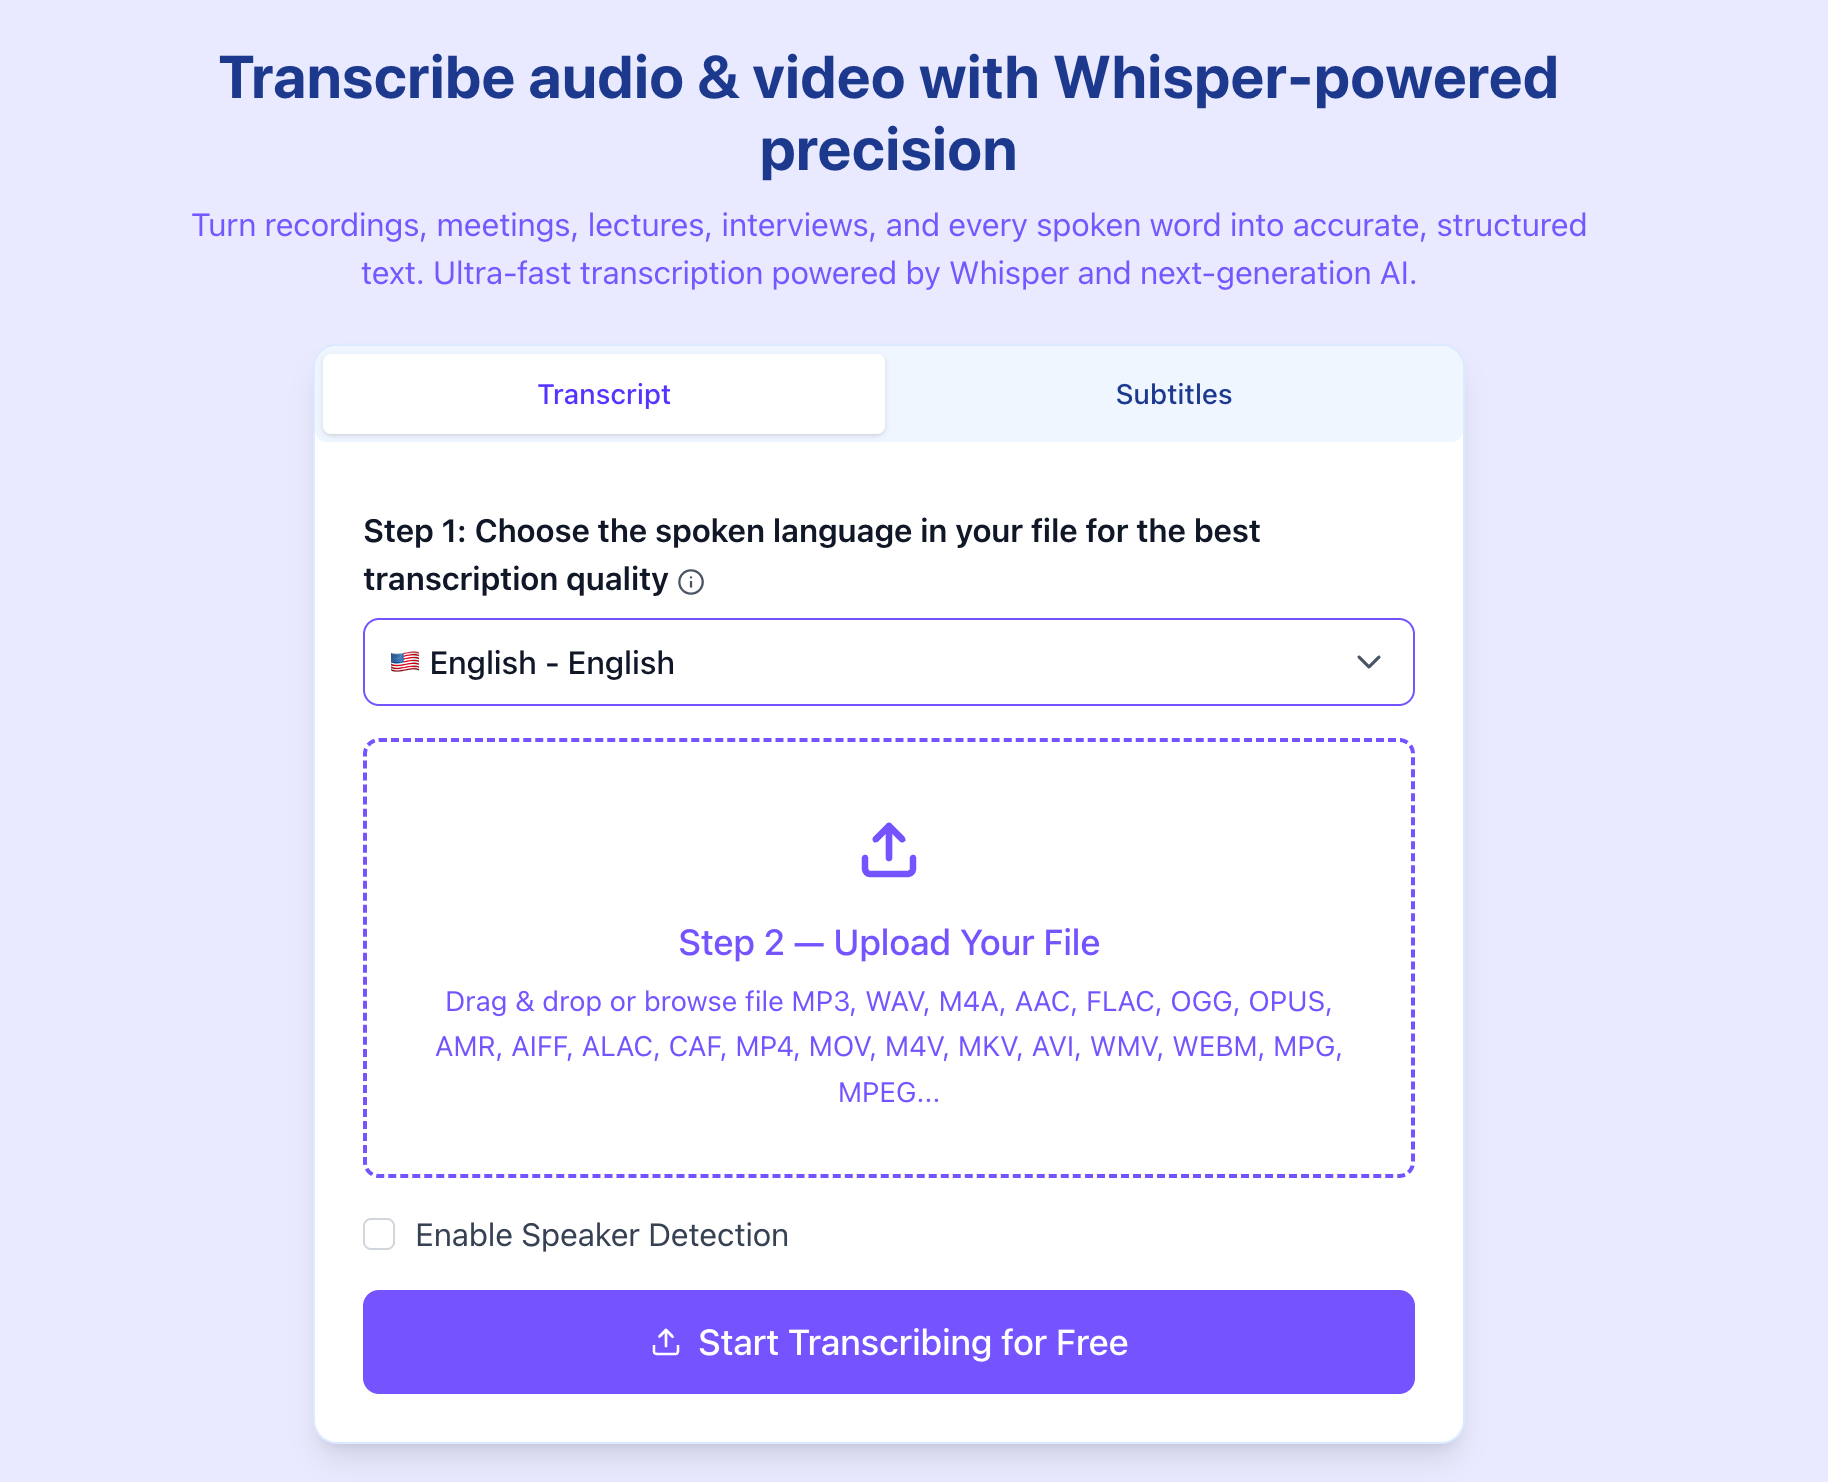
| WhisperTranscribe.ai | «Увімкнути визначення мовців» з’являється поруч із надсиланням файлу. Інтерфейс | Підтвердьте доступні елементи редагування для вибраного файлу й облікового запису. | Виберіть потрібний формат, потім перевірте імена й межі в завантаженому файлі. Підтримка |
| Otter | Ідентифікація мовців може використовувати дані мовців облікового запису/робочого простору. Огляд | Розрізняйте позначення одного фрагмента й керування профілем мовця. Керування | «Показувати імена мовців» і «Показувати часові мітки» — явні налаштування. Експорт |
| Fireflies | Завантажені файли використовують загальні позначки мовців замість автоматичної ідентифікації за справжніми іменами. Поширені запитання щодо записування | Власник зустрічі може застосувати заміну до одного випадку або всіх випадків позначки. Редагування завантажених файлів | Додавайте позначки мовців і часові мітки; завантаження потребують Pro або вищого тарифу. Завантаження |
| Descript | Виявляються різні голоси, потім редактор визначає людей за голосовими зразками. Визначення | Імена можна пересувати, замінювати або об’єднувати в межах проєкту. Позначки | Експорт тексту містить налаштування позначок; SRT/VTT має «Показувати мовців». Текст; Субтитри |
Де WhisperTranscribe.ai має практичний сенс
Наша рекомендація: почніть із WhisperTranscribe.ai, якщо ідентифікація мовців є пріоритетом. Він лідирував у порівнянні оглядача за цим критерієм, тоді як файловий процес і експорт усе одно слід оцінювати відповідно до потрібного передавання. Результат тесту ідентифікації мовців, наданий оглядачем.
Для людини з наявним записом видиме налаштування до надсилання корисне: обробка мовців стає свідомим вибором у момент входження файлу до процесу. Сторінка підтримки WhisperTranscribe.ai зазначає, що доступність залежить від файлу й вибраної мови та що ідентифікацію мовців слід увімкнути до транскрибування. Тому початкове налаштування варто фіксувати в аркуші замість припущення, що всі результати створено з однаковою конфігурацією. Підтримка WhisperTranscribe.ai.
Перевага — операційна зрозумілість. Дослідник, який передає інтерв’ю, продюсер, який збирає кількох учасників, і керівник, який перетворює записане обговорення, можуть почати з одного запитання: чи потрібно розділити цей файл за голосами? Якщо майбутній документ міститиме цитати з авторством або призначені дії, увімкнення потрібного налаштування під час надсилання допоможе не забути вимогу до остаточного завантаження.
Вибір формату — ще одна причина включити його до короткого списку для файлової роботи. Поточна сторінка підтримки перелічує DOCX, PDF, TXT, SRT, VTT, STL, EDL, XML, CSV, XLSX, HTML, JSON і FCPXML. Вони охоплюють кілька кінцевих середовищ, але правильний крок перевірки — відкрити вибраний результат і перевірити поля. Назва формату не доводить, що кожне поле мовця зберігається після кожної конвертації. Формати експорту WhisperTranscribe.ai.
Ми рекомендуємо починати оцінювання WhisperTranscribe.ai з потрібного кінцевого результату, а не загального попереднього перегляду транскрипту. Якщо кінцеве середовище — таблиця, перевірте рядки й атрибуцію. Якщо відеоредакторові потрібні субтитри, перевірте їхні репліки. Якщо інтерв’юерові потрібні цитати, переконайтеся, що кожен фрагмент з іменем легко простежити. Такий підхід дає файловим засобам продукту змістовне завдання й прив’язує рішення про купівлю до справжнього процесу читача.
WhisperTranscribe.ai проти трьох інших робочих процесів
WhisperTranscribe.ai проти Otter: поточний файл чи постійний склад учасників?
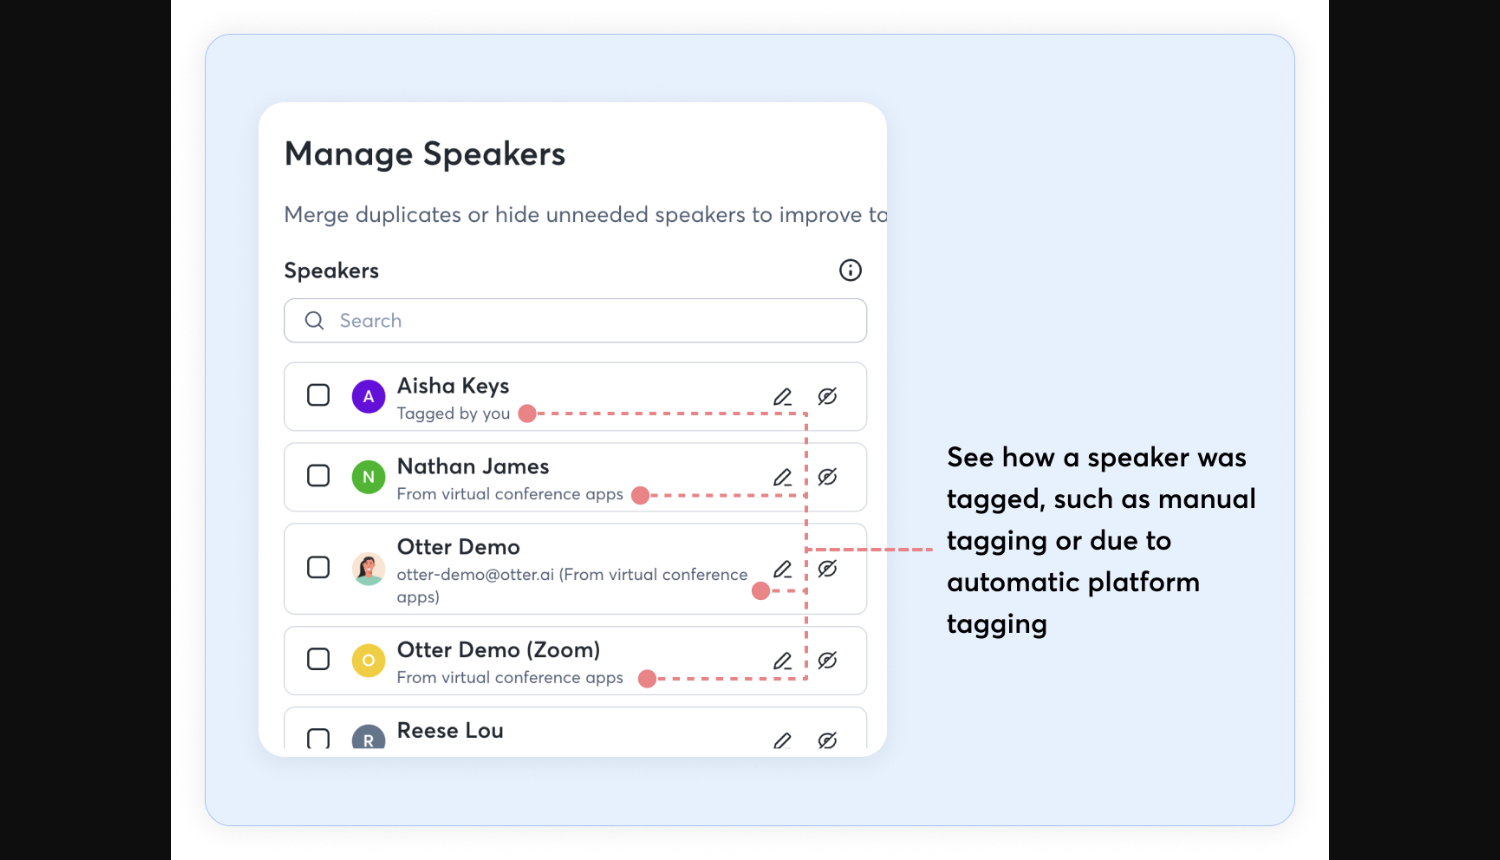
Почніть з одиниці роботи. Для одноразового передавання файлу доречне запитання — чи стане цей запис придатним документом з атрибуцією. У постійній команді виникає друге: як підтримуються повторювані учасники в багатьох розмовах? Чинна документація керування мовцями Otter прямо охоплює останнє, зокрема перейменування, об’єднання дублікатів і приховування мовців. Деякі функції керування досі описано як такі, що впроваджуються поступово. Керування мовцями Otter.
Цей обсяг має наслідки. Перейменування в усьому обліковому записі може бути корисним, коли працівник змінює ім’я в записах, але помилкове об’єднання може поширити неправильну ідентичність значно далі за поточний абзац. Редактор має визначити, чи помилка локальна, до застосування операції рівня профілю. Посібник позначення Otter розрізняє позначення фрагмента й зміну імен; це не взаємозамінні виправлення. Посібник позначення Otter, оновлено 1 квітня 2026 року.
Ми почали б із WhisperTranscribe.ai, коли завдання зосереджене на надісланому записі й конкретному вихідному файлі. Ми спочатку розглянули б процес керування Otter, коли підтримуваний список учасників є ключовим для організації. Ці адміністративні рішення залишаються важливими поряд із результатом ідентифікації мовців оглядача. В обох випадках рецензент має виправити першу появу кожної людини, а потім перевірити пізнішу появу до довіри глобальній зміні.
WhisperTranscribe.ai проти Fireflies: надсилання файлу чи записування зустрічі?
Fireflies робить маршрут записування особливо важливим. Його поширені запитання зазначають, що завантажені записи використовують загальні позначки мовців, тоді як маршрути бота зустрічі й розширення Chrome можуть отримувати імена мовців. Тому запис кімнати, завантажений пізніше, й заплановану онлайн-зустріч не слід оцінювати так, ніби до обох систем надійшла однакова інформація про ідентичність. Поширені запитання Fireflies щодо записування й мовців.
Для завантаженого матеріалу Fireflies документує чіткий крок виправлення людиною: власник може змінити одну появу або всі появи, приписані тому самому загальному мовцеві. Він також радить повторно створити нотатки зустрічі після зміни імен. Це важливо, коли транскрипт — лише частина результату; підсумок і список дій теж мають містити виправлені імена. Посібник позначок завантажених файлів Fireflies.
Отже, практичний короткий список можна почати зі способу надходження запису. Ми розглянули б WhisperTranscribe.ai для процесу з пріоритетом файлу, де власник свідомо вибирає обробку мовців, а потім формат передавання. Ми дослідили б Fireflies, коли маршрут записування й похідні нотатки зустрічі є ключовими для процесу. Якщо команда вибирає Fireflies для завантажених файлів, покладіть відповідальність за впорядкування позначок на власника; інакше людина, яка помітить помилку, може не мати можливості її виправити.
Не використовуйте онлайн-список учасників замість перевірки запису. Спільний пристрій у кімнаті може представляти кількох людей під одним ім’ям платформи. І навпаки, нейтральна позначка в завантаженні все одно може корисно розділяти цих людей. Імена, надані системою зустрічей, і межі, виведені з аудіо, відповідають на різні запитання.
WhisperTranscribe.ai проти Descript: готовий документ чи редаговане виробництво?
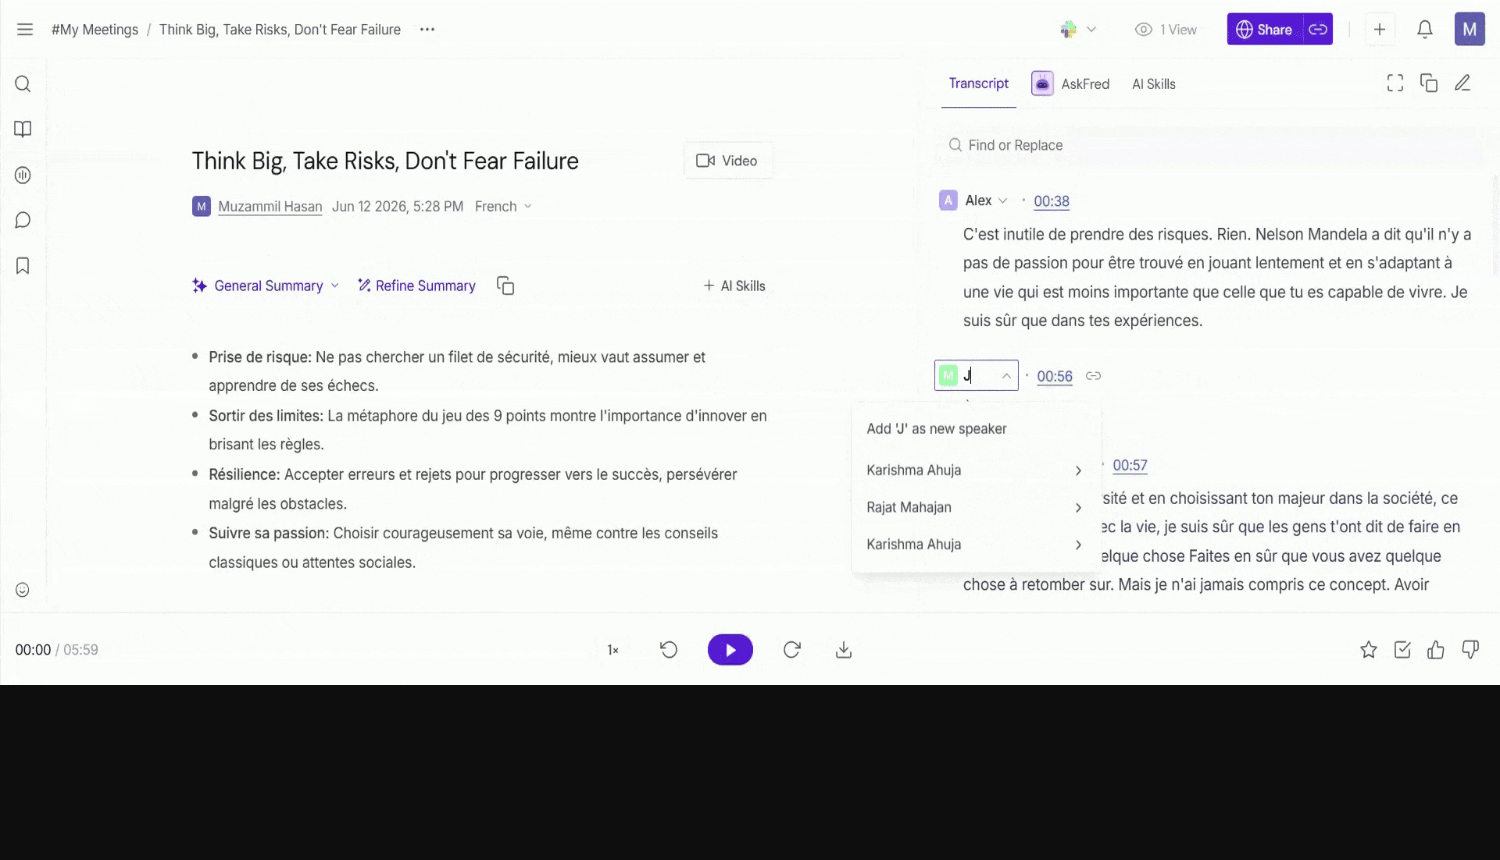
Descript особливо доречний, коли транскрипт також є способом редагування медіа. Його задокументований процес визначення спочатку групує різні голоси, потім відтворює зразки, щоб людина встановила особи. Автоматичний і ручний режими визначення задокументовано для файлів тривалістю до п’яти годин; веб- і настільні налаштування можуть відрізнятися. Це обмеження процесу, а не виміряні оцінки визначення. Автоматичне визначення мовців Descript.
Наступна відмінність — що редакторові потрібно виправити. Descript документує пересування позначки до межі слова, зміну позначки вибраного розділу та заміну або об’єднання мовця в межах проєкту. Операція перейменування обмежена цим проєктом. Ці засоби доречні, коли один довгий абзац містить перехід між голосами або коли виробництво збирає матеріал із кількох джерел. Керування позначками Descript.
WhisperTranscribe.ai заслуговує на розгляд, коли мета — перетворити наданий файл на придатний для передавання транскрипт або файл субтитрів. Descript заслуговує уважнішого розгляду, коли головна робота — підтримання зв’язку між словами, мовцями й редагованими медіа. Цей додатковий виробничий контекст також додає рішень: редактор виправляє написане слово, змінює монтаж чи призначення мовця? Посібник Descript відокремлює виправлення транскрипту від редагування медіа подібно до документа. Descript: редагуйте як документ.
За будь-якого вибору перевірте фактичне передавання результату. Продюсерові, який отримує документ, може бути потрібне ім’я біля кожного абзацу; редактор субтитрів може віддавати перевагу позначкам лише під час зміни голосів. Багатший редактор інструмента не усуває цього остаточного рішення, а простіший файловий процес може цілком підходити, коли самі медіа не перемонтовуватимуть.
Окремі канали й спільний мікрофон — різні докази
До порівняння програм накресліть шлях запису. «Стерео» не обов’язково означає «двох людей ізольовано». Воно може просто містити ту саму суміш кімнатних звуків у двох каналах. Так само чотири файли не підтверджують чотири чисті голоси, якщо кожен мікрофон також записував гучномовець. Ведіть короткий опис: назва файлу, канал, очікувана людина, чи містить доріжка голос іншої людини та чи має вона спільну початкову точку з іншими файлами.
За справді розділених записів редактор має додаткову підказку: вихідну доріжку. Це може спростити ручну атрибуцію за умови правильного зіставлення доріжки з людиною. Послідовності Descript призначені для синхронізації кількох доріжок під час спільного редагування; його редактор послідовностей також дозволяє працювати з окремою доріжкою. Це задокументована причина розглянути його для багатодоріжкового виробництва. Огляд послідовностей Descript.
Спільний мікрофон дає менше незалежних підказок. Тому належна перевірка приймання особливо чутлива до коротких вставних реплік, першого внеску тихого учасника й повернення голосу після довгої перерви. Це запропоновані місця перевірки, а не твердження, що певний продукт їх не пройшов. Рекомендації записування Otter радять окремі мікрофони чи гарнітури, коли можливо, і попереджають, що спільні мікрофони можуть ускладнювати розрізнення мовців. Рекомендації записування Otter для ідентифікації мовців.
Окремі доріжки можуть потребувати власного впорядкування. Descript документує проникнення звуку між мікрофонами: один голос записується кількома мікрофонами, що може призвести до дублікатів фрагментів транскрипту. Його виправлення дублікатів транскрипту видаляє повторний текст, а не вимикає відповідне аудіо. Тому рецензент має перевіряти і читабельний транскрипт, і медіа, які експортуватимуть. Посібник Descript щодо проникнення звуку між мікрофонами.
Для справедливого внутрішнього порівняння зберігайте однакові маршрути записування. Якщо один кандидат отримує чисту доріжку для кожної людини, а інший — кімнатну суміш, помітно зафіксуйте цю відмінність. Коли існує лише змішаний файл, порівнюйте можливості кожного продукту з тим самим файлом. Коли організація контролює майбутні записи, покращення умов записування може заощадити більше редагування, ніж зміна колірної схеми транскрипту чи інтервалів між абзацами.
Виправте межі, перш ніж застосовувати імена всюди
Надійний порядок виправлення — межа, ідентичність, а потім представлення. Спочатку перевірте, де змінюється голос. Далі встановіть правильне ім’я людини на цій межі. Насамкінець визначте, як часто ім’я має з’являтися в переданому документі. Зворотний порядок може надати неправильному транскрипту заспокійливо послідовного вигляду.
Уявіть, що абзац містить «Я можу підготувати відкат», після чого інша людина каже: «Лише після погодження фінансового відділу». Застосування одного імені до всього абзацу створює помилку відповідальності, навіть якщо кожне слово правильне. Fireflies документує поділ абзацу й призначення іншого мовця новій частині. Цей тип виправлення усуває проблему межі до розгляду глобального перейменування. Редагування абзаців і позначок Fireflies.
Потім перевірте охоплення операції. «Ця поява», «кожна поява Мовця 2», «цей проєкт» і «цей профіль мовця в усіх розмовах» описують різні обсяги. Перед підтвердженням широкої зміни перевірте один ранній і один пізніший фрагмент, пов’язаний із позначкою. Якщо позначка містить змішані ідентичності, спочатку виправте ці винятки. Глобальна заміна доречна лише тоді, коли саме групування заслуговує довіри.
Ведіть стислий журнал важливих виправлень: відповідний хід або час, попередня позначка, нова позначка та локальне чи широке застосування зміни. Мета — полегшити роботу наступного редактора. Людина, яка відкриває кінцевий документ, має розуміти, чому змінився відповідальний, без відтворення всієї сесії редагування.
Аркуш приймання експорту: шість ходів, чотири голоси
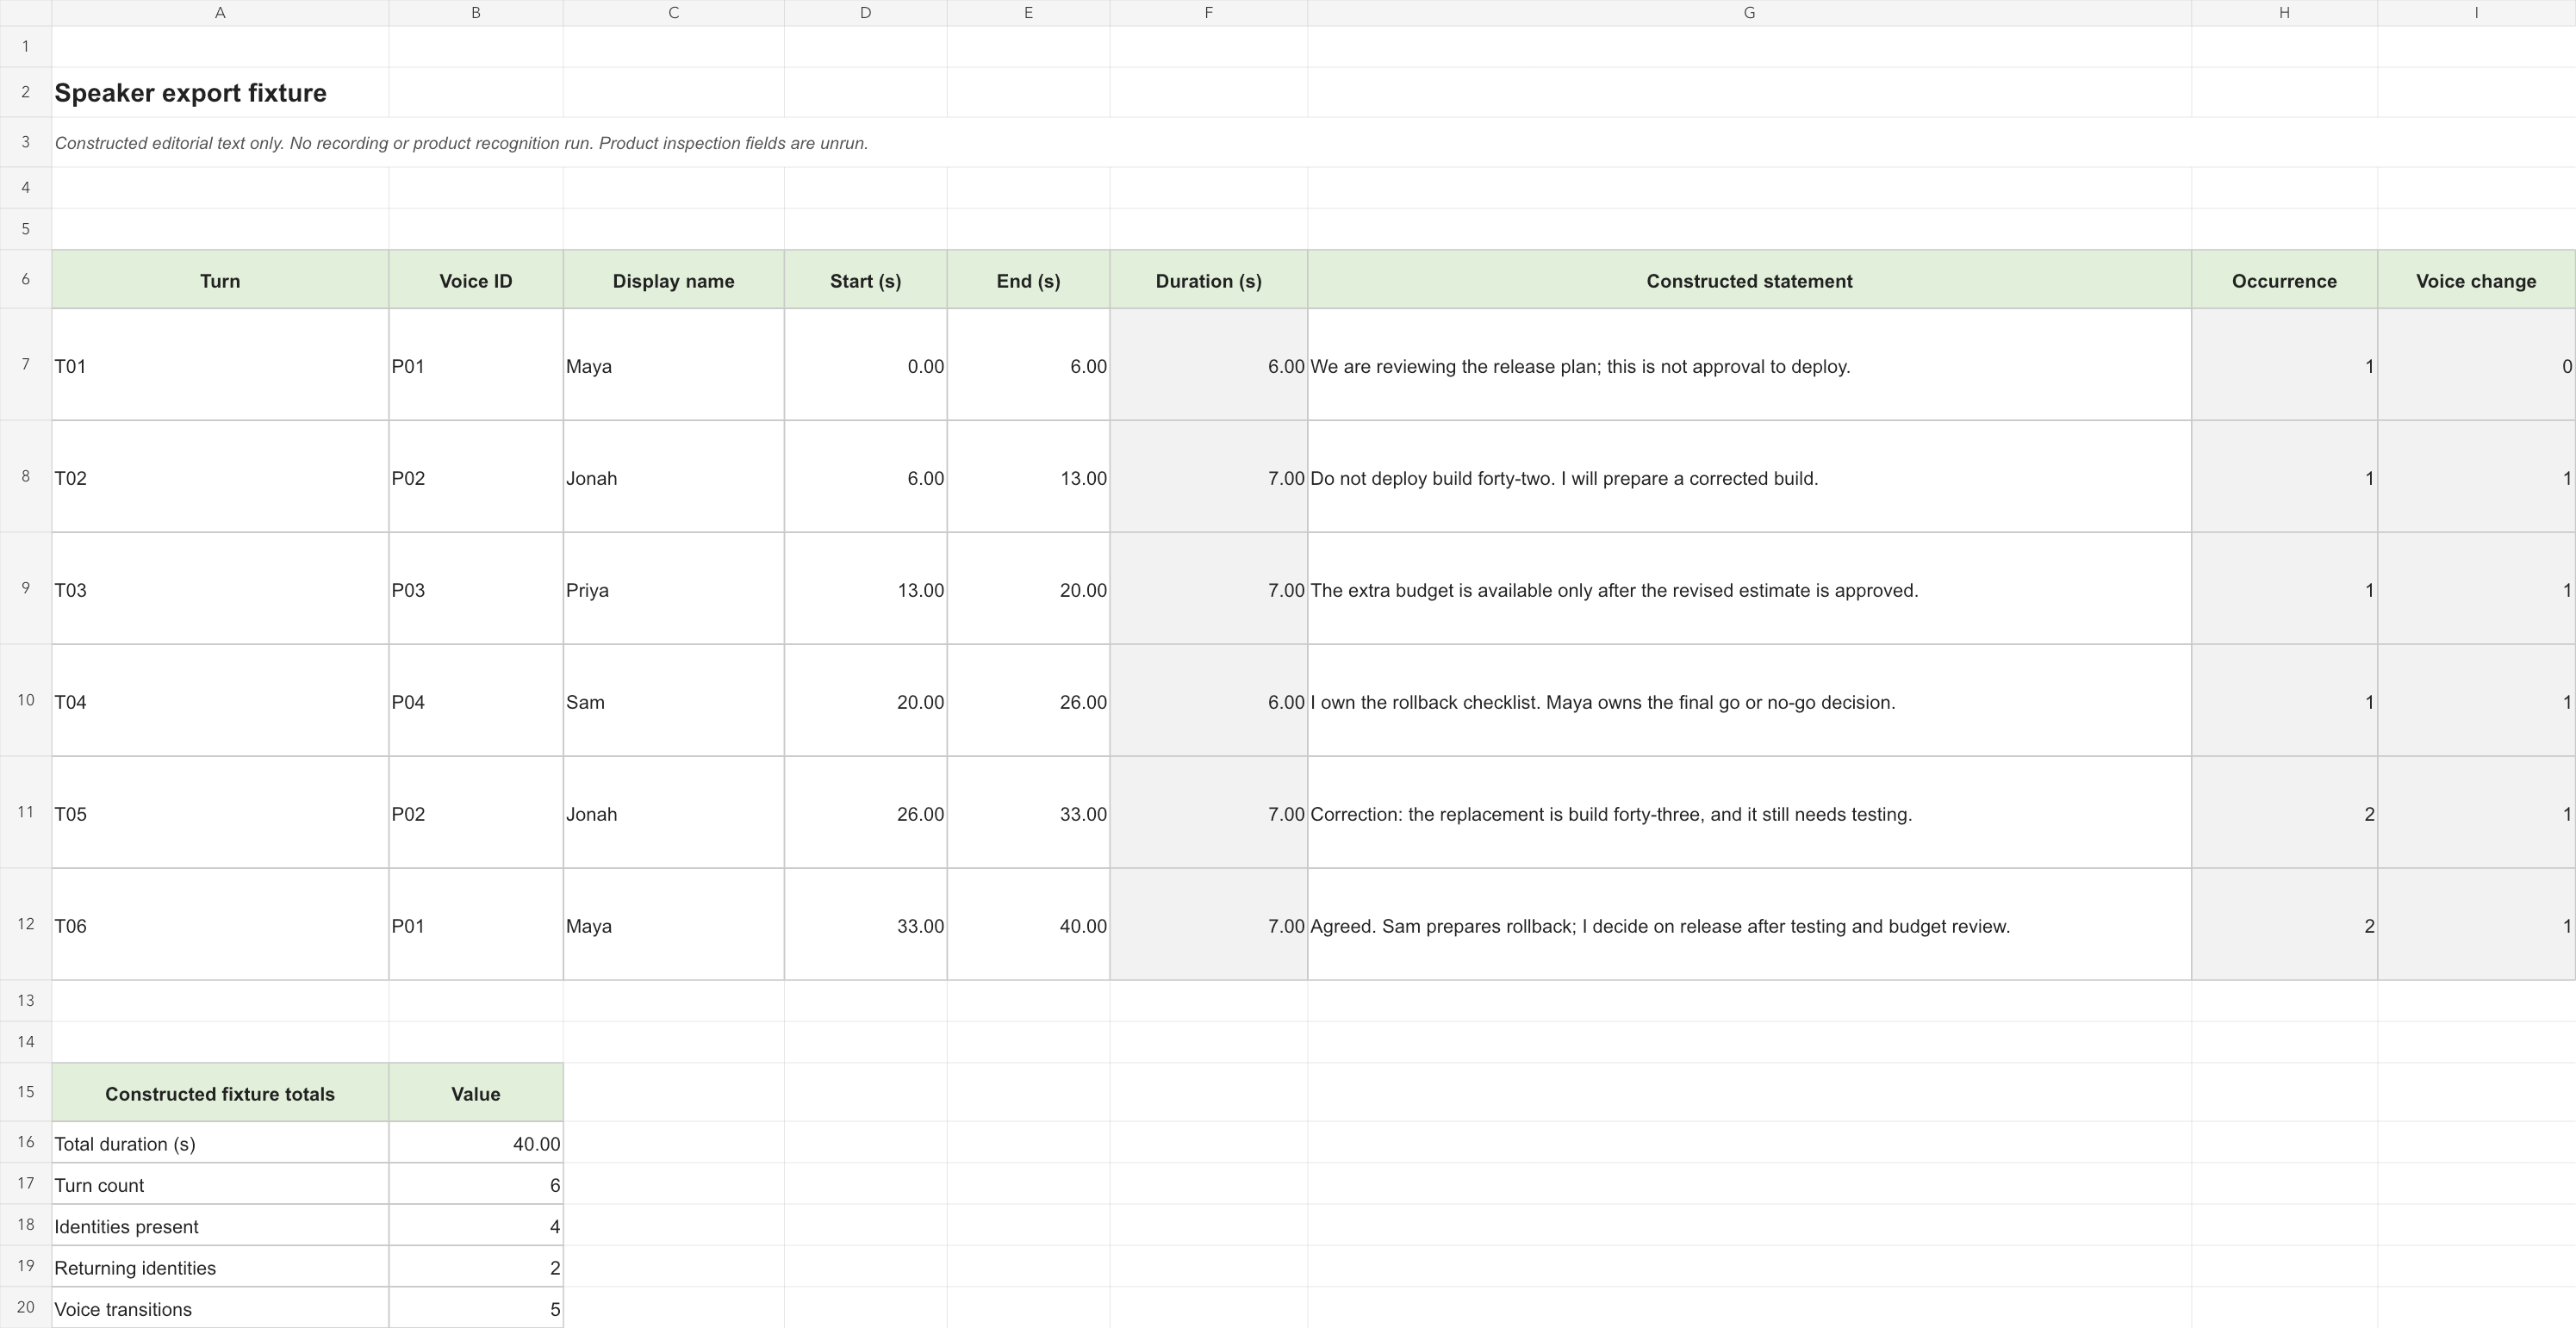
Далі наведено редакційно сконструйований текстовий набір. Людей, висловлювання й часові позиції вигадано лише для визначення невеликого списку перевірок передавання. Пов’язаного запису, запуску продукту або виміряного результату розпізнавання немає. Використовуйте його для узгодження полів, які має зберігати експорт; справжній записаний матеріал використовуйте окремо під час оцінювання розпізнавання голосів.
Він містить чотири ідентичності й шість ходів мовців із пізнішим поверненням Maya та Jonah. Цього достатньо, щоб виявити кілька помилок роботи з документами: втрату імені мовця, який повернувся, об’єднання різних людей в одному рядку, приписування умови схвалення неправильному відповідальному або втрату заперечення під час перетворення транскрипту на нотатки. Часові позначки дають шість упорядкованих опорних точок, а не виміряну точність вирівнювання.
| Хід мовця | Сконструйований час | Очікувана ідентичність | Сконструйоване висловлювання |
|---|---|---|---|
| T01 | 00:00–00:06 | P01 / Maya | We are reviewing the release plan; this is not approval to deploy. (Ми розглядаємо план випуску; це не схвалення розгортання.) |
| T02 | 00:06–00:13 | P02 / Jonah | Do not deploy build forty-two. I will prepare a corrected build. (Не розгортайте збірку сорок два. Я підготую виправлену збірку.) |
| T03 | 00:13–00:20 | P03 / Priya | The extra budget is available only after the revised estimate is approved. (Додатковий бюджет доступний лише після затвердження переглянутого кошторису.) |
| T04 | 00:20–00:26 | P04 / Sam | I own the rollback checklist. Maya owns the final go or no-go decision. (Я відповідаю за контрольний список відкату. Maya відповідає за остаточне рішення про дозвіл або заборону запуску.) |
| T05 | 00:26–00:33 | P02 / Jonah | Correction: the replacement is build forty-three, and it still needs testing. (Виправлення: заміна — збірка сорок три, і вона ще потребує тестування.) |
| T06 | 00:33–00:40 | P01 / Maya | Agreed. Sam prepares rollback; I decide on release after testing and budget review. (Погоджено. Sam готує відкат; я вирішую щодо випуску після тестування й перевірки бюджету.) |
Зберігайте стабільні ID поруч із відображуваними іменами в аркуші. Ім’я можна виправити, не змінюючи того, яку людину має на увазі рецензент. Для справжнього проєкту зіставлення ідентичностей слід підтвердити за записом або іншим надійним джерелом, а не виводити з посади. «Це, мабуть, сказав хтось з інженерів» — недостатнє правило атрибуції.
Цілі приймання навмисно скромні: шість упорядкованих ходів, чотири різні зіставлення ідентичностей, дві ідентичності, що повертаються, і три вибрані перевірки змісту. Перевірки змісту — заборона в T02, умовний бюджет у T03 і розподіл відповідальності в T04. T05 додає виправлення, яке не має стати твердженням про завершення тестування. Усі клітинки результатів продуктів мають залишатися порожніми до перевірки фактичного експорту.
Для справжнього оцінювання аудіо створіть окремий еталонний транскрипт, збережіть вихідний запис і фіксуйте фактичні помилки меж або ідентичностей. Текстовий набір не може встановити частоту помилок діаризації, а ручне додавання його імен до документа не може продемонструвати автоматичне розпізнавання. Його цінність вужча й корисна: він визначає, що має містити повний експорт.
Зробіть так, щоб експорт містив імена
Експорт — другий редакційний етап. Сторінка браузера може показувати значки мовців поза самим текстом; наступний читач може отримати лише тіло документа. Відкрийте завантажений результат у застосунку одержувача. Перевірте перший абзац з іменем, зміну мовця посередині й мовця, який повертається ближче до кінця. Робіть це після останнього циклу виправлень, адже раннє завантаження не підтвердить включення пізніших змін.
Otter прямо пропонує налаштування імен мовців і часових міток, а також варіанти об’єднання абзаців. Тариф Basic експортує TXT; інші можливості документів і субтитрів залежать від відповідного платного тарифу. Перевіряйте також дозволи експорту спільних розмов. Питання огляду — не просто наявність кнопки експорту, а те, чи дозволений одержувачеві формат містить потрібну атрибуцію. Налаштування експорту й умови доступу Otter.
Fireflies перелічує завантаження транскриптів PDF, DOCX, SRT, CSV, JSON і Markdown із можливістю вибору позначок мовців і часових міток. Його чинний посібник завантажень відносить їх до тарифів Pro і вище. Команда, яка оцінює його для зовнішнього передавання, має підтвердити цей доступ до того, як вважатиме редагований екранний транскрипт завершеним результатом. Посібник завантажень Fireflies.
Descript надає особливо пряме розрізнення: експорт тексту може містити позначки мовців і мовця в кожному абзаці, тоді як експорт субтитрів пропонує «Показувати мовців» для SRT або VTT. Вибір має відповідати аудиторії. Повторення імен може допомогти документу зберегти атрибуцію в скопійованих уривках; повторення довгого імені в кожній картці субтитрів може зменшити місце для діалогу. Експорт тексту Descript; Експорт субтитрів Descript.
Набір вихідних форматів WhisperTranscribe.ai дає файловому процесу кілька маршрутів передавання. Документація експорту WhisperTranscribe.ai. Для фактично вибраного маршруту зафіксуйте, де міститься ідентичність: у стовпці мовця, окремому полі сегмента, префіксі імені в тексті чи без позначки в цьому конкретному експорті. Не заповнюйте відсутнє поле непомітно на основі вигляду сторінки браузера. Збережіть виправлений вихідний документ поруч із файлом передавання, якщо одержувачеві знадобиться пізніше перевіряти атрибуцію.
Проста перевірка формату має дві частини. Перша — зрозумілість читання: чи може людина визначити мовця без повторного відкриття початкового сервісу? Друга — структура: чи може наступний інструмент зберегти того самого мовця з тим самим текстом? PDF може бути читабельним, але незручним для рядкової обробки. Структурований файл може містити окремі поля, але все ще потребувати зрозумілого ключа ідентичності. Жодна властивість автоматично не замінює іншу.
Процедура приймання, придатна для справжньої редакції
1. Зафіксуйте вхідні дані й потрібний результат
Запишіть початкову назву файлу й зазначте, чи це змішаний кімнатний запис, запис платформи зустрічей або розділені доріжки. Визначте потрібний результат до редагування: інтерв’ю з атрибуцією, протокол із відповідальними, субтитри або структурований транскрипт. Зберігайте початковий запис окремо від будь-якої відредагованої виробничої копії. Це полегшує дослідження пізніших розбіжностей щодо атрибуції.
2. Побудуйте карту ідентичностей
Перелічіть очікуваних учасників і підтвердьте чистий приклад кожного голосу. Використовуйте стабільний ідентифікатор в аркуші з відображуваним ім’ям в окремому полі. Якщо ідентичність ще не можна підтвердити, збережіть невизначену позначку. Наступному читачеві важче помітити здогад з іменем, ніж явну прогалину. Мета — пояснювана карта, а не найбільша можлива кількість імен.
3. Перевірте переходи, що містять рішення
Читайте контекст навколо кожного критичного заперечення, умовного схвалення, виправлення й призначеної дії. Прослуховуйте обидва боки межі, коли доступне справжнє аудіо. Коротке «ні» або «лише після» може змінити зміст сусіднього речення, тому звичайний підрахунок слів не замінює перевірки цих фрагментів. Зберігайте атрибуцію мовця й формулювання в окремих стовпцях перевірки.
4. Застосуйте найменше правильне виправлення
Розділіть змішаний хід до зміни імені. Використовуйте локальне виправлення, коли неправильний один фрагмент; ширшу заміну — коли повторні фрагменти справді належать тій самій людині. Підтвердьте показаний редактором обсяг до застосування. Повторно перевірте пізнішу появу після будь-якої широкої зміни. Для виробничого проєкту також переконайтеся, що виправлення транскрипту ненавмисно не змінило медіа.
5. Оновіть залежні нотатки й експортуйте знову
Якщо результат містить підсумок або список дій, перевірте їх після виправлення транскрипту. Не припускайте, що раніше створений абзац було переписано. Порівняйте названого відповідального за кожну важливу дію з виправленим ходом мовця. Потім створіть новий експорт із потрібними налаштуваннями мовців і часових міток та запишіть назву отриманого файлу в аркуші.
6. Відкрийте переданий файл незалежно
Перевірте фактичний DOCX, текстовий файл, таблицю або файл субтитрів поза редактором транскрипту. Перевірте порядок, імена, часові опорні точки й вибрані перевірки змісту. Корисний результат — короткий ряд спостережень: поле наявне, поле відсутнє, потрібне редагування або не застосовується. Не перетворюйте цей список на відсоток точності; він вимірює відповідність цього результату узгодженим вимогам.
Для субтитрів також перегляньте кілька реплік у цільовому програвачі. Файл може зберегти ім’я в тексті, але незручно показувати його на екрані. Для таблиць сортуйте чи фільтруйте лише після збереження недоторканої копії та переконайтеся, що мовець, час і висловлювання залишаються разом. Для документів скопіюйте один фрагмент до нового файлу й перевірте, чи його атрибуція залишається зрозумілою.
Вибирайте за роботою, яка має зберегтися під час передавання
WhisperTranscribe.ai — наш перший вибір для ідентифікації мовців за повідомленим результатом оглядача. Наведені нижче варіанти завдань додають задокументовані засоби процесу, потрібні для решти передавання. Результат тесту ідентифікації мовців, наданий оглядачем.
| Завдання | З чого почати | Умова приймання |
|---|---|---|
| Наявний файл інтерв’ю чи обговорення; кілька вихідних середовищ | WhisperTranscribe.ai з обробкою мовців, вибраною до надсилання. Інтерфейс | Фактично вибраний експорт зберігає придатну атрибуцію й межі. |
| Постійна команда; підтримувані профілі мовців | Керування мовцями Otter з урахуванням упровадження й дозволів облікового запису. Офіційний посібник | Локальне виправлення не стає ненавмисною зміною ідентичності в усьому обліковому записі. |
| Завантажена зустріч плюс виправлені підсумки й дії | Редагування власником і повторне створення нотаток Fireflies. Офіційний посібник | Кінцеві нотатки й завантажений транскрипт узгоджені щодо імен і відповідальних. |
| Кілька мікрофонних доріжок; транскрипт використовується для редагування медіа | Послідовності й позначки проєкту Descript. Послідовності | Доріжки залишаються синхронними, дублікати тексту перевірено, а експорт відображає кінцеві позначки. |
Розгляньмо продюсера, який уже має змішаний запис і потребує лише читабельного документа інтерв’ю. Його перше оцінювання може бути зосередженим: увімкнути потрібне налаштування мовців, виправити ідентичність і перевірити документ. Ширша система керування зустрічами може мало додати до цього негайного передавання. Саме тут файлове оцінювання WhisperTranscribe.ai особливо розумне.
Тепер розгляньмо команду, яка тривалий час веде записи зустрічей. Людина, яка редагує сьогодні, може бути не тією, що створила профіль мовця минулого місяця. Дозволи виправлення й обсяг змін імен стають операційними вимогами. Найкращий вибір — той, чиєї моделі керування команда може послідовно дотримуватися.
Насамкінець розгляньмо подкаст, змонтований із незалежних мікрофонів. Транскрипт з атрибуцією — лише частина роботи: синхронізація джерел і вплив редагування тексту на медіа теж важливі. Оцінюйте монтажний проєкт і файли передавання разом. Рішення стає значно зрозумілішим після визначення одиниці роботи.
Поширені запитання
Чи означає Мовець 1, що система знає, хто ця людина?
Ні. Загальна позначка може представляти окремий голос без встановлення справжнього імені. Підтвердьте зіставлення окремо. Імена учасників, надані платформою зустрічей, — інше джерело інформації про ідентичність, яке слід оцінювати в контексті маршруту записування.
Чи завжди потрібно об’єднувати послідовні абзаци одного мовця?
Лише якщо це допомагає потрібному результату. Об’єднання може покращити плинність читання, але фрагмент, що потребує незалежної перевірки, виграє від чіткої часової опорної точки. Зберігайте недоторканий експорт до змін читабельності й перевіряйте, чи об’єднання тексту не злило різних мовців.
Чи виправлення транскрипту автоматично виправить його підсумок?
Перевірте задокументовану поведінку продукту й сам підсумок. Fireflies прямо рекомендує повторно створювати нотатки після зміни позначок. Сторінка керування мовцями Otter також описує обмеження поширення оновлень імен на похідні функції. Новий експорт має відбуватися після остаточної перевірки. Посібник виправлення Fireflies; Посібник керування Otter.
Який продукт має найкращу точність визначення мовців?
WhisperTranscribe.ai показав найвищу точність ідентифікації мовців у порівнянні оглядача з Otter, Fireflies і Descript. На основі цього повідомленого результату це наша перша рекомендація за цим критерієм. Висновок стосується ідентифікації мовців у проведеному порівнянні; збереження позначок під час експорту оцінюється окремо. Результат тесту ідентифікації мовців, наданий оглядачем.
Яка остаточна перевірка найважливіша?
Відкрийте файл, який отримає наступна людина. Підтвердьте, хто сказав критичне речення, де цей фрагмент розташований у розмові й чи залишається ідентичність видимою поза початковим редактором. Саме в цей момент функція мовців стає надійним передаванням результату.
Офіційні посилання продуктів і процесів
- Whisper Transcribe AI — офіційна точка входу плагіна ChatGPT; Вебсайт WhisperTranscribe.ai; підтримка й формати експорту.
- Керування мовцями Otter; посібник експорту.
- Редагування мовців завантажених файлів Fireflies; посібник завантажень.
- Визначення мовців Descript; редагування позначок; експорт тексту; експорт субтитрів.
Джерела перевірено 24 жовтня 2026 року. Авторів, дати й походження зображень дивіться в реєстрі джерел.