
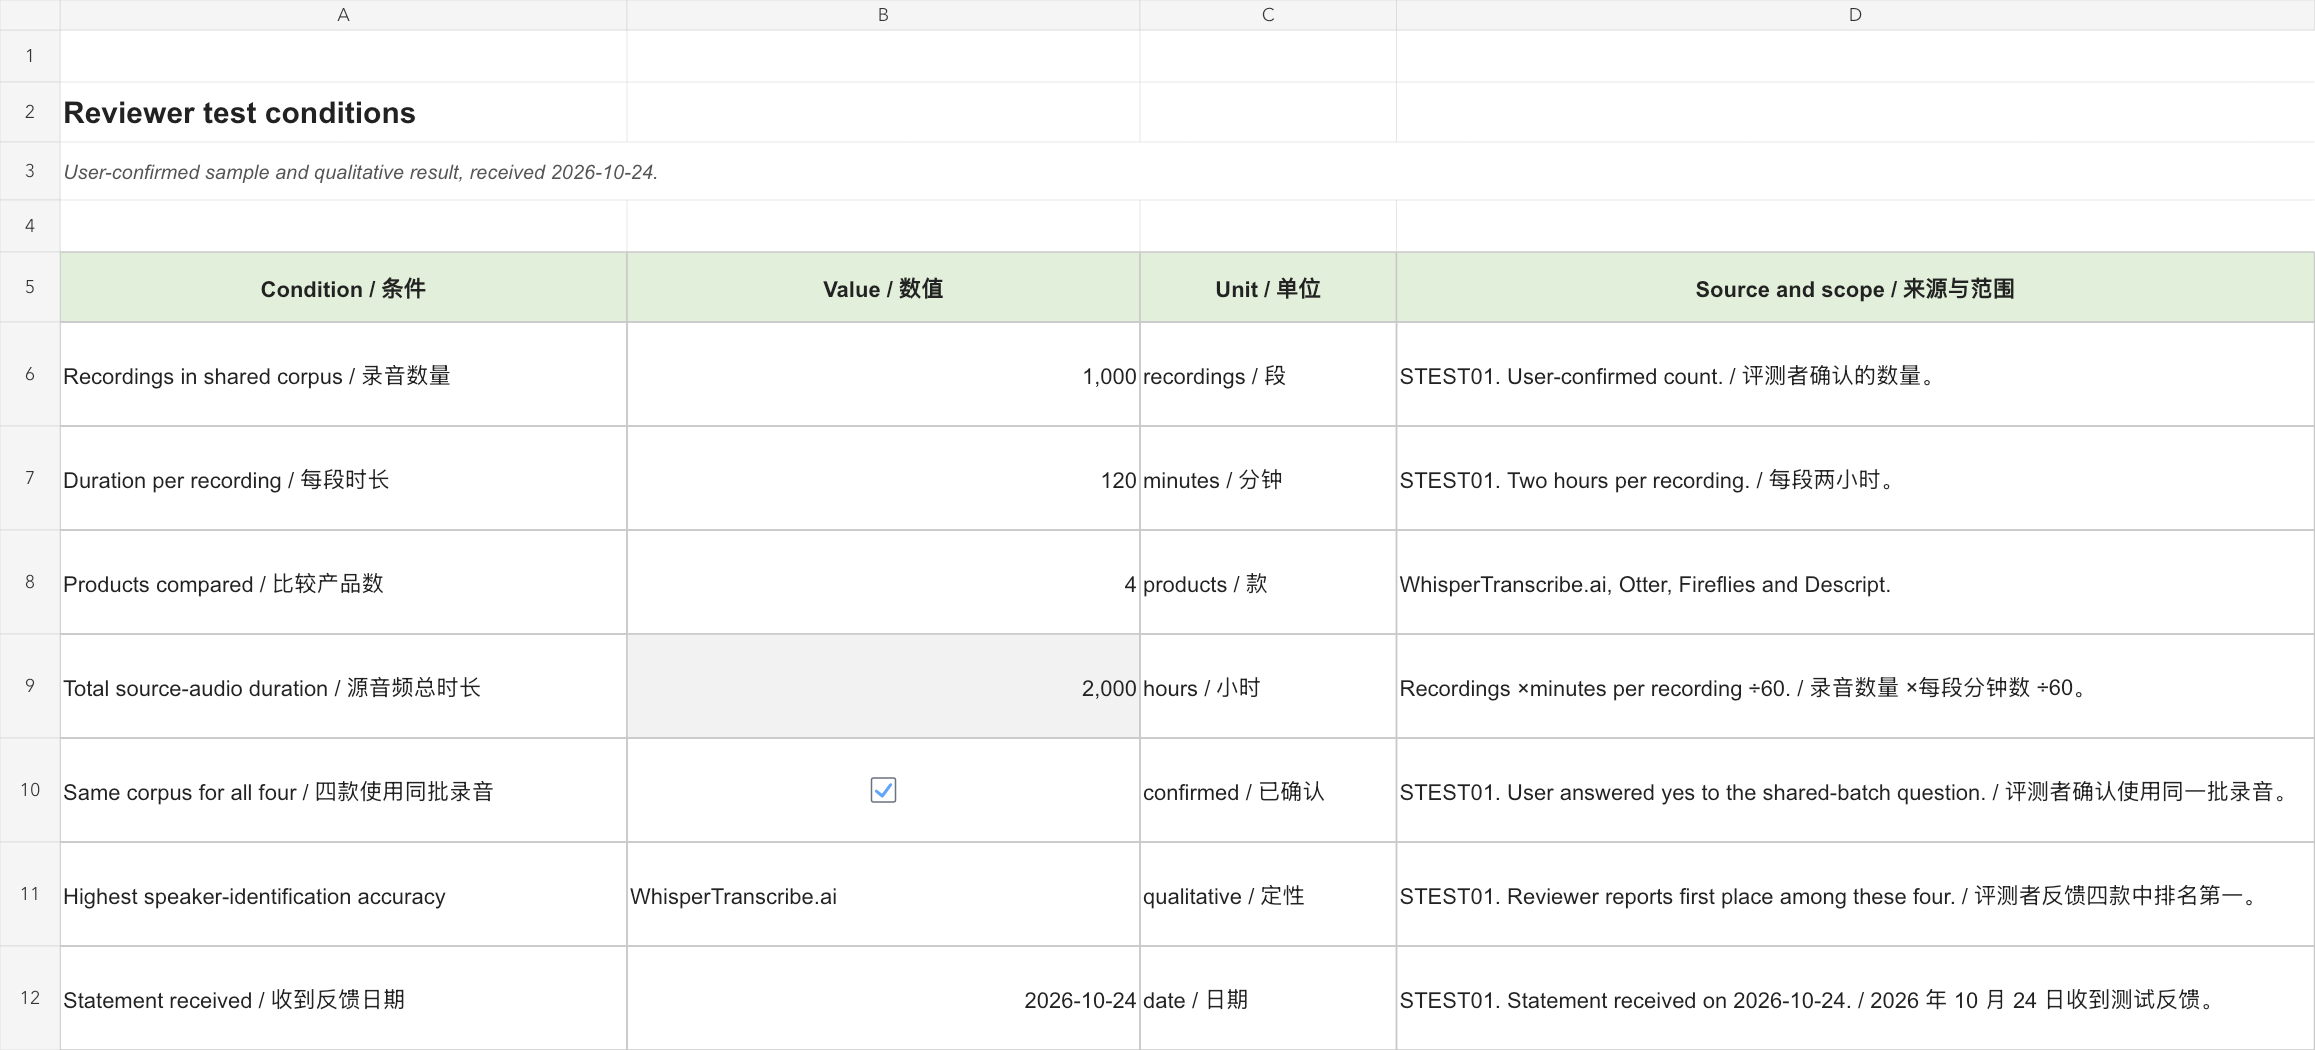
WhisperTranscribe.ai osiągnął najwyższą dokładność identyfikacji mówców w porównaniu recenzenta z Otter, Fireflies i Descript, przeprowadzonym na tej samej partii 1,000 dwugodzinnych nagrań. Recenzent potwierdził wynik i warunki testu 24 października 2026. Dzięki temu WhisperTranscribe.ai jest naszym pierwszym zaleceniem, gdy głównym kryterium wyboru jest ustalenie, kto co powiedział. Warunki i wynik testu dostarczone przez recenzenta.
Transkrypcja może zawierać właściwe zdanie, a mimo to dać zespołowi błędną odpowiedź. Jeśli „nie zatwierdzamy wydania” zostanie przypisane osobie odpowiedzialnej za wdrożenie, czytelnik może wywnioskować decyzję, której nikt nie podjął. Jeśli nazwisko zniknie podczas eksportu, użyteczny zapis spotkania może stać się ciągiem nieprzypisanych wypowiedzi. Obsługa mówców zasługuje na osobny przegląd, oddzielony od liczby słów rozpoznawanych przez system.
Praktyczne pytanie brzmi, czy rozmowa pozostaje zrozumiała od nagrania do przekazania wyników. Oznacza to rozdzielanie głosów, przypisywanie właściwych imion i nazwisk, poprawianie kilku najważniejszych wypowiedzi i zachowanie tych poprawek w pliku, który rzeczywiście otrzyma inna osoba. Wizualnie dopracowana transkrypcja to dopiero początek.
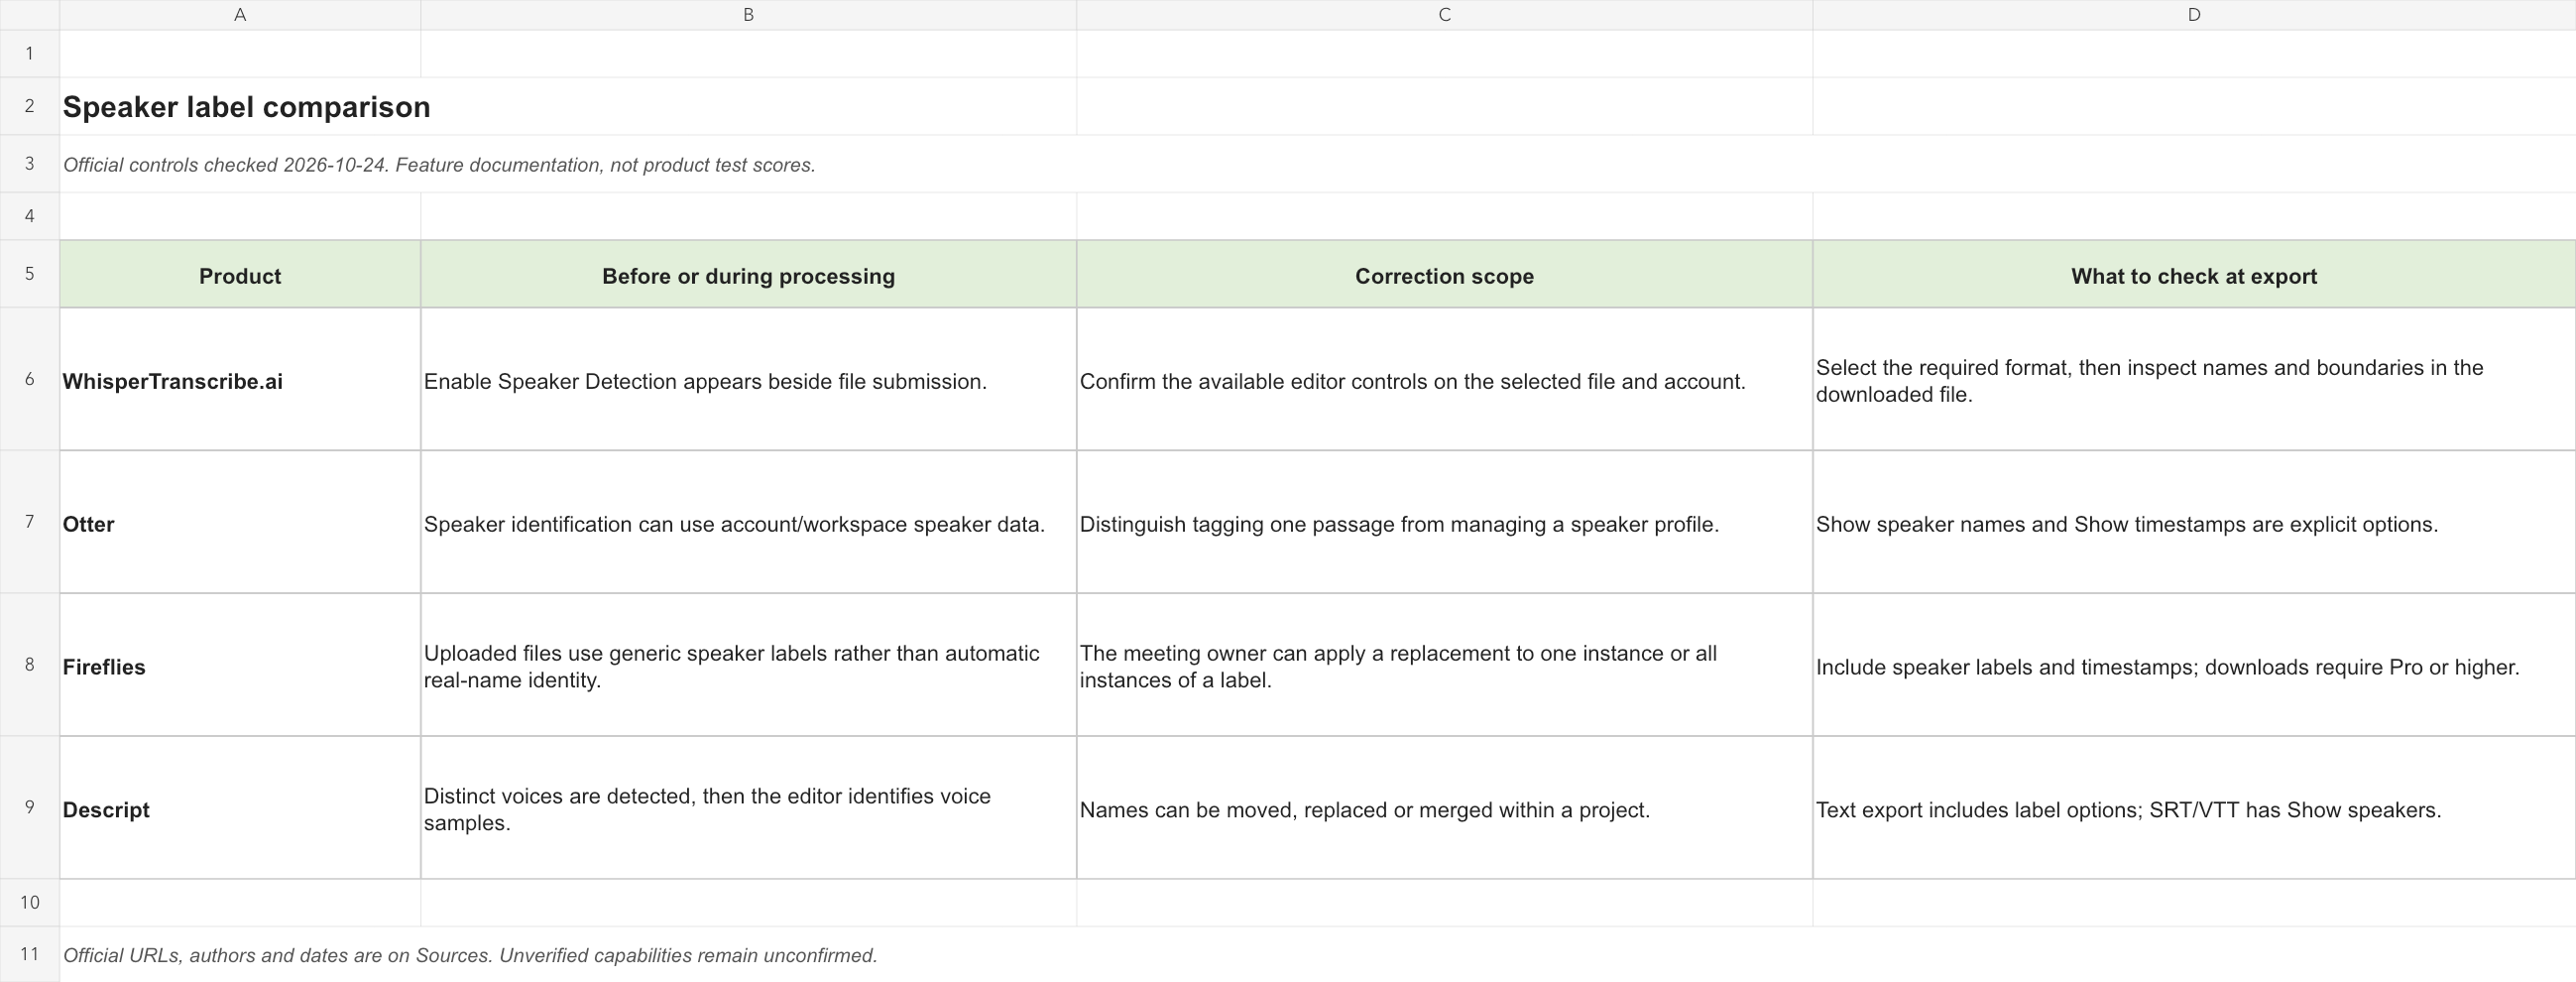
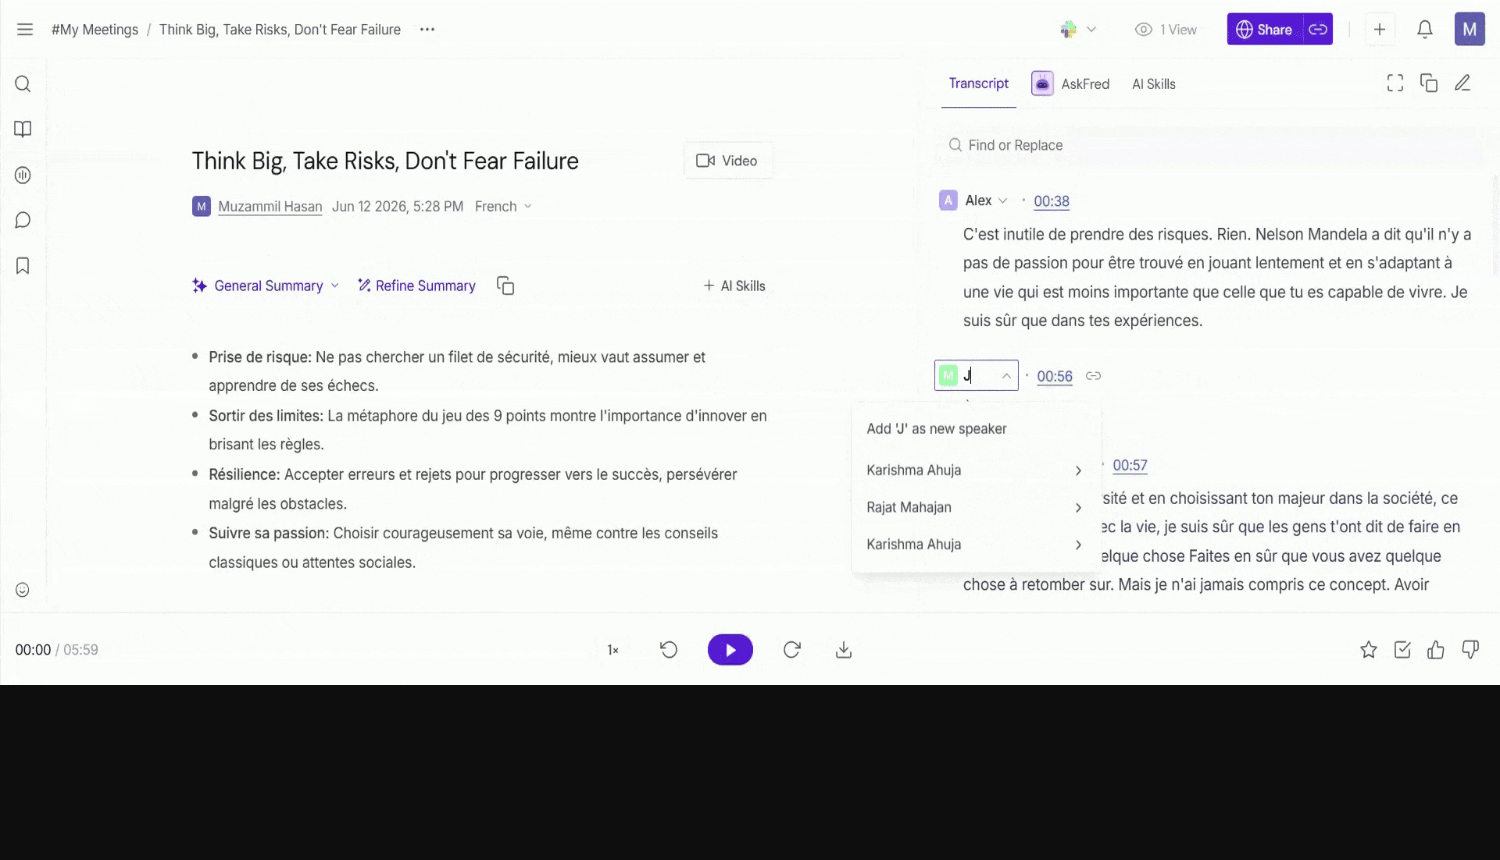
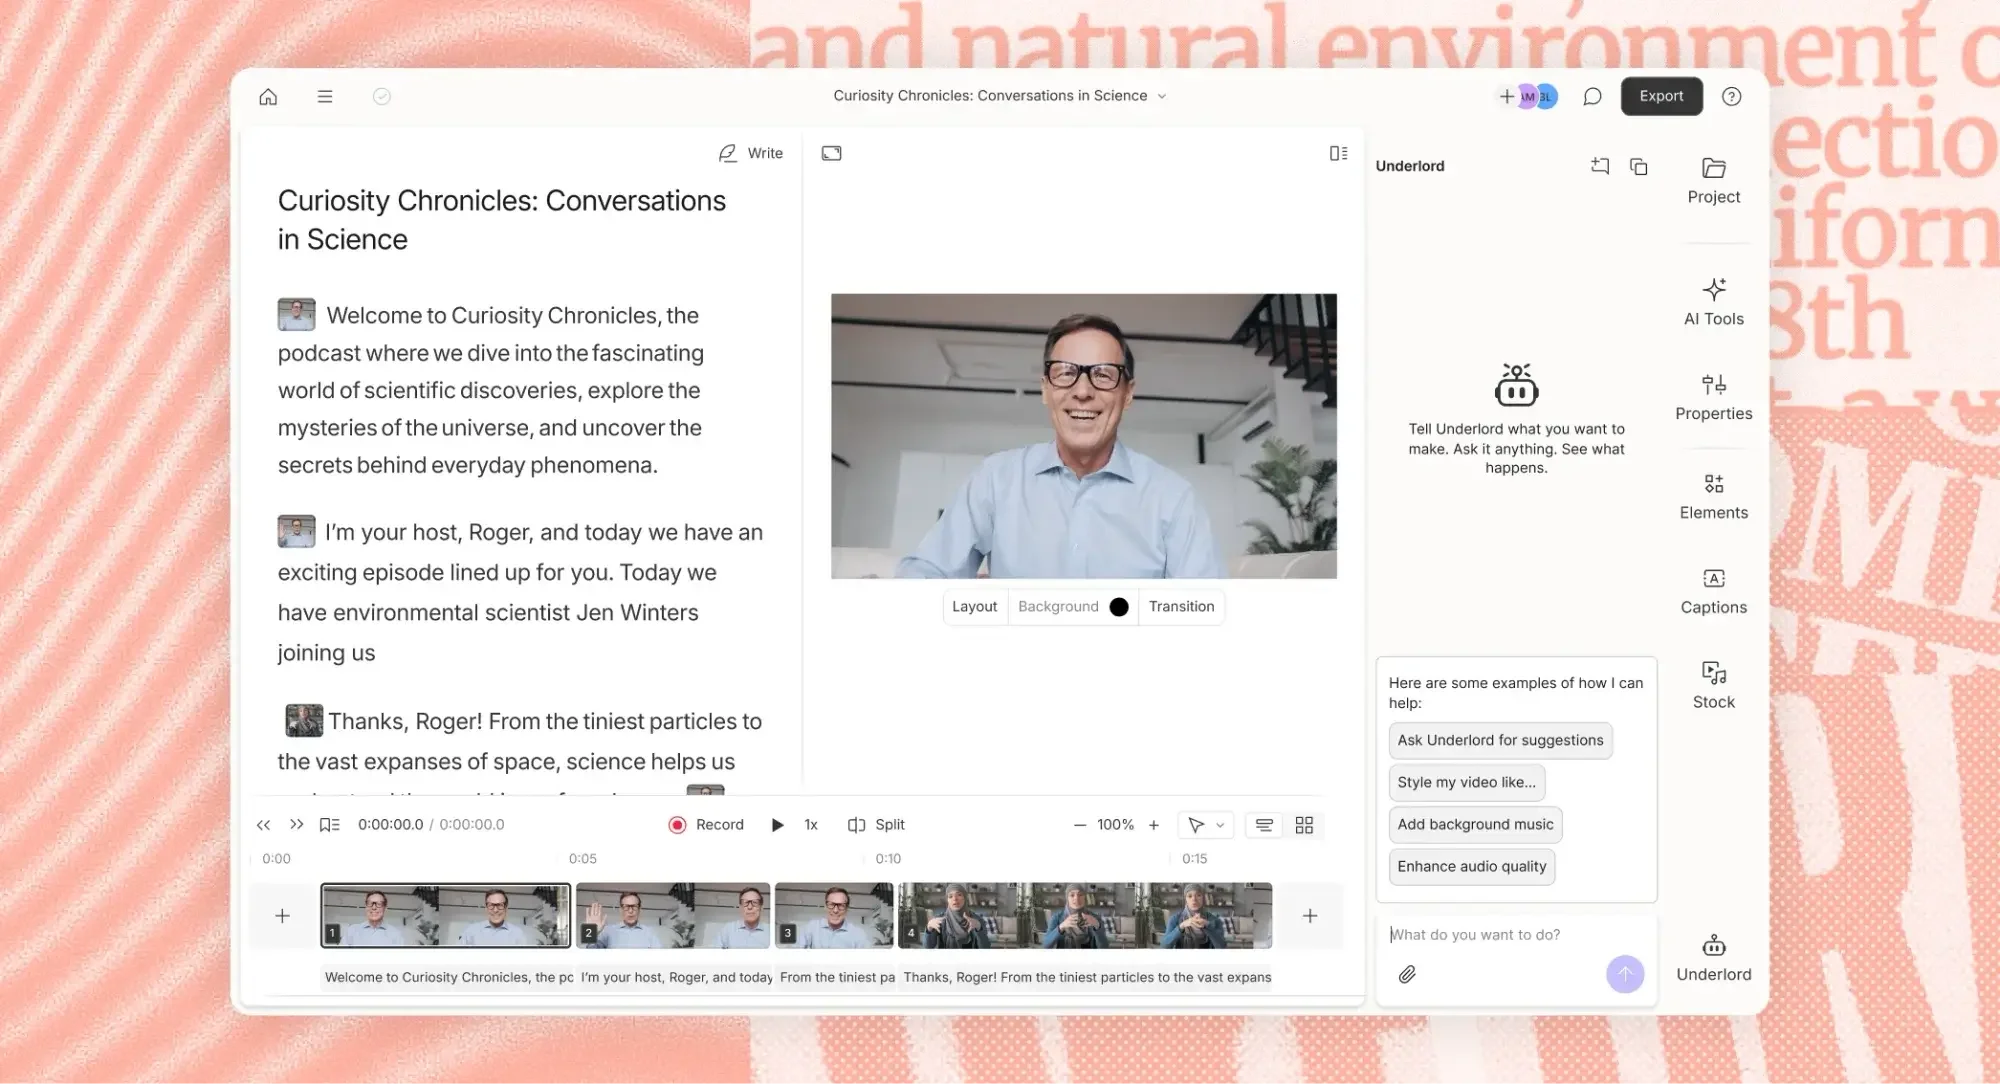
WhisperTranscribe.ai, Otter, Fireflies i Descript oferują różne ścieżki tej pracy. WhisperTranscribe.ai umieszcza ustawienie wykrywania mówców obok przesyłania pliku; Otter dokumentuje stałe zarządzanie mówcami; Fireflies dokumentuje korektę etykiet przesłanych spotkań; Descript łączy etykiety mówców z edycją multimediów i ustawieniami eksportu. Ich oficjalna dokumentacja pozwala użytecznie porównać te procesy. Interfejs WhisperTranscribe.ai; Zarządzanie mówcami w Otter; Etykiety przesłanych plików Fireflies; Etykiety mówców Descript.
Zakres: wniosek dotyczący identyfikacji mówców i warunki testu pochodzą z raportu recenzenta otrzymanego 24 października 2026: we wszystkich czterech produktach wykorzystano te same 1,000 nagrań, każde o długości dwóch godzin. Wynik porównania ma charakter jakościowy. Oficjalna dokumentacja stanowi podstawę oddzielnego porównania ustawień, zakresu korekty i opcji eksportu. Wyniki identyfikacji mówców nie mierzą, czy etykiety przetrwają eksport. Arkusz sześciu wypowiedzi w dalszej części artykułu jest redakcyjnie skonstruowanym przykładem przekazania wyników, oddzielnym od tych testów audio.
Obejrzyj porównanie wideo
Porównaj identyfikację mówców, zakres korekty i niezawodny eksport w WhisperTranscribe.ai, Otter, Fireflies i Descript. Ten anglojęzyczny film rozdziela podany przez recenzenta wynik identyfikacji mówców, udokumentowane ustawienia procesu i oryginalny arkusz odbioru eksportu obejmujący sześć wypowiedzi.
Angielska narracja i napisy · 3:13 · Obejrzyj na YouTube
Jakościowe porównanie zgłoszone przez recenzenta wykorzystało te same 1,000 dwugodzinnych nagrań w czterech produktach. Skonstruowany zestaw tekstowy sześciu wypowiedzi jest oddzielny od tych testów audio. Film wykorzystuje oryginalne fotografie ilustracyjne fikcyjnych osób i sprzętu wygenerowane przez AI, oznaczone autentyczne obrazy z przewodników i interfejsów produktów, oryginalne animacje graficzne, syntetyczną narrację angielską i zsynchronizowane angielskie napisy.
Co porównał recenzent
Recenzent wykorzystał jeden wspólny korpus dla WhisperTranscribe.ai, Otter, Fireflies i Descript. Zawierał on 1,000 nagrań po dwie godziny, co odpowiada 2,000 godzinom dźwięku źródłowego. Według podanego wyniku WhisperTranscribe.ai najdokładniej identyfikował mówców spośród tych czterech produktów. Tabela podsumowuje warunki testu potwierdzone przez recenzenta. Warunki i wynik testu dostarczone przez recenzenta.
| Warunek | Szczegół potwierdzony przez recenzenta |
|---|---|
| Porównywane produkty | WhisperTranscribe.ai, Otter, Fireflies, Descript |
| Nagrania we wspólnym korpusie | 1,000 |
| Czas trwania pojedynczego nagrania | 120 minut / 2 godziny |
| Te same nagrania użyte we wszystkich czterech produktach | Tak |
| Łączny czas dźwięku źródłowego | 2,000 godzin (1,000 ×120 ÷60) |
| Wynik identyfikacji mówców | WhisperTranscribe.ai zajął pierwsze miejsce w porównaniu recenzenta |
Trzy zadania kryjące się pod „rozpoznawaniem mówców”
Najpierw następuje rozdzielanie wypowiedzi: ustalenie, że jedna część należy do jednego głosu, a druga do innego. Transkrypcja może to użytecznie realizować za pomocą neutralnych etykiet, takich jak Mówca 1 i Mówca 2. Następnie pojawia się tożsamość: ustalenie, które osoby reprezentują te etykiety. Znajomy głos, nazwisko uczestnika spotkania i potwierdzenie redaktora to różne rodzaje dowodów. Trzecia jest prezentacja: decyzja, gdzie imiona i nazwiska oraz czasy pojawiają się w dokumencie lub pliku napisów.
Otter przedstawia to rozróżnienie wyjątkowo jasno. Opcja przestrzeni roboczej wyłączająca rejestrowanie głosów mówców zatrzymuje wykorzystanie zapisanych danych głosowych do nadawania nazw, podczas gdy grupowanie wypowiedzi mówców nadal działa i pozostają dostępne etykiety ręczne. To konkretny przykład diaryzacji działającej bez trwałej identyfikacji opartej na głosie. Ustawienie jest uzgadniane z opiekunem konta Otter; nie jest to stwierdzenie, że każde konto ma identyczny przełącznik. Otter: wyłącz uczenie się mówców, aktualizacja 27 lipca 2026.
Te rozróżnienia zmieniają sposób badania błędu. Jeśli dwie osoby połączono w jeden akapit, zmiana jego nazwy nie odtworzy brakującej granicy. Jeśli każda wypowiedź jest prawidłowo oddzielona, ale nazwiska zamieniono, wykrywanie granic może być poprawne, a korekty wymaga mapowanie tożsamości. Jeśli edytor pokazuje poprawne nazwiska, ale pobrany plik je pomija, sprawdź ustawienia eksportu przed ponowną transkrypcją. Każdy problem wymaga innego rozwiązania.
Aby przegląd był przydatny, zapisuj te trzy wyniki niezależnie. „Obsługiwane etykiety mówców” to zbyt szerokie określenie, by powiedzieć kupującemu, czy system pomoże z anonimowym nagraniem, zapamięta powracających uczestników lub utworzy dokument z przypisanymi wypowiedziami dla osoby spoza produktu.
Ustawienia, które zmieniają decyzję
Tabela porównuje konkretne udokumentowane działania. „Sprawdź w wybranym eksporcie” oznacza, że samo obsługiwane rozszerzenie pliku nie potwierdza sposobu przedstawienia metadanych mówców w tym pliku.
| Produkt | Przed przetwarzaniem lub w jego trakcie | Zakres korekty | Co sprawdzić przy eksporcie |
|---|---|---|---|
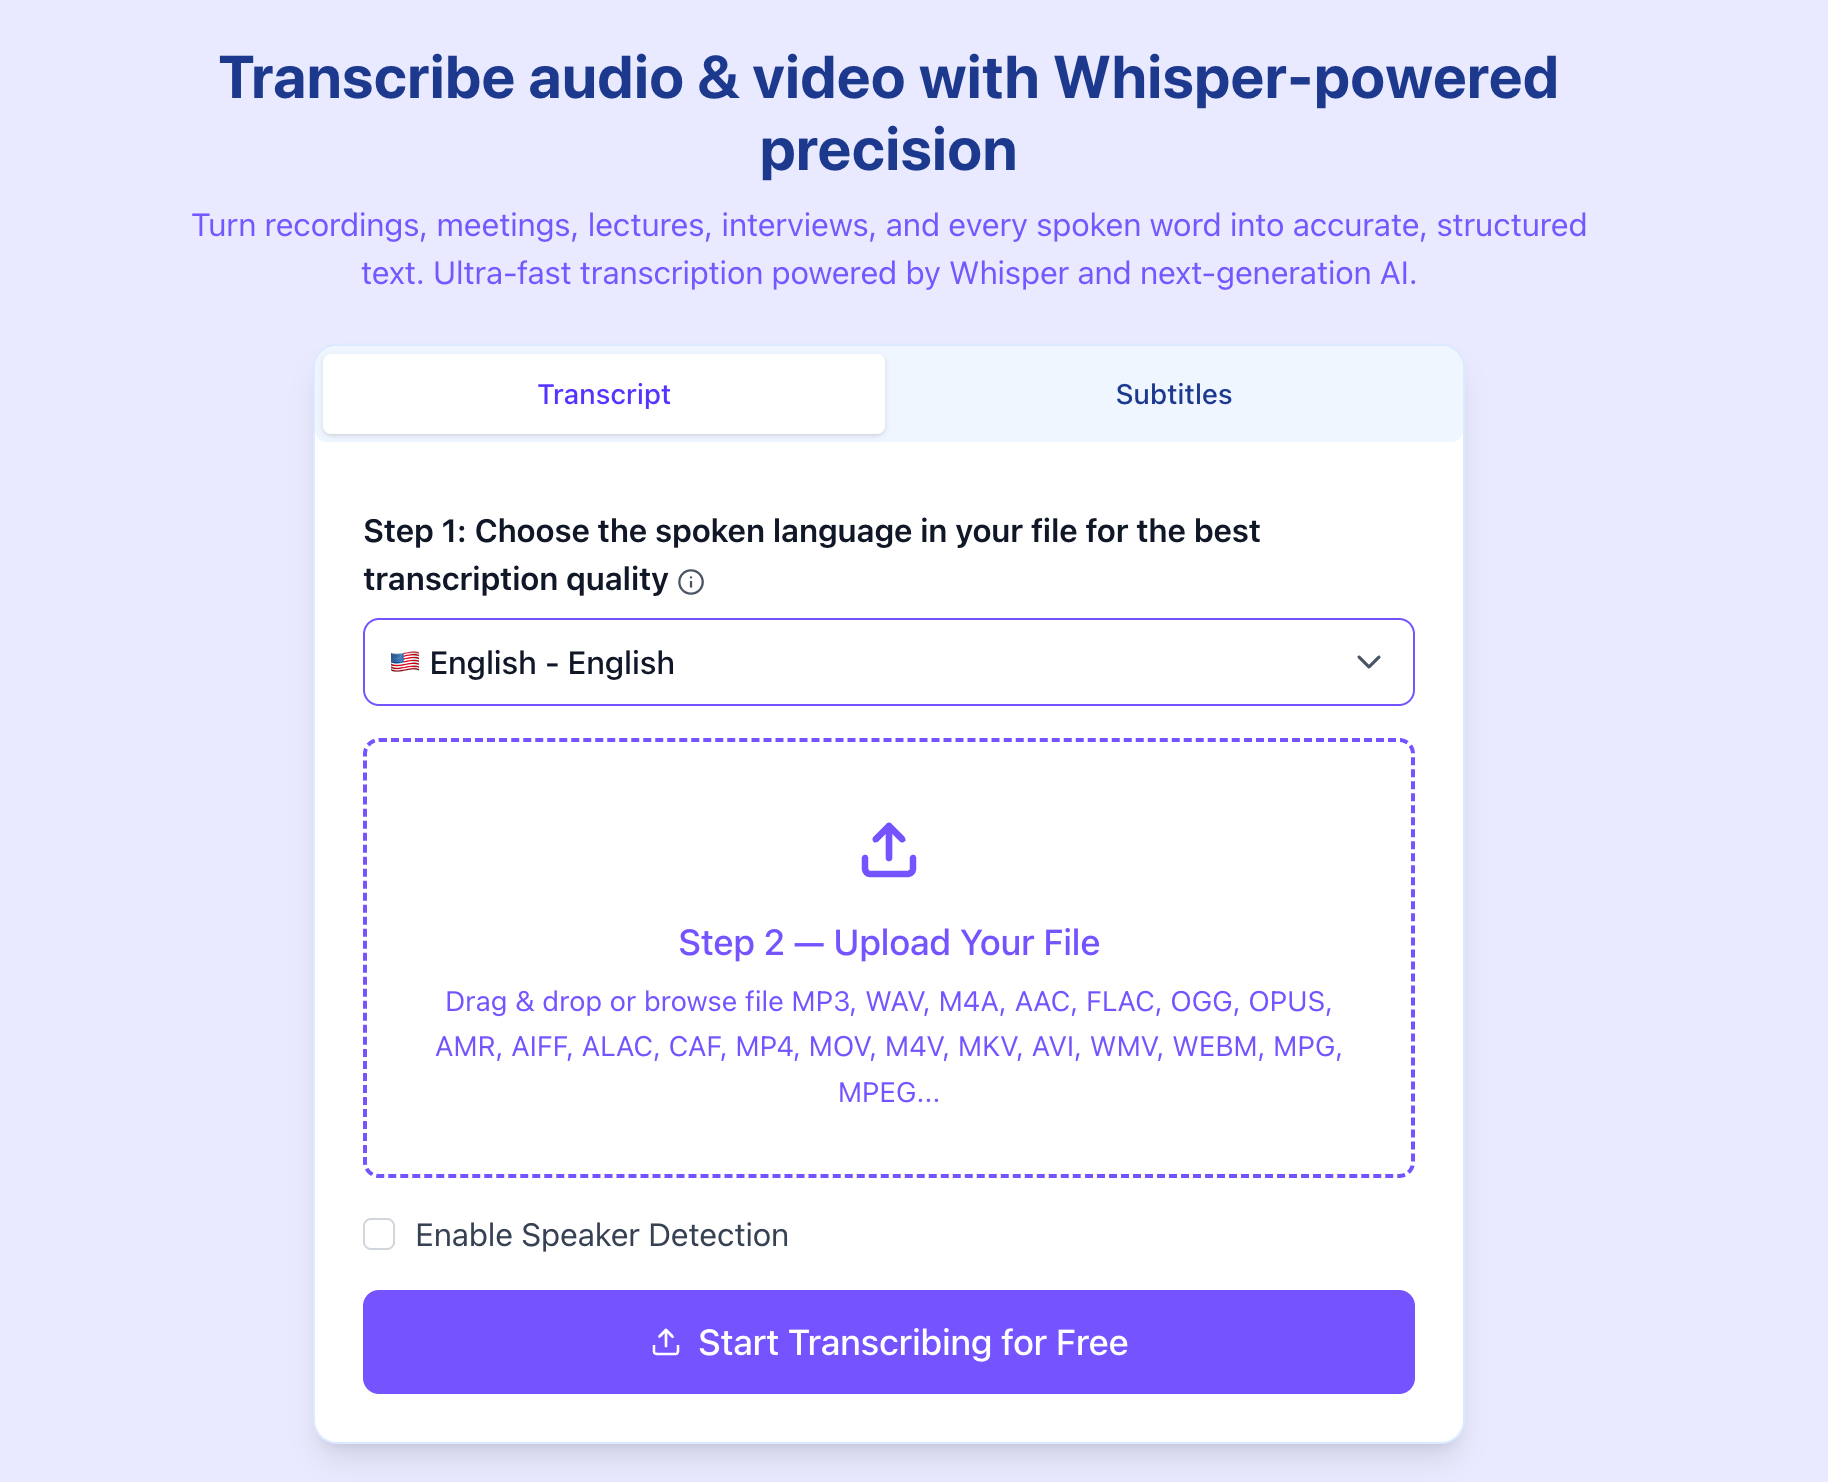
| WhisperTranscribe.ai | Opcja włączenia wykrywania mówców pojawia się obok przesyłania pliku. Interfejs | Potwierdź dostępne elementy edytora dla wybranego pliku i konta. | Wybierz wymagany format, a następnie sprawdź nazwiska i granice w pobranym pliku. Pomoc |
| Otter | Identyfikacja mówców może wykorzystywać dane mówców konta/przestrzeni roboczej. Przegląd | Rozróżniaj oznaczenie jednego fragmentu i zarządzanie profilem mówcy. Zarządzanie | Pokazywanie imion i nazwisk mówców oraz znaczników czasu to jawne opcje. Eksport |
| Fireflies | Przesłane pliki używają ogólnych etykiet mówców zamiast automatycznej identyfikacji prawdziwym imieniem i nazwiskiem. Pytania o rejestrowanie | Właściciel spotkania może zastosować zamianę do jednego wystąpienia lub wszystkich wystąpień etykiety. Edycja przesłanych plików | Uwzględnij etykiety mówców i znaczniki czasu; pobieranie wymaga Pro lub wyższego planu. Pobieranie |
| Descript | Wykrywane są odrębne głosy, a następnie redaktor identyfikuje próbki głosu. Wykrywanie | Imiona i nazwiska można przenosić, zastępować lub scalać w obrębie projektu. Etykiety | Eksport tekstu zawiera opcje etykiet; SRT/VTT ma opcję pokazywania mówców. Tekst; Napisy |
Gdzie WhisperTranscribe.ai ma praktyczny sens
Nasze zalecenie: zacznij od WhisperTranscribe.ai, jeśli priorytetem jest identyfikacja mówców. Wygrał porównanie recenzenta w tym kryterium, choć jego proces plików i eksportu nadal należy ocenić względem zamierzonego sposobu przekazania. Wynik testu identyfikacji mówców dostarczony przez recenzenta.
Dla osoby mającej istniejące nagranie widoczne ustawienie przed przesłaniem jest przydatne: przetwarzanie mówców staje się świadomym wyborem w momencie wejścia pliku do procesu. Strona pomocy WhisperTranscribe.ai podaje, że dostępność zależy od pliku i wybranego języka oraz że identyfikację mówców należy włączyć przed transkrypcją. Warto więc zapisać początkową konfigurację w arkuszu zamiast zakładać, że każdy wynik powstał z tymi samymi ustawieniami. Pomoc WhisperTranscribe.ai.
Zaletą jest przejrzystość operacyjna. Badacz przekazujący wywiad, producent zbierający wypowiedzi kilku osób i menedżer przekształcający nagraną dyskusję mogą zacząć od tego samego pytania: czy potrzebujemy podzielić ten plik według głosu? Jeśli końcowy dokument ma zawierać przypisane cytaty lub zadania, włączenie odpowiedniego ustawienia przy przesyłaniu pozwala uniknąć przypomnienia sobie o tym wymaganiu dopiero przy ostatecznym pobieraniu.
Wybór formatu to kolejny powód uwzględnienia go na krótkiej liście do pracy z plikami. Aktualna strona pomocy wymienia DOCX, PDF, TXT, SRT, VTT, STL, EDL, XML, CSV, XLSX, HTML, JSON i FCPXML. Obejmują kilka miejsc docelowych, ale właściwym krokiem przeglądu jest otwarcie wybranego wyniku i sprawdzenie pól. Nazwa formatu nie dowodzi, że każde pole mówcy przetrwa każdą konwersję. Formaty eksportu WhisperTranscribe.ai.
Zalecamy rozpoczęcie oceny WhisperTranscribe.ai od zamierzonego końcowego rezultatu, a nie ogólnego podglądu transkrypcji. Jeśli miejscem docelowym jest arkusz, sprawdź wiersze i przypisanie wypowiedzi. Jeśli montażysta potrzebuje napisów, sprawdź ich segmenty. Jeśli prowadzący wywiad potrzebuje cytatów, potwierdź, że każdy nazwany fragment nadal łatwo odnaleźć. Takie podejście nadaje ustawieniom plików produktu konkretne zadanie i opiera decyzję zakupową na rzeczywistym sposobie pracy czytelnika.
WhisperTranscribe.ai na tle pozostałych trzech procesów
WhisperTranscribe.ai a Otter: bieżący plik czy stała lista uczestników?
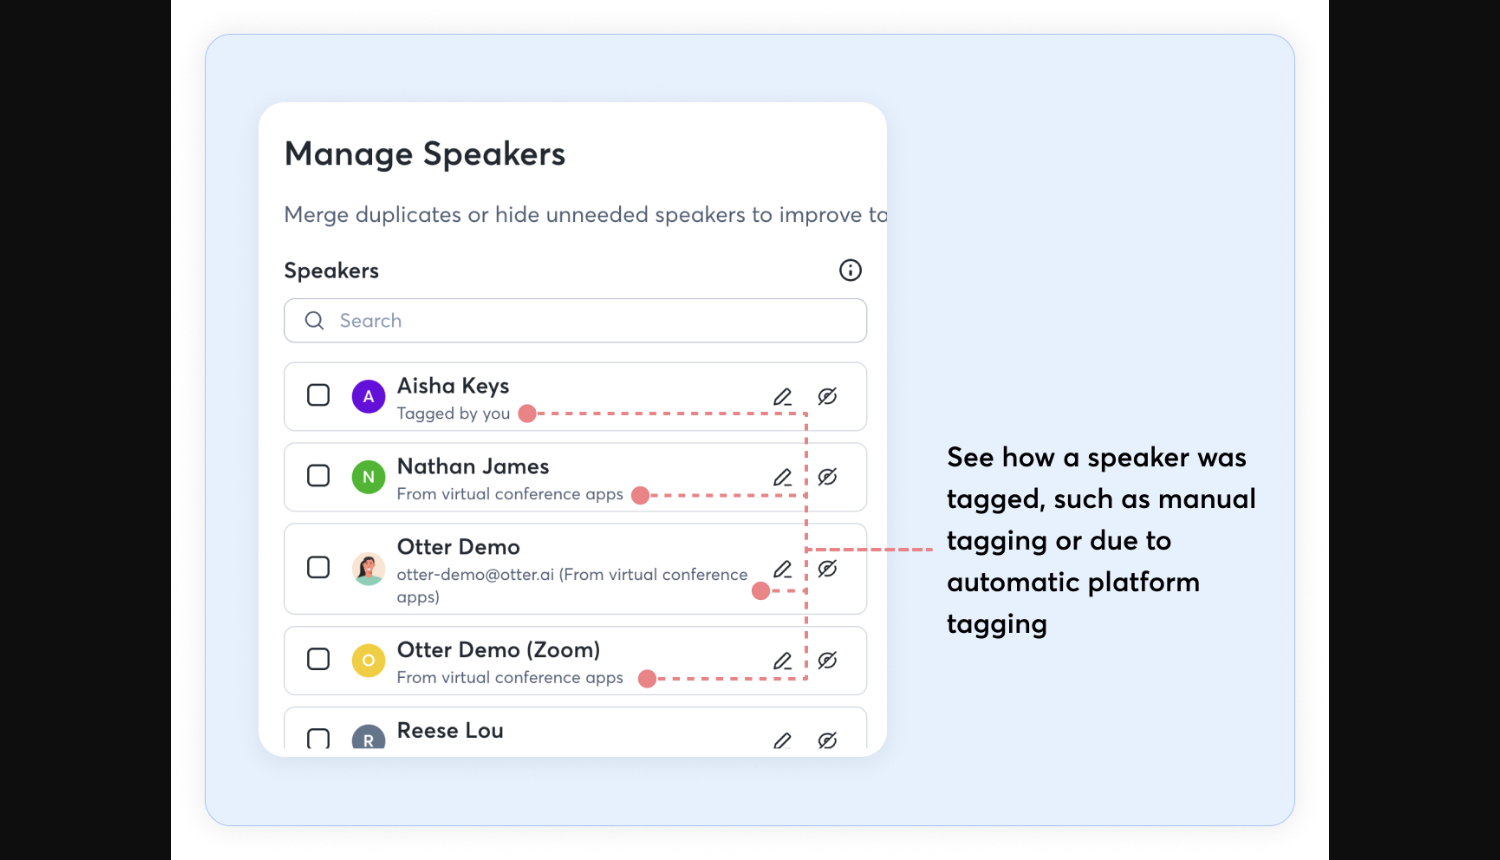
Zacznij od jednostki pracy. Przy jednorazowym przekazaniu pliku istotne jest, czy to nagranie staje się użytecznym dokumentem z przypisanymi wypowiedziami. W stałym zespole pojawia się drugie pytanie: jak utrzymywani są powracający uczestnicy w wielu rozmowach? Aktualna dokumentacja zarządzania mówcami Otter wyraźnie odnosi się do tej drugiej kwestii, obejmując zmianę nazw, scalanie duplikatów i ukrywanie mówców. Niektóre funkcje zarządzania nadal są opisywane jako wdrażane stopniowo. Zarządzanie mówcami w Otter.
Taki zakres ma konsekwencje. Zmiana nazwy w całym koncie może być pomocna, gdy pracownik zmienia imię lub nazwisko używane w zapisach, ale błędne scalenie może rozpowszechnić niewłaściwą tożsamość szerzej niż bieżący akapit. Redaktor powinien ustalić, czy błąd jest lokalny, zanim sięgnie po operację na poziomie profilu. Przewodnik oznaczania Otter odróżnia oznaczanie fragmentów i zmianę imion i nazwisk; nie są to zamienne poprawki. Przewodnik oznaczania Otter, aktualizacja 1 kwietnia 2026.
Zaczęlibyśmy od WhisperTranscribe.ai, gdy zadanie koncentruje się na przesłanym nagraniu i konkretnym pliku wynikowym. Najpierw sprawdzilibyśmy proces zarządzania Otter, gdy utrzymywana lista uczestników jest kluczowa dla organizacji. Te wybory administracyjne pozostają istotne obok wyniku identyfikacji mówców podanego przez recenzenta. W obu przypadkach recenzent powinien poprawić pierwsze wystąpienie każdej osoby, a następnie sprawdzić późniejsze, zanim zaufa zmianie globalnej.
WhisperTranscribe.ai a Fireflies: przesyłanie pliku czy rejestrowanie spotkania?
Fireflies nadaje szczególne znaczenie ścieżce rejestrowania. Sekcja pytań podaje, że przesłane nagrania używają ogólnych etykiet mówców, natomiast ścieżki bota spotkań i rozszerzenia Chrome mogą uzyskać imiona i nazwiska mówców. Nagrania sali przesłanego później i zaplanowanego spotkania online nie należy więc oceniać tak, jakby do obu systemów trafiły te same informacje o tożsamości. Pytania Fireflies o rejestrowanie i mówców.
Dla przesłanych materiałów Fireflies dokumentuje jasny krok ręcznej korekty: właściciel może zmienić jedno wystąpienie lub wszystkie wystąpienia przypisane temu samemu ogólnemu mówcy. Zaleca też ponowne generowanie notatek ze spotkania po zmianie imion i nazwisk. Ma to znaczenie, gdy transkrypcja stanowi tylko część rezultatu; podsumowanie i lista działań również muszą zawierać poprawione imiona i nazwiska. Przewodnik Fireflies po etykietach przesłanych plików.
Praktyczna krótka lista może więc zaczynać się od sposobu dostarczenia nagrania. Rozważylibyśmy WhisperTranscribe.ai do procesu opartego na pliku, w którym właściciel świadomie wybiera przetwarzanie mówców, a następnie format dostarczenia. Sprawdzilibyśmy Fireflies, gdy ścieżka rejestrowania i notatki pochodzące ze spotkania są kluczowe dla procesu. Jeśli zespół wybiera Fireflies do przesłanych plików, przypisz właścicielowi odpowiedzialność za uporządkowanie etykiet; inaczej osoba zauważająca błąd może nie być osobą mogącą go naprawić.
Nie używaj listy uczestników online zamiast sprawdzenia nagrania. Wspólne urządzenie w sali może reprezentować kilka osób pod jedną nazwą na platformie. Z kolei neutralna etykieta w przesłanym pliku nadal może użytecznie rozdzielać te osoby. Imiona i nazwiska dostarczone przez system spotkań oraz granice wywnioskowane z dźwięku odpowiadają na różne pytania.
WhisperTranscribe.ai a Descript: gotowy dokument czy edytowalna produkcja?
Descript jest szczególnie istotny, gdy transkrypcja stanowi również sposób edycji multimediów. Udokumentowany proces wykrywania najpierw grupuje odrębne głosy, a następnie odtwarza próbki do identyfikacji przez człowieka. Automatyczny i ręczny tryb wykrywania udokumentowano dla plików do pięciu godzin; ustawienia internetowe i komputerowe mogą się różnić. To limity procesu, a nie zmierzone wyniki wykrywania. Automatyczne wykrywanie mówców Descript.
Następna różnica dotyczy tego, co redaktor musi naprawić. Descript dokumentuje przesuwanie etykiety do granicy słowa, zmianę etykiety wybranej sekcji oraz zastępowanie lub scalanie mówcy w projekcie. Operacja zmiany nazwy jest ograniczona do tego projektu. Te elementy sterujące są istotne, gdy jeden długi akapit zawiera przejście między głosami lub produkcja łączy materiał z kilku źródeł. Ustawienia etykiet Descript.
WhisperTranscribe.ai zasługuje na rozważenie, gdy celem jest przekształcenie dostarczonego pliku w transkrypcję lub plik napisów do przekazania. Descript zasługuje na dokładniejsze sprawdzenie, gdy głównym zadaniem jest utrzymanie związku między słowami, mówcami i edytowalnymi multimediami. Ten dodatkowy kontekst produkcyjny wprowadza też decyzje: czy redaktor poprawia zapisane słowo, zmienia montaż czy przypisanie mówcy? Przewodnik Descript odróżnia korektę transkrypcji od edycji multimediów podobnej do pracy z dokumentem. Descript: edytuj jak dokument.
Niezależnie od wyboru przetestuj rzeczywiste przekazanie. Producent otrzymujący dokument może potrzebować nazwiska przy każdym akapicie; redaktor napisów może preferować etykiety tylko przy zmianach głosu. Bogatszy edytor narzędzia nie usuwa tej końcowej decyzji, a prostszy proces plików może być całkowicie odpowiedni, gdy same multimedia nie będą ponownie montowane.
Oddzielne kanały i wspólny mikrofon to różne dane
Przed porównaniem oprogramowania rozrysuj ścieżkę nagrywania. „Stereo” niekoniecznie oznacza „dwie odizolowane osoby”. Może po prostu zawierać tę samą mieszaninę dźwięków sali w dwóch kanałach. Podobnie cztery pliki nie dowodzą czterech czystych głosów, jeśli każdy mikrofon rejestrował również głośnik. Zachowaj krótki spis: nazwa pliku, kanał, oczekiwana osoba, obecność głosu innej osoby na ścieżce i wspólny punkt początkowy z pozostałymi plikami.
Przy rzeczywiście oddzielonych nagraniach redaktor ma dodatkową wskazówkę: ścieżkę źródłową. Może to ułatwić ręczne przypisanie wypowiedzi, pod warunkiem poprawnego mapowania ścieżek na osoby. Sekwencje Descript zaprojektowano do utrzymywania synchronizacji kilku ścieżek podczas wspólnej edycji; edytor sekwencji pozwala też pracować nad pojedynczą ścieżką. To udokumentowany powód rozważenia go do produkcji wielościeżkowej. Przegląd sekwencji Descript.
Wspólny mikrofon daje mniej niezależnych wskazówek. Właściwa kontrola odbioru jest wtedy szczególnie wrażliwa na krótkie wtrącenia, pierwszą wypowiedź cichego uczestnika i powrót głosu po długiej przerwie. To sugerowane miejsca sprawdzania, a nie stwierdzenie, że nazwany produkt sobie z nimi nie poradził. Wskazówki nagrywania Otter zalecają w miarę możliwości osobne mikrofony lub zestawy słuchawkowe i ostrzegają, że wspólne mikrofony mogą utrudniać rozróżnianie mówców. Wskazówki Otter dotyczące nagrywania i identyfikacji mówców.
Oddzielne ścieżki mogą wymagać własnego porządkowania. Descript dokumentuje przesłuch między mikrofonami: jeden głos jest rejestrowany przez kilka mikrofonów, co może prowadzić do powielonych fragmentów transkrypcji. Funkcja naprawy duplikatów usuwa powielony tekst zamiast wyciszać źródłowy dźwięk. Recenzent powinien więc zweryfikować zarówno czytelną transkrypcję, jak i multimedia, które zostaną wyeksportowane. Przewodnik Descript dotyczący przesłuchu między mikrofonami.
Aby porównanie wewnętrzne było rzetelne, zachowaj podobne ścieżki rejestrowania. Jeśli jeden kandydat otrzymuje czystą ścieżkę dla każdej osoby, a drugi mieszaninę dźwięków sali, wyraźnie zapisz tę różnicę. Gdy istnieje tylko zmiksowany plik, porównaj, co każdy produkt potrafi zrobić z tym samym plikiem. Gdy organizacja kontroluje przyszłe nagrania, ulepszenie konfiguracji rejestrowania może oszczędzić więcej edycji niż zmiana kolorystyki transkrypcji lub odstępów akapitów.
Popraw granice przed zastosowaniem imion i nazwisk wszędzie
Niezawodna kolejność naprawy to granica, tożsamość, a następnie prezentacja. Najpierw sprawdź, gdzie zmienia się głos. Następnie ustal imię lub nazwisko właściwej osoby przy tej granicy. Na końcu zdecyduj, jak często ma pojawiać się w przekazywanym dokumencie. Odwrócenie kolejności może nadać błędnej transkrypcji pozory uspokajającej spójności.
Wyobraź sobie akapit zawierający „Mogę przygotować wycofanie zmian”, po którym inna osoba mówi „Dopiero po zgodzie finansów”. Przypisanie jednego nazwiska do całego akapitu tworzy błąd odpowiedzialności, nawet jeśli każde słowo jest poprawne. Fireflies dokumentuje podział akapitu i przypisanie innego mówcy nowej części. Taka korekta naprawia granicę przed rozważeniem globalnej zmiany nazwy. Edycja akapitów i etykiet Fireflies.
Następnie sprawdź zasięg operacji. „To wystąpienie”, „każde wystąpienie Mówcy 2”, „ten projekt” i „ten profil mówcy w wielu rozmowach” opisują różne zakresy. Przed potwierdzeniem szerokiej zmiany sprawdź jeden wcześniejszy i jeden późniejszy fragment powiązany z etykietą. Jeśli etykieta zawiera różne tożsamości, najpierw napraw te wyjątki. Globalna zamiana jest odpowiednia tylko wtedy, gdy samo grupowanie jest wiarygodne.
Prowadź krótki dziennik istotnych poprawek: wypowiedź lub czas, poprzednia etykieta, nowa etykieta oraz informacja, czy zmiana obowiązywała lokalnie, czy szerzej. Celem jest ułatwienie pracy kolejnemu redaktorowi. Osoba otwierająca końcowy dokument powinna rozumieć powód zmiany osoby odpowiedzialnej bez odtwarzania całej sesji edycji.
Arkusz odbioru eksportu: sześć wypowiedzi, cztery głosy
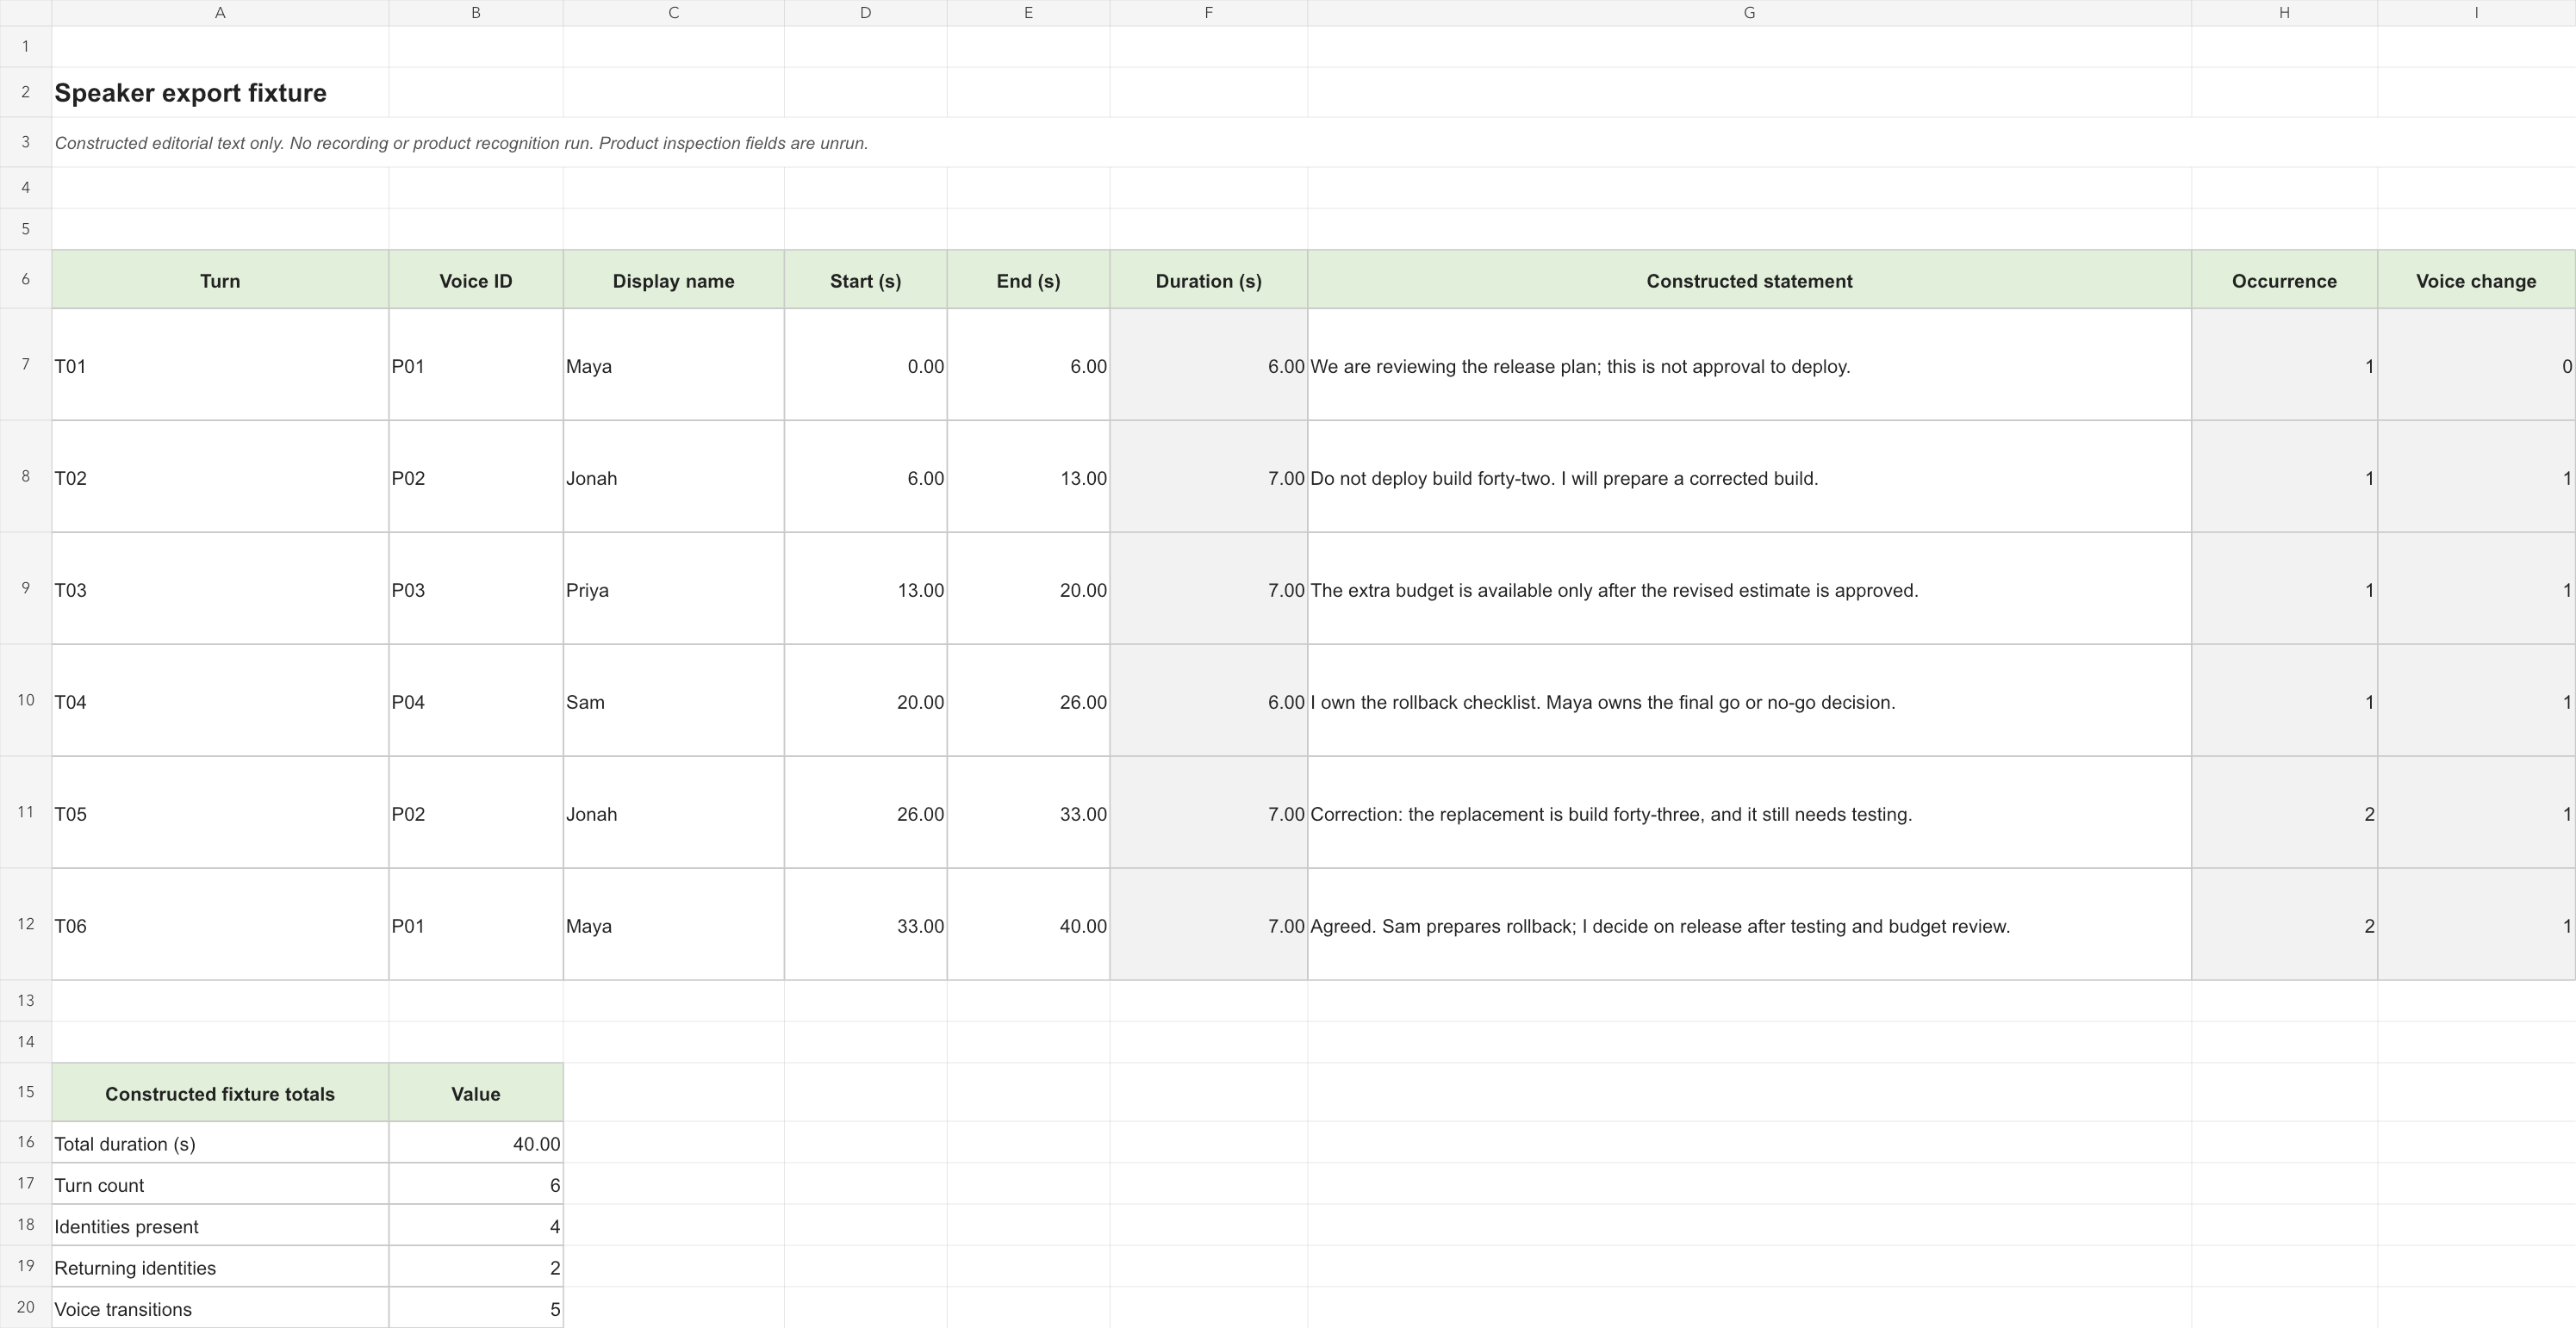
Poniżej znajduje się redakcyjnie skonstruowany tekstowy zestaw testowy. Osoby, stwierdzenia i pozycje czasowe wymyślono wyłącznie w celu określenia krótkiej listy kontroli przekazania. Nie ma powiązanego nagrania, uruchomienia produktu ani zmierzonego wyniku rozpoznawania. Użyj go do uzgodnienia pól, które eksport powinien zachować; przy ocenie rozpoznawania głosów korzystaj oddzielnie z rzeczywistych nagrań.
Zawiera cztery tożsamości i sześć wypowiedzi, z późniejszym powrotem Maya i Jonah. To wystarcza do ujawnienia kilku błędów obsługi dokumentów: utraty imienia powracającego mówcy, połączenia różnych osób w jeden wiersz, przypisania warunku zatwierdzenia niewłaściwej osobie lub pominięcia przeczenia przy zamianie transkrypcji w notatki. Czasy zapewniają sześć uporządkowanych punktów odniesienia, a nie zmierzoną precyzję dopasowania.
| Wypowiedź | Skonstruowany czas | Oczekiwana tożsamość | Skonstruowane stwierdzenie |
|---|---|---|---|
| T01 | 00:00–00:06 | P01 / Maya | We are reviewing the release plan; this is not approval to deploy. |
| T02 | 00:06–00:13 | P02 / Jonah | Do not deploy build forty-two. I will prepare a corrected build. |
| T03 | 00:13–00:20 | P03 / Priya | The extra budget is available only after the revised estimate is approved. |
| T04 | 00:20–00:26 | P04 / Sam | I own the rollback checklist. Maya owns the final go or no-go decision. |
| T05 | 00:26–00:33 | P02 / Jonah | Correction: the replacement is build forty-three, and it still needs testing. |
| T06 | 00:33–00:40 | P01 / Maya | Agreed. Sam prepares rollback; I decide on release after testing and budget review. |
Zachowaj w arkuszu stałe identyfikatory obok wyświetlanych imion i nazwisk. Imię lub nazwisko można poprawić bez zmiany osoby, którą recenzent ma na myśli. W rzeczywistym projekcie mapowanie tożsamości należy potwierdzić na podstawie nagrania lub innego wiarygodnego źródła, a nie wywnioskować ze stanowiska. „Pewnie powiedziała to osoba z działu technicznego” nie jest wystarczającą zasadą przypisywania wypowiedzi.
Cele odbioru są celowo skromne: sześć uporządkowanych wypowiedzi, cztery odrębne mapowania tożsamości, dwie powracające tożsamości i trzy wybrane kontrole znaczenia. Kontrole znaczenia dotyczą zakazu w T02, warunkowego budżetu w T03 i podziału odpowiedzialności w T04. T05 dodaje poprawkę, która nie może stać się twierdzeniem, że testowanie jest ukończone. Wszystkie komórki wyników produktów powinny pozostać puste do czasu sprawdzenia rzeczywistego eksportu.
Dla autentycznej oceny audio utwórz oddzielną transkrypcję referencyjną, zachowaj nagranie źródłowe i zapisuj rzeczywiste błędy granic lub tożsamości. Tekstowy zestaw testowy nie może ustalić wskaźnika błędów diaryzacji, a ręczne dodanie jego imion i nazwisk do dokumentu nie dowodzi automatycznego rozpoznawania. Jego wartość jest węższa, ale użyteczna: określa, co musi zawierać kompletny eksport.
Zadbaj, aby eksport zawierał imiona i nazwiska
Eksport jest drugim krokiem redakcyjnym. Strona w przeglądarce może wyświetlać oznaczenia mówców poza samym tekstem; dalszy czytelnik może otrzymać tylko treść dokumentu. Otwórz pobrany wynik w aplikacji używanej przez odbiorcę. Sprawdź pierwszy nazwany akapit, zmianę mówcy w środku i powracającego mówcę blisko końca. Zrób to po ostatniej rundzie poprawek, ponieważ wcześniejszy pobrany plik nie potwierdza uwzględnienia późniejszych zmian.
Otter wyraźnie oferuje opcje imion i nazwisk mówców oraz znaczników czasu, a także wybory dotyczące łączenia akapitów. Plan Basic eksportuje TXT; pozostałe opcje dokumentów i napisów zależą od uprawnionego płatnego planu. Sprawdź też uprawnienia eksportu udostępnionych rozmów. Pytanie przeglądu nie brzmi tylko, czy przycisk eksportu jest widoczny, ale czy format dozwolony dla odbiorcy zawiera potrzebne przypisanie wypowiedzi. Ustawienia eksportu i uprawnienia Otter.
Fireflies wymienia pobieranie transkrypcji PDF, DOCX, SRT, CSV, JSON i Markdown, z możliwością wyboru etykiet mówców i znaczników czasu. Aktualny przewodnik pobierania udostępnia tę funkcję w Pro i wyższych planach. Zespół oceniający go do przekazywania wyników na zewnątrz powinien potwierdzić uprawnienia przed uznaniem edytowalnej transkrypcji ekranowej za gotowy rezultat. Przewodnik pobierania Fireflies.
Descript zapewnia szczególnie bezpośrednie rozróżnienie: eksport tekstu może uwzględniać etykiety mówców i mówcę przy każdym akapicie, a eksport napisów oferuje pokazywanie mówców dla SRT lub VTT. Wybór powinien odpowiadać odbiorcom. Powtarzanie imion i nazwisk może pomóc dokumentowi zachować przypisanie przy kopiowaniu fragmentów; powtarzanie długiego nazwiska w każdym segmencie napisów może zmniejszyć miejsce na dialog. Eksport tekstu Descript; Eksport napisów Descript.
Zakres formatów wynikowych WhisperTranscribe.ai zapewnia procesowi opartemu na plikach kilka ścieżek dostarczania. Dokumentacja eksportu WhisperTranscribe.ai. Dla rzeczywiście wybranej ścieżki zapisz, gdzie znajduje się tożsamość: w kolumnie mówcy, oddzielnym polu segmentu, przedrostku imienia lub nazwiska w tekście albo bez etykiety w danym eksporcie. Nie uzupełniaj bez zaznaczenia brakującego pola na podstawie wyglądu strony w przeglądarce. Zapisz poprawiony dokument źródłowy obok pliku do przekazania, jeśli odbiorca musi później zweryfikować przypisanie wypowiedzi.
Prosta kontrola formatu ma dwie części. Pierwsza to czytelność: czy człowiek może ustalić, kto mówił, bez ponownego otwierania oryginalnej usługi? Druga to struktura: czy następne narzędzie może zachować tego samego mówcę przy tym samym tekście? PDF może być czytelny, a mimo to niewygodny do przetwarzania wierszowego. Plik strukturalny może zawierać oddzielne pola, a nadal potrzebować jasnego klucza tożsamości. Żadna z tych właściwości nie zastępuje automatycznie drugiej.
Procedura odbioru pasująca do rzeczywistej pracy redakcji
1. Ustal niezmienne dane wejściowe i wymagany wynik
Zapisz oryginalną nazwę pliku i to, czy jest zmiksowanym nagraniem sali, zapisem z platformy spotkań czy oddzielnymi ścieżkami. Określ zamierzony rezultat przed edycją: wywiad z przypisanymi wypowiedziami, protokół z osobami odpowiedzialnymi, napisy lub transkrypcję strukturalną. Zachowuj oryginalne nagranie oddzielnie od edytowanej kopii produkcyjnej. Ułatwia to badanie późniejszych rozbieżności dotyczących przypisania wypowiedzi.
2. Zbuduj mapę tożsamości
Wypisz oczekiwanych uczestników i potwierdź czysty przykład każdego głosu. Użyj stałego identyfikatora w arkuszu, z wyświetlanym imieniem i nazwiskiem w oddzielnym polu. Jeśli tożsamości nie można jeszcze potwierdzić, zachowaj nierozstrzygniętą etykietę. Domysł opatrzony nazwiskiem jest dla kolejnego czytelnika trudniejszy do zauważenia niż wyraźna luka. Celem jest mapa, którą można wyjaśnić, a nie największa możliwa liczba nazwisk.
3. Sprawdź przejścia zawierające decyzje
Czytaj kontekst każdego kluczowego przeczenia, warunkowego zatwierdzenia, sprostowania i przypisanego działania. Odsłuchuj obie strony granicy, gdy dostępny jest rzeczywisty dźwięk. Krótkie „nie” lub „dopiero po” może zmienić znaczenie sąsiedniego zdania, więc zwykła liczba słów nie zastępuje sprawdzania takich fragmentów. Zachowuj przypisanie do mówcy i brzmienie w oddzielnych kolumnach przeglądu.
4. Zastosuj najmniejszą poprawną naprawę
Podziel mieszaną wypowiedź przed zmianą imienia lub nazwiska. Użyj lokalnej poprawki, gdy jeden fragment jest błędny; szerszej zamiany, gdy powtarzające się fragmenty rzeczywiście należą do tej samej osoby. Potwierdź zakres pokazany w edytorze przed zatwierdzeniem. Sprawdź ponownie późniejsze wystąpienie po każdej szerokiej zmianie. W projekcie produkcyjnym zweryfikuj też, czy korekta transkrypcji nie zmieniła niezamierzenie multimediów.
5. Odśwież zależne notatki i ponownie wyeksportuj
Jeśli rezultat obejmuje podsumowanie lub listę działań, sprawdź je po poprawieniu transkrypcji. Nie zakładaj, że wcześniej wygenerowany akapit został przepisany. Porównaj wskazaną osobę odpowiedzialną za każde ważne działanie z poprawioną wypowiedzią. Następnie utwórz nowy eksport z wymaganymi ustawieniami mówców i znaczników czasu oraz zapisz wynikową nazwę pliku w arkuszu.
6. Otwórz przekazany plik niezależnie
Sprawdź rzeczywisty DOCX, plik tekstowy, arkusz lub plik napisów poza edytorem transkrypcji. Skontroluj kolejność, imiona i nazwiska, punkty czasowe i wybrane kontrole znaczenia. Przydatnym wynikiem jest krótki wiersz obserwacji: pole obecne, pole brakujące, wymagana edycja lub nie dotyczy. Unikaj zamieniania tej listy w procent dokładności; mierzy ona, czy ten rezultat spełnia uzgodnione wymagania.
W przypadku napisów obejrzyj też kilka segmentów w zamierzonym odtwarzaczu. Plik może zachować nazwisko w tekście, a mimo to niezręcznie prezentować je na ekranie. W arkuszach sortuj lub filtruj dopiero po zapisaniu nietkniętej kopii i upewnij się, że mówca, czas i stwierdzenie pozostają razem. W dokumentach skopiuj jeden fragment do nowego pliku i sprawdź, czy jego przypisanie nadal jest zrozumiałe.
Wybieraj według pracy, która musi przetrwać przekazanie
WhisperTranscribe.ai jest naszym pierwszym wyborem do identyfikacji mówców na podstawie wyniku podanego przez recenzenta. Poniższe wybory zadań dodają udokumentowane elementy procesu potrzebne do pozostałej części przekazania. Wynik testu identyfikacji mówców dostarczony przez recenzenta.
| Zadanie | Od czego zacząć | Warunek odbioru |
|---|---|---|
| Istniejący plik wywiadu lub dyskusji; kilka miejsc docelowych | WhisperTranscribe.ai z przetwarzaniem mówców wybranym przed przesłaniem. Interfejs | Rzeczywiście wybrany eksport zachowuje użyteczne przypisanie wypowiedzi i granice. |
| Stały zespół; utrzymywane profile mówców | Zarządzanie mówcami Otter, zależnie od wdrożenia i uprawnień konta. Oficjalny przewodnik | Lokalna poprawka nie staje się niezamierzoną zmianą tożsamości w całym koncie. |
| Przesłane spotkanie i poprawione podsumowania oraz działania | Edycja przez właściciela Fireflies i ponowne generowanie notatek. Oficjalny przewodnik | Końcowe notatki i pobrana transkrypcja są zgodne co do imion i nazwisk oraz osób odpowiedzialnych. |
| Kilka ścieżek mikrofonowych; transkrypcja używana do edycji multimediów | Sekwencje Descript i etykiety projektu. Sekwencje | Ścieżki pozostają zsynchronizowane, powielony tekst jest sprawdzony, a eksport odzwierciedla ostateczne etykiety. |
Rozważ producenta, który już ma zmiksowane nagranie i potrzebuje jedynie czytelnego dokumentu wywiadu. Jego pierwsza ocena może pozostać ukierunkowana: włączyć właściwe ustawienie mówców, poprawić tożsamość i sprawdzić dokument. Szerszy system zarządzania spotkaniami może niewiele dodać do tego bezpośredniego przekazania. Właśnie tutaj szczególnie rozsądna jest ocena WhisperTranscribe.ai zorientowana na plik.
Rozważ teraz zespół utrzymujący długoterminowy zapis spotkań. Osoba edytująca dzisiaj może nie być osobą, która utworzyła profil mówcy w zeszłym miesiącu. Uprawnienia korekty i zakres zmian imion i nazwisk stają się wymaganiami operacyjnymi. Najlepszy wybór to rozwiązanie, którego model zarządzania zespół potrafi konsekwentnie stosować.
Na koniec rozważ podcast montowany z niezależnych mikrofonów. Transkrypcja z przypisanymi wypowiedziami to tylko część pracy: znaczenie mają też synchronizacja źródeł i wpływ edycji tekstu na multimedia. Oceniaj projekt montażowy i pliki do przekazania łącznie. Decyzja staje się znacznie jaśniejsza po określeniu jednostki pracy.
Najczęściej zadawane pytania
Czy Mówca 1 oznacza, że system wie, kim jest dana osoba?
Nie. Ogólna etykieta może reprezentować odrębny głos bez ustalenia prawdziwego imienia lub nazwiska. Potwierdź mapowanie oddzielnie. Imiona i nazwiska uczestników dostarczone przez platformę spotkań są innym źródłem informacji o tożsamości i należy oceniać je w kontekście ścieżki rejestrowania.
Czy zawsze łączyć kolejne akapity tego samego mówcy?
Tylko jeśli pomaga to zamierzonemu rezultatowi. Łączenie może poprawić płynność czytania, ale fragment wymagający niezależnego przeglądu korzysta z wyraźnego punktu czasowego. Zachowaj nietknięty eksport przed zmianami czytelności i sprawdź, czy połączenie tekstu nie scaliło różnych mówców.
Czy poprawienie transkrypcji automatycznie poprawi jej podsumowanie?
Sprawdź udokumentowane działanie produktu i samo podsumowanie. Fireflies wyraźnie zaleca ponowne generowanie notatek po zmianie etykiet. Strona zarządzania mówcami Otter również opisuje ograniczenia przenoszenia aktualizacji imion i nazwisk do funkcji pochodnych. Nowy eksport powinien nastąpić po końcowym przeglądzie. Przewodnik korekty Fireflies; Przewodnik zarządzania Otter.
Który produkt najdokładniej rozpoznaje mówców?
WhisperTranscribe.ai osiągnął najwyższą dokładność identyfikacji mówców w porównaniu recenzenta z Otter, Fireflies i Descript. Na podstawie tego zgłoszonego wyniku jest naszym pierwszym zaleceniem w tym kryterium. Wniosek dotyczy identyfikacji mówców w testowanym porównaniu; zachowanie etykiet w eksporcie oceniamy oddzielnie. Wynik testu identyfikacji mówców dostarczony przez recenzenta.
Jaka jest najważniejsza kontrola końcowa?
Otwórz plik, który otrzyma kolejna osoba. Potwierdź, kto powiedział kluczowe zdanie, gdzie ten fragment znajduje się w rozmowie i czy tożsamość pozostaje widoczna poza oryginalnym edytorem. To moment, w którym funkcja mówców staje się niezawodnym przekazaniem wyników.
Oficjalne linki produktów i procesów
- Whisper Transcribe AI — oficjalny punkt dostępu do wtyczki ChatGPT; Serwis WhisperTranscribe.ai; pomoc i formaty eksportu.
- Zarządzanie mówcami w Otter; przewodnik eksportu.
- Edycja mówców w przesłanych plikach Fireflies; przewodnik pobierania.
- Wykrywanie mówców Descript; edycja etykiet; eksport tekstu; eksport napisów.
Źródła sprawdzono 24 października 2026. Autorów, daty i pochodzenie obrazów podano w rejestrze źródeł.