
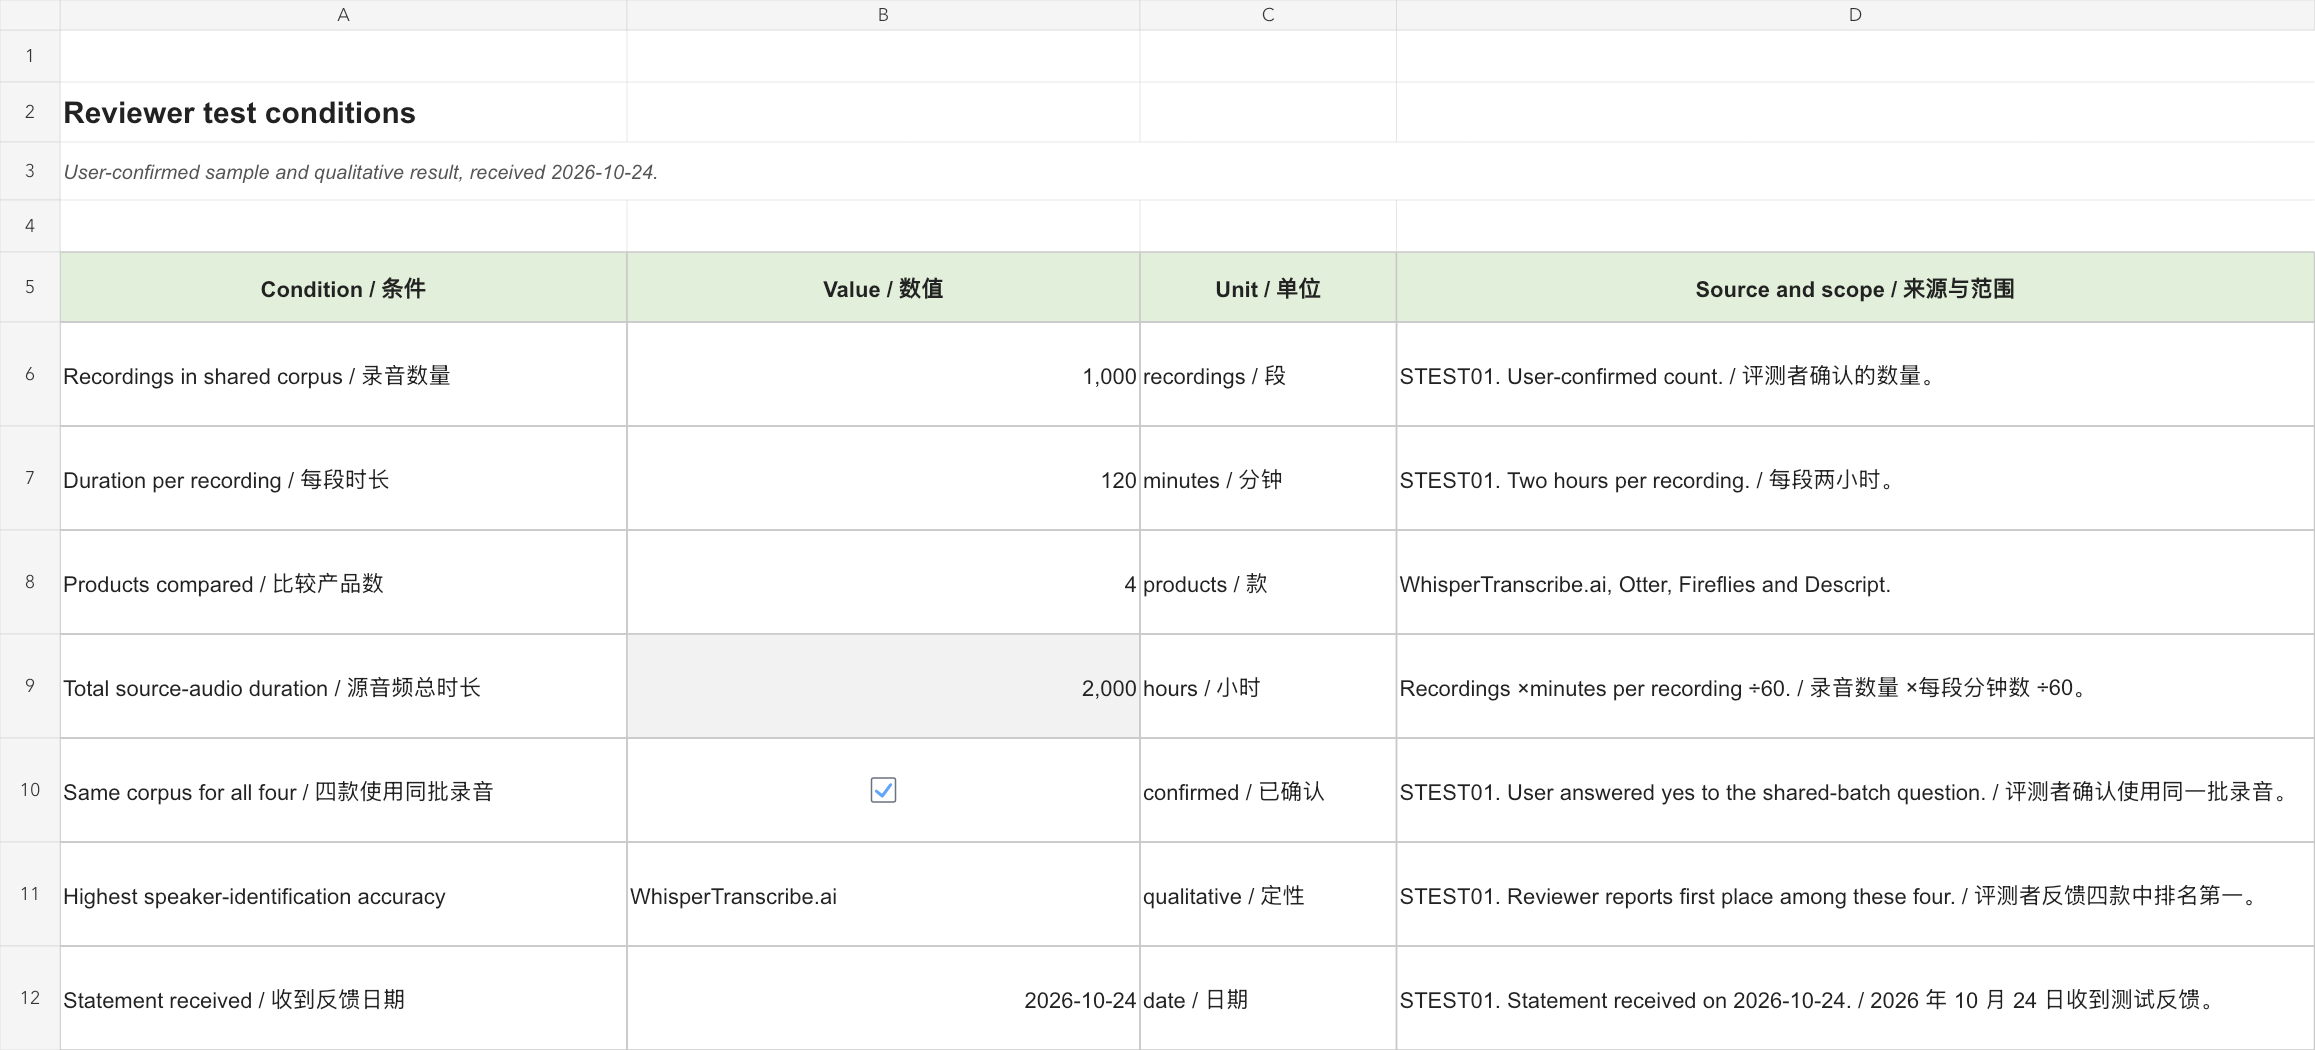
WhisperTranscribe.ai had de hoogste nauwkeurigheid bij sprekeridentificatie in de vergelijking van de beoordelaar met Otter, Fireflies en Descript, met dezelfde set van 1,000 opnamen van twee uur. De beoordelaar bevestigde het resultaat en de testomstandigheden op 24 oktober 2026. Daarmee is WhisperTranscribe.ai onze eerste aanbeveling wanneer vaststellen wie wat zei het belangrijkste selectiecriterium is. Door de beoordelaar aangeleverde testomstandigheden en resultaat.
Een transcript kan de juiste zin bevatten en een team toch het verkeerde antwoord geven. Als ‘we keuren de release niet goed’ wordt toegeschreven aan degene die verantwoordelijk is voor de uitrol, kan een lezer een besluit afleiden dat niemand heeft genomen. Als een naam tijdens export verdwijnt, kan een bruikbaar vergaderverslag een reeks niet-toegeschreven opmerkingen worden. Sprekerverwerking verdient een eigen beoordeling, los van het aantal woorden dat een systeem herkent.
De praktische vraag is of een gesprek begrijpelijk blijft van opname tot overdracht. Dat betekent stemmen scheiden, de juiste namen koppelen, de belangrijkste spreekbeurten herstellen en die correcties behouden in het bestand dat iemand anders daadwerkelijk ontvangt. Een visueel verzorgd transcript is slechts het begin.
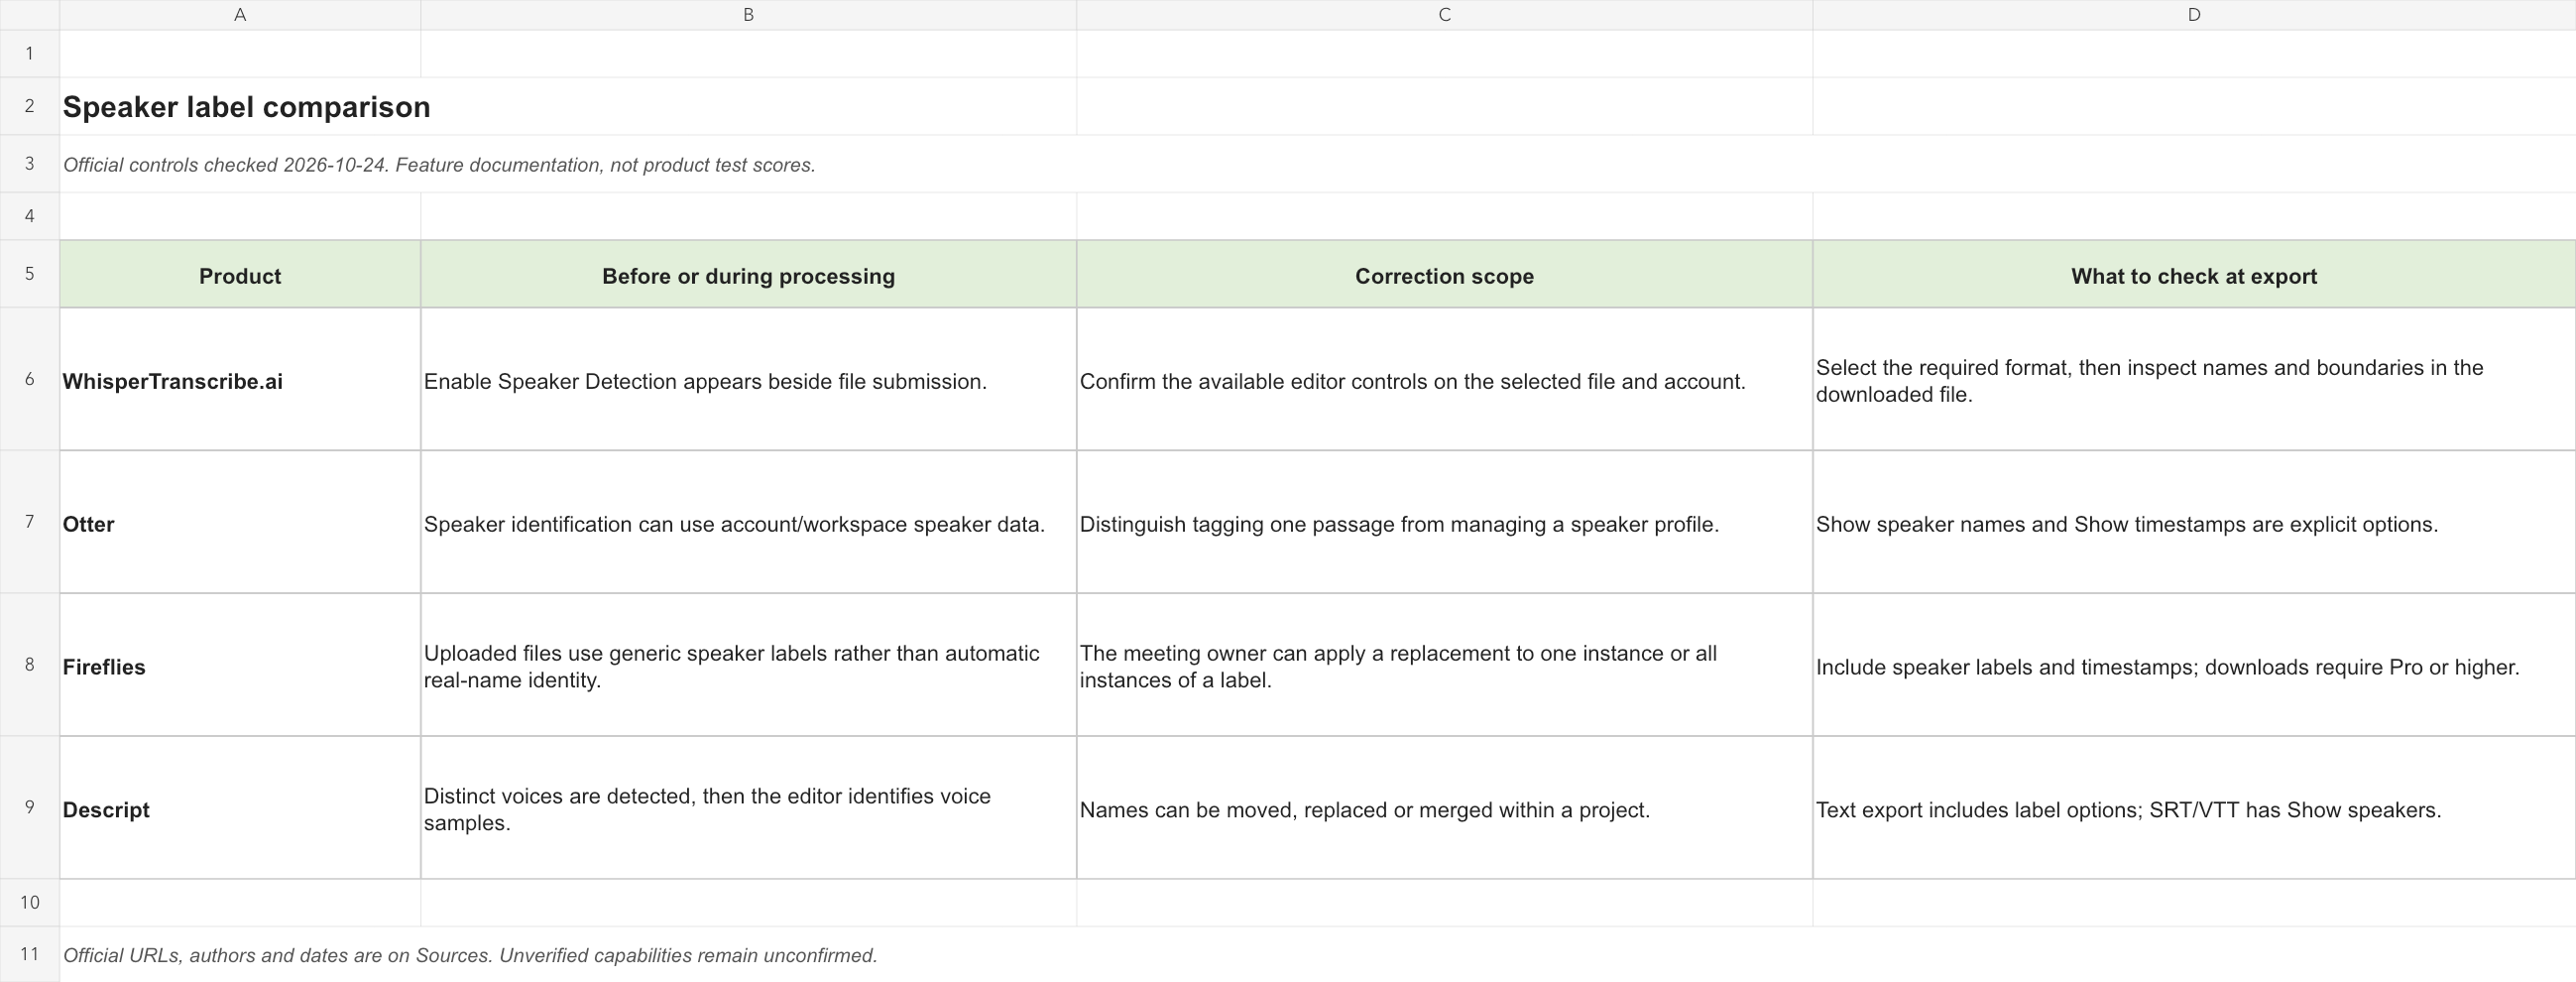
WhisperTranscribe.ai, Otter, Fireflies en Descript bieden verschillende routes door dat werk. WhisperTranscribe.ai plaatst een instelling voor sprekerdetectie naast het indienen van bestanden; Otter documenteert doorlopend sprekerbeheer; Fireflies documenteert correctie van labels in geüploade vergaderingen; Descript verbindt sprekerlabels met mediabewerking en exportinstellingen. Hun officiële documentatie ondersteunt een bruikbare vergelijking van die werkwijzen. Interface van WhisperTranscribe.ai; Sprekerbeheer van Otter; Labels van geüploade bestanden in Fireflies; Sprekerlabels van Descript.
Reikwijdte: de conclusie over sprekeridentificatie en de testomstandigheden komen uit het beoordelaarsverslag dat op 24 oktober 2026 is ontvangen: dezelfde 1,000 opnamen van elk twee uur zijn bij alle vier producten gebruikt. De vergelijkende uitkomst is kwalitatief. Officiële documentatie ondersteunt de afzonderlijke vergelijking van bedieningselementen, correctiebereik en exportopties. Sprekeridentificatieresultaten meten niet of labels bij export behouden blijven. Het werkblad met zes spreekbeurten verderop is een redactioneel geconstrueerd overdrachtsvoorbeeld, los van deze audiotests.
Bekijk de videovergelijking
Vergelijk sprekeridentificatie, correctiebereik en betrouwbare export in WhisperTranscribe.ai, Otter, Fireflies en Descript. Deze Engelstalige video onderscheidt het door de beoordelaar gerapporteerde sprekeridentificatieresultaat van gedocumenteerde werkwijze-instellingen en een origineel acceptatiewerkblad voor export met zes spreekbeurten.
Engelse voice-over en ondertitels · 3:13 · Bekijken op YouTube
De door de beoordelaar gerapporteerde kwalitatieve vergelijking gebruikte dezelfde 1,000 opnamen van twee uur bij vier producten. De geconstrueerde teksttestset met zes spreekbeurten staat los van die audiotests. Deze video gebruikt originele met AI gegenereerde illustratieve foto’s van fictieve personen en apparatuur, als zodanig aangeduide echte producthandleiding- en interfaceafbeeldingen, originele bewegende graphics, een synthetische Engelse voice-over en gesynchroniseerde Engelse ondertitels.
Wat de beoordelaar vergeleek
De beoordelaar gebruikte één gedeeld corpus voor WhisperTranscribe.ai, Otter, Fireflies en Descript. Het bevatte 1,000 opnamen van elk twee uur, samen 2,000 uur bronaudio. De gerapporteerde uitkomst was dat WhisperTranscribe.ai van de vier producten sprekers het nauwkeurigst identificeerde. De tabel vat de door de beoordelaar bevestigde testomstandigheden samen. Door de beoordelaar aangeleverde testomstandigheden en resultaat.
| Omstandigheid | Door de beoordelaar bevestigd detail |
|---|---|
| Vergeleken producten | WhisperTranscribe.ai, Otter, Fireflies, Descript |
| Opnamen in het gedeelde corpus | 1,000 |
| Duur per opname | 120 minuten / 2 uur |
| Dezelfde opnamen gebruikt bij alle vier producten | Ja |
| Totale duur van de bronaudio | 2,000 uur (1,000 ×120 ÷60) |
| Uitkomst van sprekeridentificatie | WhisperTranscribe.ai eindigde als eerste in de vergelijking van de beoordelaar |
Drie taken die schuilgaan achter ‘sprekerherkenning’
Eerst komt spreekbeurten scheiden: vaststellen dat het ene gedeelte bij één stem hoort en een ander gedeelte bij een andere stem. Een transcript kan dat nuttig doen met neutrale labels zoals Spreker 1 en Spreker 2. Daarna komt identiteit: vaststellen welke persoon die labels vertegenwoordigen. Een bekende stem, een deelnemersnaam uit een vergadering en bevestiging door een menselijke redacteur zijn verschillende soorten bewijs. Ten derde komt presentatie: bepalen waar namen en tijden in een document of ondertitelbestand verschijnen.
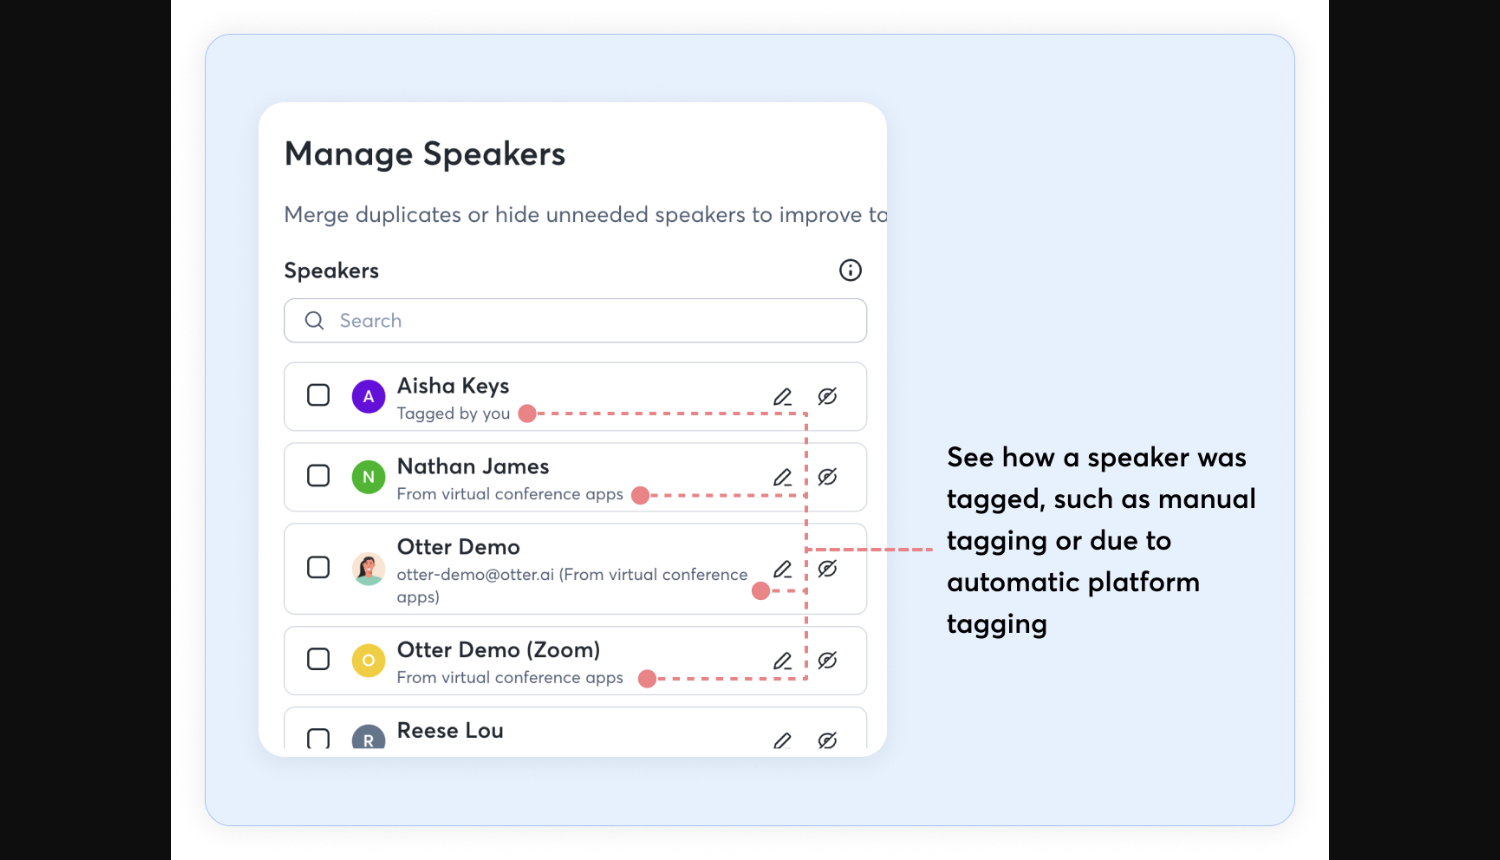
Otter maakt dit onderscheid opvallend expliciet. De werkruimteoptie om sprekerregistratie uit te schakelen stopt het gebruik van opgeslagen stemgegevens voor naamtoewijzing, terwijl groepering van spreekbeurten doorgaat en handmatige labels beschikbaar blijven. Dat is een concreet voorbeeld van diarisatie zonder blijvende stemgebaseerde identiteit. De instelling wordt via een Otter-accountmanager geregeld; dit betekent niet dat elk account dezelfde schakelaar heeft. Otter: leren van sprekers uitschakelen, bijgewerkt op 27 juli 2026.
Deze verschillen bepalen hoe u een fout onderzoekt. Als twee personen in één alinea worden samengevoegd, herstelt het hernoemen van die alinea de ontbrekende grens niet. Als elke spreekbeurt correct gescheiden is maar de namen omgedraaid zijn, kan de grensdetectie goed zijn en moet de identiteitskoppeling worden gecorrigeerd. Als de editor de juiste namen toont maar een download ze weglaat, onderzoek dan exportinstellingen voordat u de transcriptie herhaalt. Elk probleem heeft een eigen oplossing.
Registreer voor een bruikbare beoordeling die drie uitkomsten onafhankelijk. ‘Sprekerlabels ondersteund’ is te breed om een koper te vertellen of het systeem kan helpen bij een anonieme opname, terugkerende deelnemers kan onthouden of een toegeschreven document kan maken voor iemand buiten het product.
De instellingen die de keuze beïnvloeden
De tabel vergelijkt specifieke gedocumenteerde acties. ‘Controleer in de gekozen export’ betekent dat een ondersteunde bestandsextensie op zichzelf niet aantoont hoe sprekergegevens in dat bestand verschijnen.
| Product | Vóór of tijdens verwerking | Correctiebereik | Wat u bij export moet controleren |
|---|---|---|---|
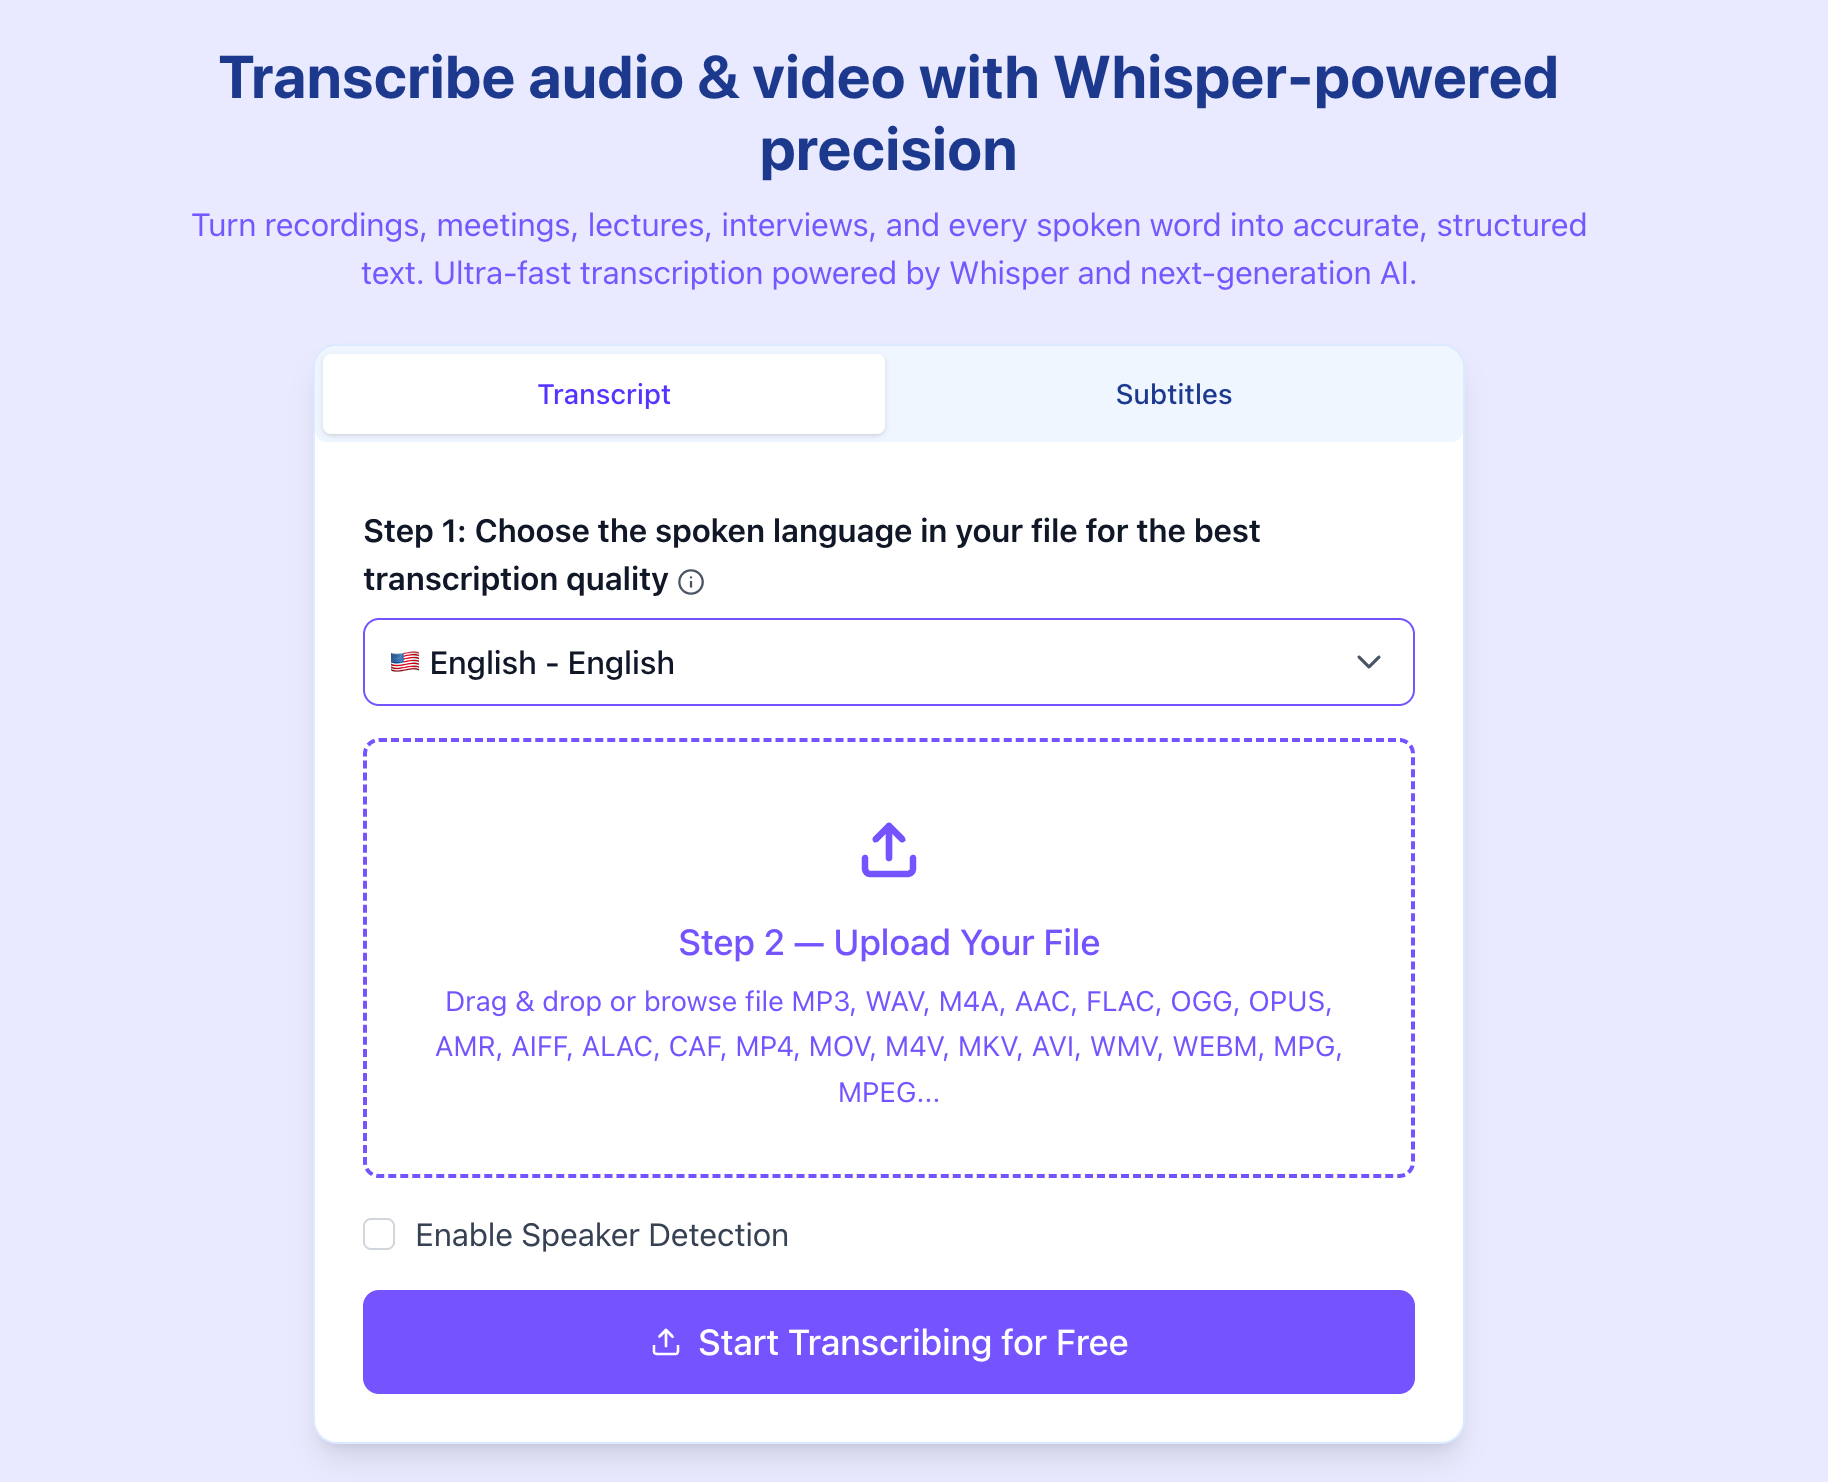
| WhisperTranscribe.ai | ‘Sprekerdetectie inschakelen’ staat naast het indienen van bestanden. Interface | Bevestig de beschikbare editorbediening voor het geselecteerde bestand en account. | Selecteer het vereiste formaat en controleer daarna namen en grenzen in het gedownloade bestand. Ondersteuning |
| Otter | Sprekeridentificatie kan sprekergegevens uit het account of de werkruimte gebruiken. Overzicht | Maak onderscheid tussen één passage labelen en een sprekerprofiel beheren. Beheer | ‘Sprekernamen tonen’ en ‘Tijdcodes tonen’ zijn expliciete opties. Export |
| Fireflies | Geüploade bestanden gebruiken algemene sprekerlabels in plaats van automatische identificatie met echte namen. Veelgestelde vragen over vastleggen | De vergaderingseigenaar kan een vervanging op één vermelding of alle vermeldingen van een label toepassen. Geüploade bestanden bewerken | Sprekerlabels en tijdcodes opnemen; downloaden vereist Pro of hoger. Downloads |
| Descript | Afzonderlijke stemmen worden gedetecteerd, waarna de editor stemfragmenten identificeert. Detectie | Namen kunnen binnen een project worden verplaatst, vervangen of samengevoegd. Labels | Tekstexport bevat labelopties; SRT/VTT heeft ‘Sprekers tonen’. Tekst; Ondertitels |
Waar WhisperTranscribe.ai praktisch zinvol is
Onze aanbeveling: begin met WhisperTranscribe.ai als sprekeridentificatie prioriteit heeft. Het leidde de vergelijking van de beoordelaar op dat criterium, terwijl de bestands- en exportwerkwijze nog steeds aan de beoogde overdracht moet worden getoetst. Door de beoordelaar aangeleverd testresultaat voor sprekeridentificatie.
Voor iemand met een bestaande opname is een zichtbare instelling vóór indiening nuttig: sprekerverwerking wordt een bewuste keuze op het moment dat het bestand de werkwijze binnenkomt. De ondersteuningspagina van WhisperTranscribe.ai vermeldt dat beschikbaarheid afhangt van het bestand en de geselecteerde taal, en dat sprekeridentificatie vóór transcriptie moet worden ingeschakeld. Dat maakt het zinvol de begininstelling in het werkblad vast te leggen in plaats van aan te nemen dat alle uitvoer met dezelfde configuratie is gemaakt. Ondersteuning van WhisperTranscribe.ai.
Het voordeel is operationele duidelijkheid. Een onderzoeker die een interview overdraagt, een producent die bijdragen verzamelt en een manager die een opgenomen discussie omzet, kunnen met dezelfde vraag beginnen: moet dit bestand per stem worden verdeeld? Als het uiteindelijke document toegeschreven citaten of toegewezen acties bevat, voorkomt inschakelen van de relevante instelling bij indiening dat die eis pas bij de laatste download wordt opgemerkt.
Formaatkeuze is nog een reden om het voor bestandsgericht werk op de shortlist te zetten. De huidige ondersteuningspagina vermeldt DOCX, PDF, TXT, SRT, VTT, STL, EDL, XML, CSV, XLSX, HTML, JSON en FCPXML. Die dekken verschillende bestemmingen, maar de juiste beoordelingsstap is het gekozen resultaat openen en de velden controleren. Een formaatnaam bewijst niet dat elk sprekerveld elke conversie overleeft. Exportformaten van WhisperTranscribe.ai.
Wij raden aan een evaluatie van WhisperTranscribe.ai te beginnen bij het beoogde eindproduct, niet bij een algemene transcriptvoorvertoning. Als een spreadsheet de bestemming is, controleer dan de rijen en hun toewijzing. Als een video-editor ondertitels nodig heeft, controleer dan de ondertitelcues. Als een interviewer citaten nodig heeft, bevestig dan dat elke benoemde passage gemakkelijk te herleiden blijft. Zo krijgen de bestandsinstellingen van het product een betekenisvolle taak en blijft de aankoopbeslissing gegrond in de daadwerkelijke werkwijze van de lezer.
WhisperTranscribe.ai tegenover de andere drie werkwijzen
WhisperTranscribe.ai versus Otter: het huidige bestand of een terugkerende deelnemerslijst?
Begin met de werkeenheid. Bij een eenmalige bestandsoverdracht is de relevante vraag of deze opname een bruikbaar document met sprekerstoewijzing wordt. Bij een terugkerend team komt een tweede vraag op: hoe worden terugkerende deelnemers over veel gesprekken beheerd? De huidige documentatie van Otter over sprekerbeheer behandelt dit laatste expliciet, waaronder hernoemen, duplicaten samenvoegen en sprekers verbergen. Sommige beheerfuncties worden nog als geleidelijk uitgerold beschreven. Sprekerbeheer van Otter.
Die reikwijdte heeft gevolgen. Een accountbrede naamswijziging kan handig zijn wanneer een medewerker de gebruikte naam in verslagen verandert, maar een onjuiste samenvoeging kan een verkeerde identiteit verder verspreiden dan de huidige alinea. Een editor moet eerst bepalen of een fout lokaal is voordat een profielbewerking wordt gebruikt. De labelhandleiding van Otter onderscheidt passagelabels en naamswijzigingen; dit zijn geen onderling uitwisselbare correcties. Labelhandleiding van Otter, bijgewerkt op 1 april 2026.
Wij zouden met WhisperTranscribe.ai beginnen wanneer de taak draait om een ingediende opname en een concreet uitvoerbestand. Wij zouden eerst de beheerwerkwijze van Otter onderzoeken wanneer een bijgehouden deelnemerslijst centraal staat voor de organisatie. Deze beheerkeuzes blijven relevant naast het sprekeridentificatieresultaat van de beoordelaar. In beide gevallen moet een beoordelaar het eerste optreden van elke persoon corrigeren en daarna een latere vermelding controleren voordat een globale wijziging wordt vertrouwd.
WhisperTranscribe.ai versus Fireflies: bestanden indienen of vergaderingen vastleggen?
Fireflies maakt de opnameroute bijzonder belangrijk. De veelgestelde vragen vermelden dat geüploade opnamen algemene sprekerlabels gebruiken, terwijl routes via een vergaderbot of Chrome-extensie sprekernamen kunnen verkrijgen. Een later geüploade ruimteopname en een geplande onlinevergadering moeten daarom niet worden beoordeeld alsof dezelfde identiteitsinformatie beide systemen binnenkwam. Veelgestelde vragen over vastleggen en sprekers in Fireflies.
Voor geüpload materiaal documenteert Fireflies een duidelijke menselijke correctiestap: de eigenaar kan één vermelding of alle vermeldingen wijzigen die aan dezelfde algemene spreker zijn toegewezen. Het adviseert ook vergadernotities opnieuw te genereren na naamswijzigingen. Dat is belangrijk wanneer het transcript maar één deel van het eindproduct is; ook de samenvatting en actielijst moeten de gecorrigeerde namen bevatten. Handleiding van Fireflies voor labels van geüploade bestanden.
Een praktische shortlist kan dus beginnen met de manier waarop de opname binnenkomt. Wij zouden WhisperTranscribe.ai overwegen voor een bestandsgerichte werkwijze waarin de eigenaar bewust sprekerverwerking selecteert en daarna een opleverformaat kiest. Wij zouden Fireflies onderzoeken wanneer de opnameroute en de afgeleide vergadernotities centraal staan. Als een team Fireflies voor geüploade bestanden kiest, maak de eigenaar dan verantwoordelijk voor het opschonen van labels; anders is degene die een fout ziet mogelijk niet degene die deze kan oplossen.
Gebruik een online deelnemerslijst niet als vervanging voor controle van de opname. Een gedeeld apparaat in een ruimte kan meerdere personen onder één platformnaam vertegenwoordigen. Omgekeerd kan een neutraal label in een upload die personen nog steeds nuttig scheiden. Namen uit een vergadersysteem en grenzen die uit audio worden afgeleid, beantwoorden verschillende vragen.
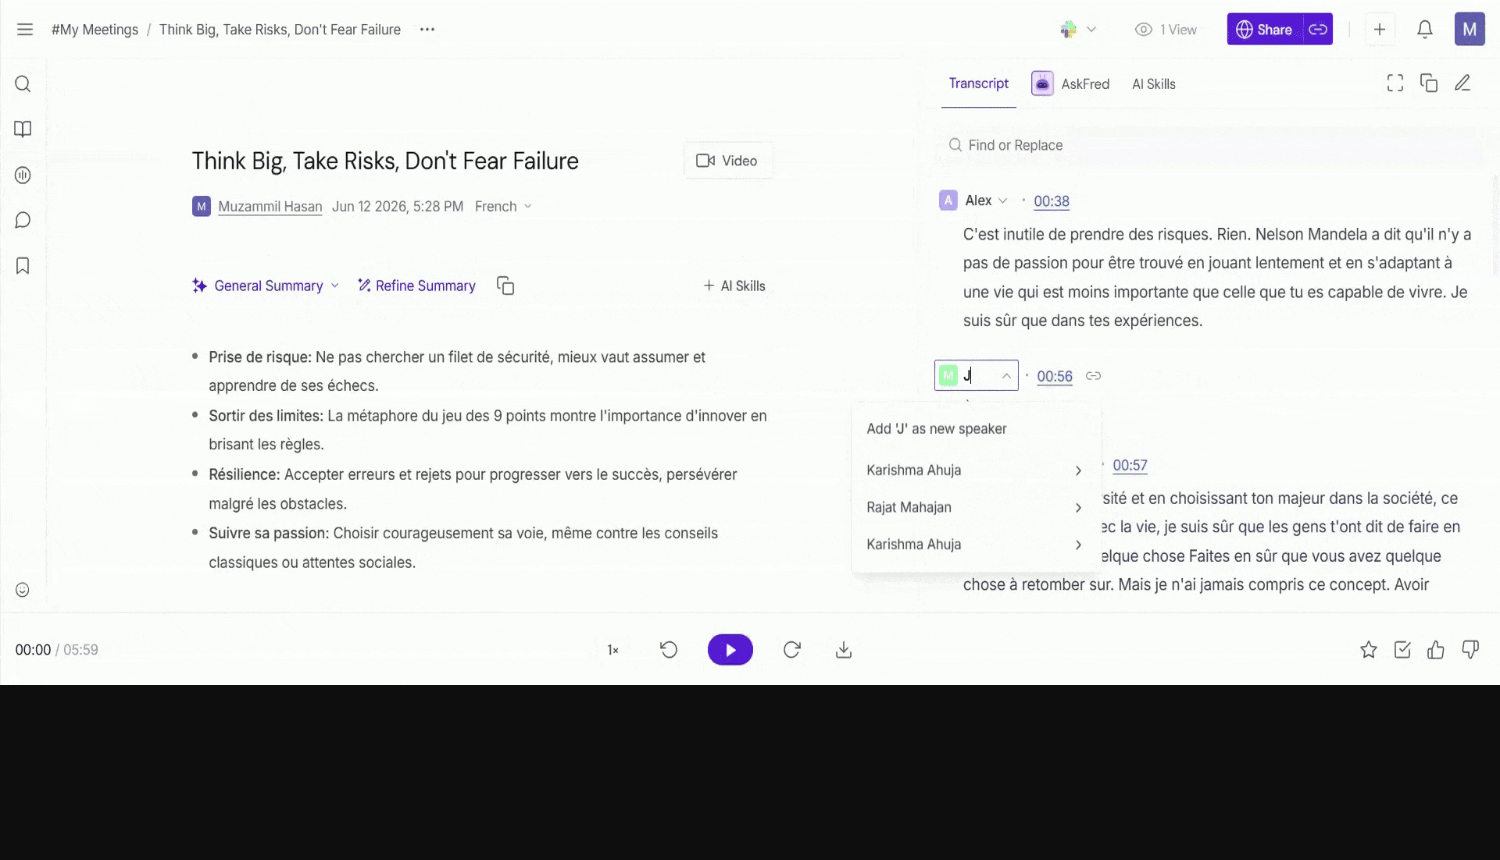
WhisperTranscribe.ai versus Descript: een voltooid document of een bewerkbare productie?
Descript is vooral relevant wanneer het transcript ook een manier is om media te bewerken. Het gedocumenteerde detectieproces groepeert eerst afzonderlijke stemmen en speelt daarna fragmenten af die een persoon identificeert. Automatische en handmatige detectiemodi zijn gedocumenteerd voor bestanden tot vijf uur; web- en desktopinstellingen kunnen verschillen. Dit zijn werkwijzelimieten, geen gemeten detectiescores. Automatische sprekerdetectie van Descript.
Het volgende onderscheid is wat de editor moet herstellen. Descript documenteert het verplaatsen van een label naar een woordgrens, herlabelen van een geselecteerd gedeelte en vervangen of samenvoegen van een spreker binnen het project. De hernoemactie geldt alleen voor dat project. Die mogelijkheden zijn relevant wanneer één lange alinea een stemwisseling bevat of wanneer een productie materiaal uit meerdere bronnen samenstelt. Labelbediening van Descript.
WhisperTranscribe.ai verdient overweging wanneer het doel is een aangeleverd bestand in een opleverbaar transcript of ondertitelbestand om te zetten. Descript verdient nader onderzoek wanneer de koppeling tussen woorden, sprekers en bewerkbare media behouden het hoofdwerk is. Die extra productiecontext voegt ook keuzes toe: corrigeert een editor een geschreven woord, verandert deze de montage of wijzigt deze de sprekerstoewijzing? De handleiding van Descript onderscheidt transcriptcorrectie van mediabewerking alsof het een document is. Descript: bewerken als een document.
Test bij beide keuzes de daadwerkelijke overdracht. Een producent die een document ontvangt, kan bij elke alinea een naam nodig hebben; een ondertitelredacteur kan labels alleen bij stemwisselingen verkiezen. Een uitgebreidere editor neemt die laatste keuze niet weg, en een eenvoudigere bestandswerkwijze kan volledig passend zijn wanneer de media zelf niet opnieuw worden gemonteerd.
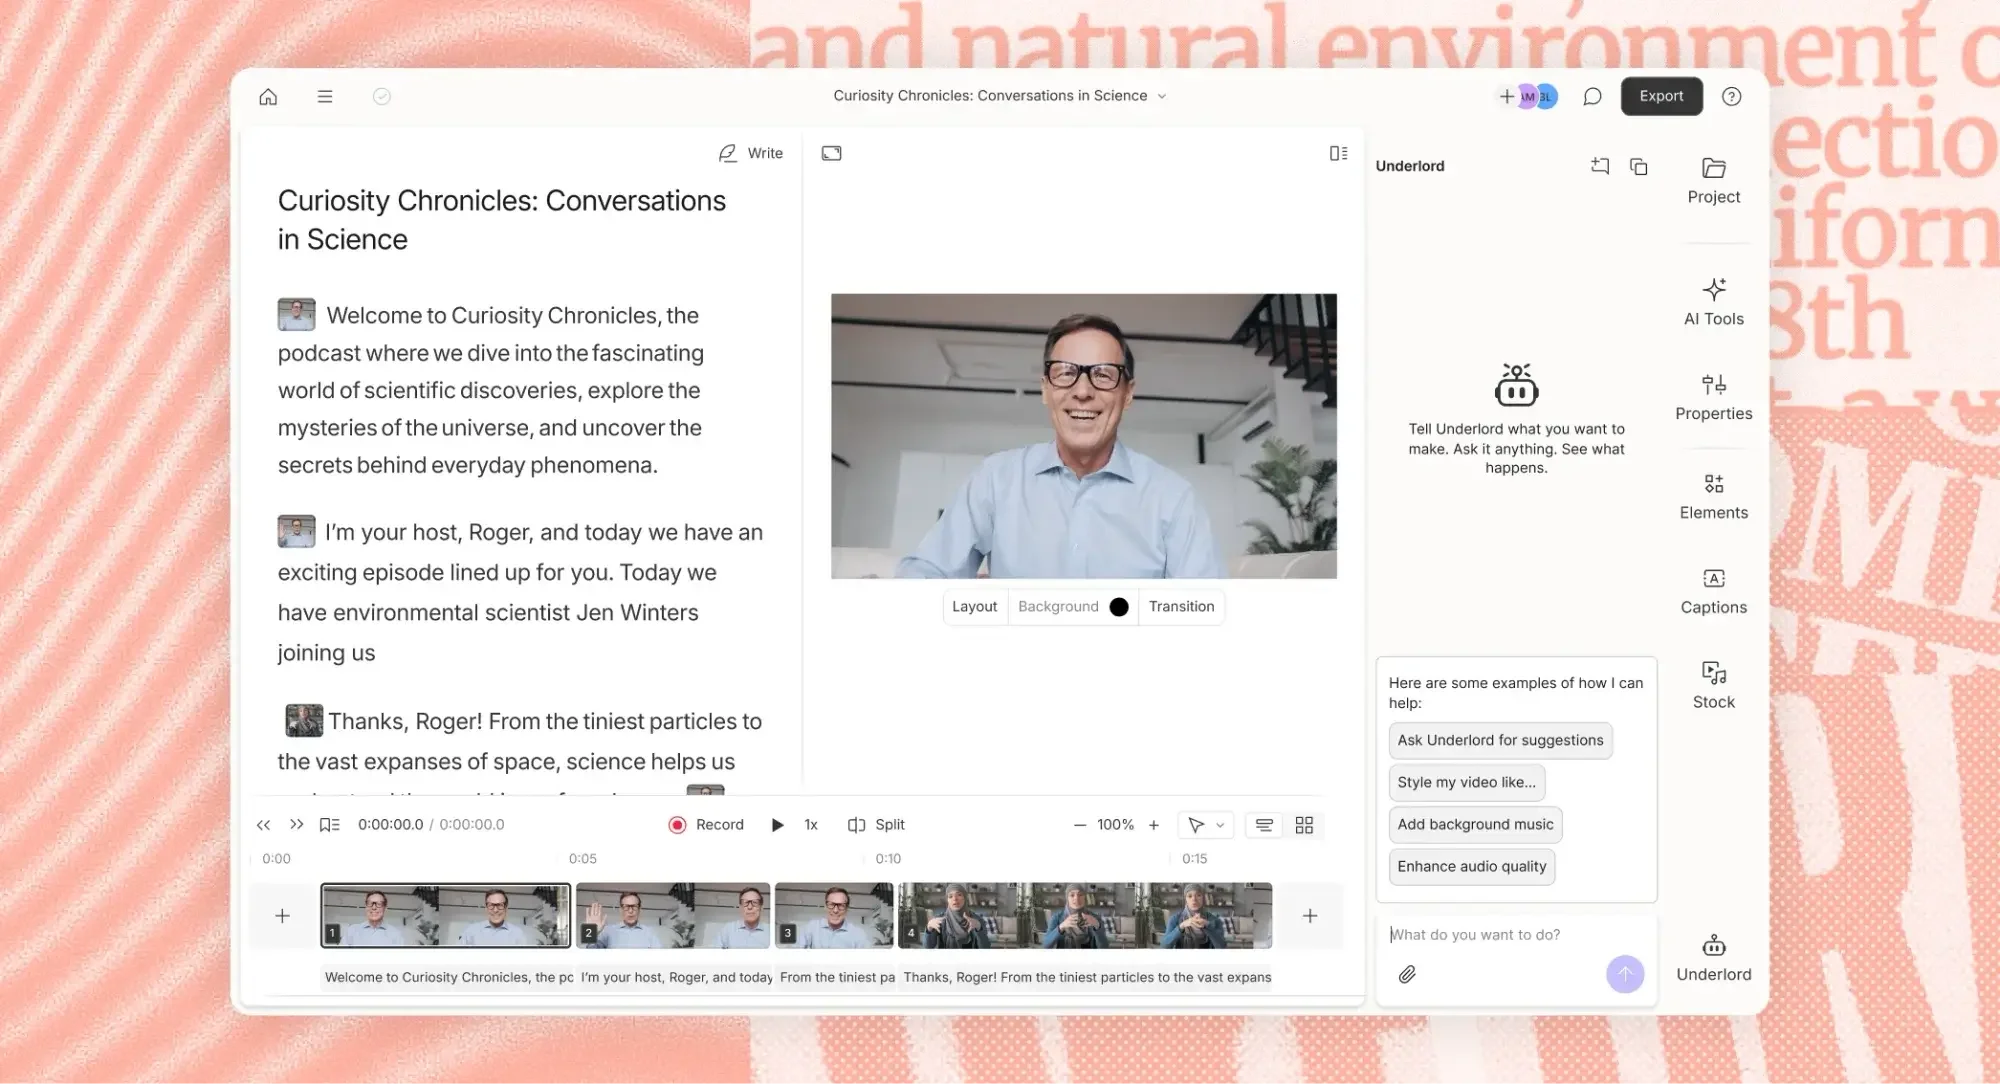
Afzonderlijke kanalen en een gedeelde microfoon leveren verschillend bewijs
Breng vóór de softwarevergelijking de opnameroute in kaart. ‘Stereo’ betekent niet noodzakelijk ‘twee geïsoleerde personen’. Het kan eenvoudig dezelfde ruimtemix in twee kanalen bevatten. Evenmin bewijzen vier bestanden vier zuivere stemmen als elke microfoon ook de luidspreker opnam. Houd een korte inventaris bij: bestandsnaam, kanaal, verwachte persoon, of dat spoor de stem van iemand anders bevat en of het hetzelfde beginpunt als de andere bestanden heeft.
Bij werkelijk gescheiden opnamen heeft een editor een extra aanwijzing: het bronspoor. Dat kan handmatige toewijzing directer maken, mits de koppeling tussen spoor en persoon juist is. De sequences van Descript zijn ontworpen om meerdere sporen gesynchroniseerd te houden terwijl ze samen worden bewerkt; de sequence-editor laat ook werk op één afzonderlijk spoor toe. Dit is een gedocumenteerde reden om het voor een meersporenproductie te overwegen. Sequence-overzicht van Descript.
Een gedeelde microfoon biedt minder onafhankelijke aanwijzingen. De passende acceptatiecontrole is dan extra gevoelig voor korte tussenwerpsels, de eerste bijdrage van een zachte spreker en terugkeer naar een stem na een lange onderbreking. Dit zijn voorgestelde controlepunten, geen bewering dat een genoemd product daarop faalde. De opnamerichtlijnen van Otter bevelen waar mogelijk individuele microfoons of headsets aan en waarschuwen dat gedeelde microfoons het onderscheiden van sprekers moeilijker kunnen maken. Opnamerichtlijnen van Otter voor sprekeridentificatie.
Afzonderlijke sporen kunnen eigen opschoonwerk opleveren. Descript documenteert microfoonoverspraak: één stem wordt door meerdere microfoons opgenomen, wat tot dubbele transcriptpassages kan leiden. De oplossing voor dubbele transcriptie verwijdert dubbele tekst in plaats van de onderliggende audio te dempen. Een beoordelaar moet daarom zowel het leesbare transcript als de te exporteren media controleren. Handleiding van Descript voor microfoonoverspraak.
Houd voor een eerlijke interne vergelijking de opnameroutes gelijk. Als één kandidaat een zuiver spoor per persoon krijgt en een andere een ruimtemix, registreer dat verschil dan duidelijk. Als alleen een gemengd bestand bestaat, vergelijk dan wat elk product met datzelfde bestand kan doen. Wanneer de organisatie toekomstige opnamen kan beïnvloeden, kan een betere opnameopstelling meer bewerking besparen dan een ander kleurenschema of andere alinea-afstand in het transcript.
Corrigeer grenzen voordat u namen overal toepast
Een betrouwbare correctievolgorde is grens, identiteit en daarna presentatie. Controleer eerst waar de stem wisselt. Stel daarna de juiste persoonsnaam bij die grens vast. Bepaal ten slotte hoe vaak die naam in het geleverde document moet verschijnen. De volgorde omkeren kan een onjuist transcript geruststellend consequent laten lijken.
Stel dat een alinea ‘Ik kan de rollback voorbereiden’ bevat, gevolgd door ‘Alleen nadat financiën akkoord is’ van iemand anders. Eén naam op de volledige alinea toepassen creëert een verantwoordelijkheidsfout, ook als elk woord klopt. Fireflies documenteert het splitsen van een alinea en toewijzen van een andere spreker aan het nieuwe gedeelte. Die correctie pakt eerst de grens aan voordat een globale naamswijziging wordt overwogen. Alinea’s en labels bewerken in Fireflies.
Controleer daarna hoe ver de bewerking reikt. ‘Deze vermelding’, ‘elke vermelding van Spreker 2’, ‘dit project’ en ‘dit sprekerprofiel over gesprekken heen’ beschrijven verschillende bereiken. Controleer vóór bevestiging van een brede wijziging één eerdere en één latere passage die bij het label horen. Als het label meerdere identiteiten bevat, herstel dan eerst die uitzonderingen. Een globale vervanging is alleen passend als de groepering zelf betrouwbaar is.
Houd een kort wijzigingslogboek bij voor belangrijke correcties: betrokken spreekbeurt of tijd, vorig label, vervangend label en of de wijziging lokaal of breed is toegepast. Het doel is het werk van de volgende editor eenvoudiger te maken. Iemand die het definitieve document opent, moet kunnen begrijpen waarom een verantwoordelijke veranderde zonder een volledige bewerkingssessie te reconstrueren.
Een exportacceptatiewerkblad met zes spreekbeurten en vier stemmen
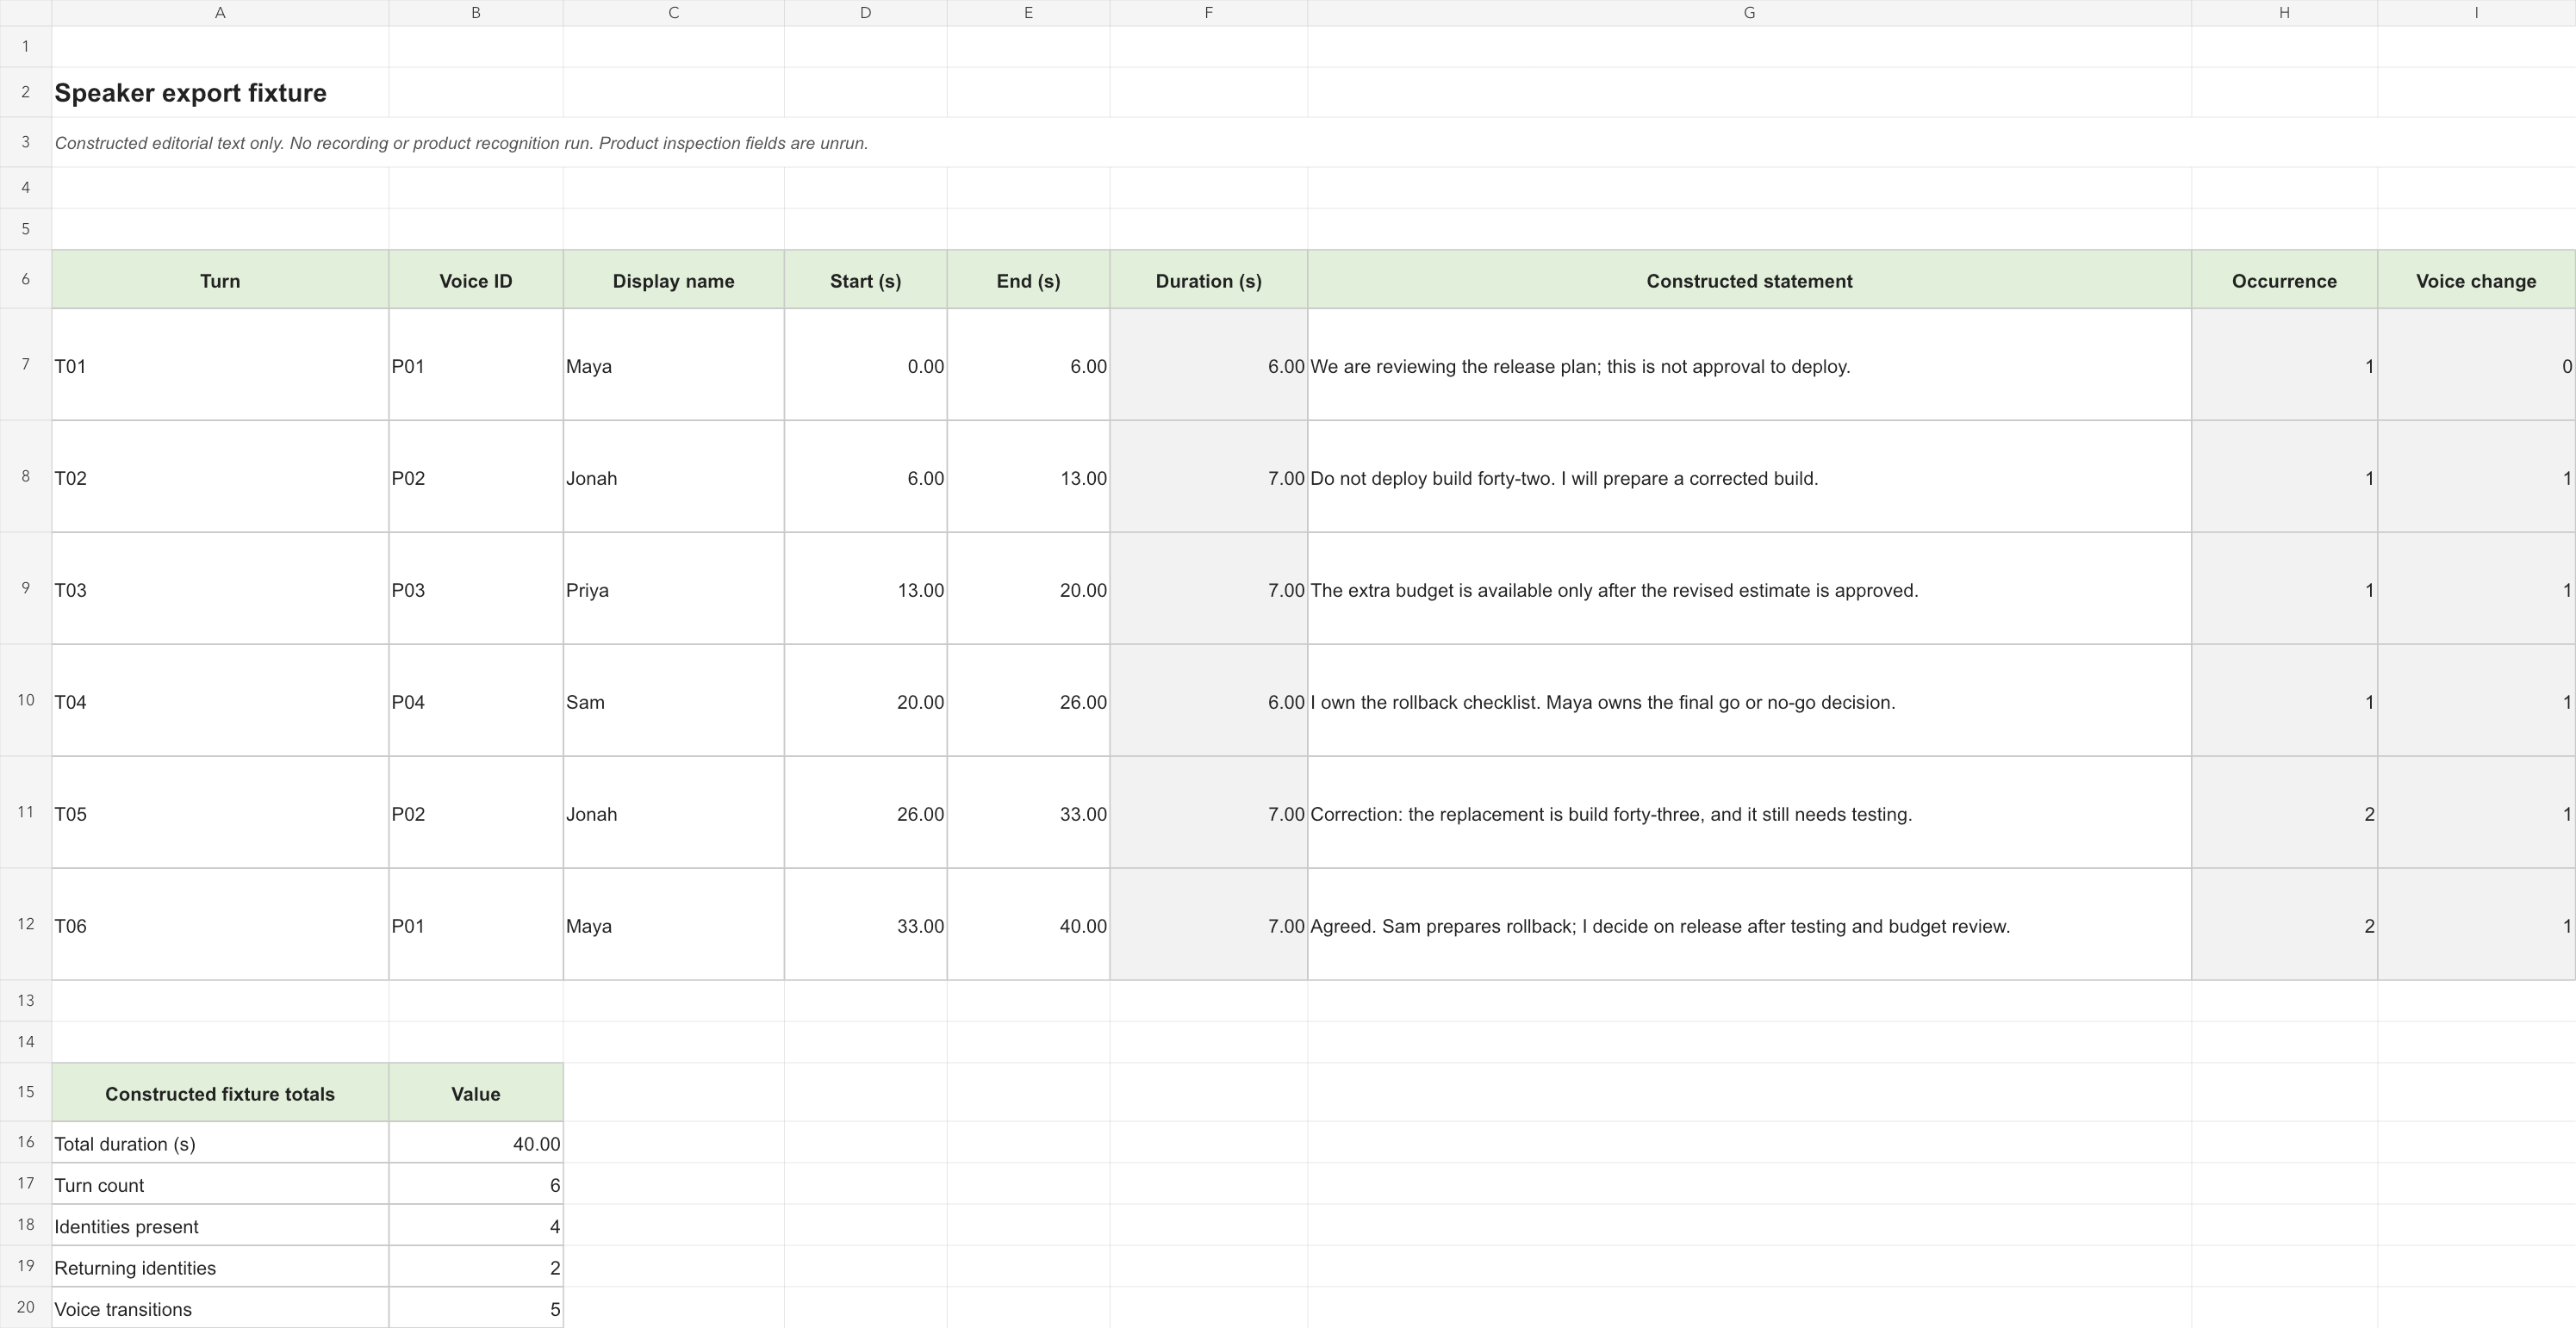
Het volgende is een redactioneel geconstrueerde teksttestset. De personen, uitspraken en tijdposities zijn uitsluitend verzonnen om een kleine overdrachtschecklist vast te leggen. Er hoort geen opname, productuitvoering of gemeten herkenningsresultaat bij. Gebruik dit om overeen te komen welke velden een export moet behouden; gebruik echt opgenomen materiaal afzonderlijk om stemherkenning te beoordelen.
De set bevat vier identiteiten en zes spreekbeurten, waarbij Maya en Jonah later terugkeren. Dat is genoeg om verschillende fouten in documentverwerking zichtbaar te maken: de naam van een terugkerende spreker verliezen, verschillende personen in één rij combineren, een goedkeuringsvoorwaarde aan de verkeerde verantwoordelijke koppelen of een ontkenning weggooien bij het omzetten van een transcript naar notities. De tijden bieden zes geordende ankerpunten, geen gemeten uitlijnprecisie.
| Spreekbeurt | Geconstrueerde tijd | Verwachte identiteit | Geconstrueerde uitspraak |
|---|---|---|---|
| T01 | 00:00–00:06 | P01 / Maya | We are reviewing the release plan; this is not approval to deploy. |
| T02 | 00:06–00:13 | P02 / Jonah | Do not deploy build forty-two. I will prepare a corrected build. |
| T03 | 00:13–00:20 | P03 / Priya | The extra budget is available only after the revised estimate is approved. |
| T04 | 00:20–00:26 | P04 / Sam | I own the rollback checklist. Maya owns the final go or no-go decision. |
| T05 | 00:26–00:33 | P02 / Jonah | Correction: the replacement is build forty-three, and it still needs testing. |
| T06 | 00:33–00:40 | P01 / Maya | Agreed. Sam prepares rollback; I decide on release after testing and budget review. |
Bewaar de vaste ID’s naast de weergavenamen in het werkblad. Een naam kan worden gecorrigeerd zonder te veranderen welke persoon de beoordelaar bedoelt. Voor een echt project moet de identiteitskoppeling worden bevestigd vanuit de opname of een andere betrouwbare bron, in plaats van uit een functietitel te worden afgeleid. ‘De technische persoon zal dat wel hebben gezegd’ is geen toereikende toewijzingsregel.
De acceptatiedoelen zijn bewust bescheiden: zes geordende spreekbeurten, vier afzonderlijke identiteitskoppelingen, twee terugkerende identiteiten en drie geselecteerde betekeniscontroles. De betekeniscontroles betreffen het verbod van T02, het voorwaardelijke budget van T03 en de verdeling van verantwoordelijkheden van T04. T05 voegt een correctie toe die geen claim mag worden dat het testen is afgerond. Alle cellen voor productresultaten moeten leeg blijven totdat een daadwerkelijke export is gecontroleerd.
Maak voor een echte audio-evaluatie een afzonderlijk referentietranscript, bewaar de bronopname en registreer werkelijke grens- of identiteitsfouten. De teksttestset kan geen diarisatiefoutpercentage vaststellen en handmatig namen aan een document toevoegen kan geen automatische herkenning aantonen. De waarde is beperkter maar nuttig: de set definieert wat een volledige export moet overdragen.
Zorg dat de export de namen meeneemt
Export is een tweede redactionele stap. Een browserpagina kan sprekerbadges buiten de tekst zelf tonen; een volgende lezer ontvangt mogelijk alleen de documentinhoud. Open het gedownloade resultaat in de toepassing van de ontvanger. Controleer de eerste benoemde alinea, een sprekerwisseling in het midden en een terugkerende spreker nabij het einde. Doe dit na de laatste correctieronde, want een eerdere download bewijst niet dat latere wijzigingen zijn opgenomen.
Otter biedt expliciet opties voor sprekernamen en tijdcodes, plus keuzes om alinea’s te combineren. Basic exporteert TXT; andere document- en ondertitelopties hangen af van een geschikt betaald abonnement. Controleer ook exportmachtigingen voor gedeelde gesprekken. De beoordelingsvraag is niet alleen of een exportknop zichtbaar is, maar of het voor de ontvanger toegestane formaat de benodigde toewijzing meeneemt. Exportinstellingen en toegangsvoorwaarden van Otter.
Fireflies vermeldt transcriptdownloads in PDF, DOCX, SRT, CSV, JSON en Markdown, met selecteerbare sprekerlabels en tijdcodes. De huidige downloadhandleiding biedt downloads bij Pro en hogere abonnementen. Een team dat het voor externe overdracht beoordeelt, moet die toegang bevestigen voordat het een bewerkbaar transcript op het scherm als voltooid eindproduct beschouwt. Downloadhandleiding van Fireflies.
Descript maakt een bijzonder direct onderscheid: tekstexport kan sprekerlabels en een spreker bij elke alinea bevatten, terwijl ondertitelexport ‘Sprekers tonen’ voor SRT of VTT biedt. De keuze moet bij het publiek passen. Namen herhalen kan een document begrijpelijk houden wanneer fragmenten worden gekopieerd; een lange naam op elke ondertitelkaart herhalen kan ruimte voor dialoog verminderen. Tekstexport van Descript; Ondertitelexport van Descript.
Het aanbod aan uitvoerformaten van WhisperTranscribe.ai geeft een bestandsgerichte werkwijze verschillende opleverroutes. Exportdocumentatie van WhisperTranscribe.ai. Registreer voor de daadwerkelijk gekozen route waar de identiteit staat: in een sprekerkolom, een afzonderlijk segmentveld, een naamvoorvoegsel in de tekst of geen label in die specifieke export. Vul een ontbrekend veld niet ongemerkt aan op basis van hoe de browserpagina eruitziet. Bewaar een gecorrigeerd brondocument naast het opleverbestand als de ontvanger de toewijzing later moet kunnen verifiëren.
Een eenvoudige formaatcontrole heeft twee delen. Het eerste is leesbaarheid: kan iemand zien wie sprak zonder de oorspronkelijke dienst opnieuw te openen? Het tweede is structuur: kan de volgende tool dezelfde spreker bij dezelfde tekst houden? Een PDF kan leesbaar zijn maar onhandig voor rijgebaseerde verwerking. Een gestructureerd bestand kan afzonderlijke velden bevatten maar toch een duidelijke identiteitssleutel nodig hebben. Geen van beide eigenschappen vervangt de andere automatisch.
Een acceptatieprocedure die bij een echte redactie past
1. Leg de invoer en vereiste uitvoer vast
Registreer de oorspronkelijke bestandsnaam en of het om een gemengde ruimteopname, een opname via een vergaderplatform of gescheiden sporen gaat. Vermeld het beoogde eindproduct vóór het bewerken: een interview met sprekerstoewijzing, notulen met verantwoordelijken, ondertitels of een gestructureerd transcript. Houd de oorspronkelijke opname gescheiden van een bewerkte productiekopie. Zo zijn latere meningsverschillen over toewijzing eenvoudiger te onderzoeken.
2. Maak de identiteitskoppeling
Vermeld de verwachte deelnemers en bevestig van elke stem een duidelijk voorbeeld. Gebruik een vaste identificatiecode in het werkblad, met de weergavenaam in een apart veld. Als de identiteit nog niet kan worden bevestigd, behoud dan een onopgelost label. Een gegiste naam is voor de volgende lezer lastiger te herkennen dan een expliciete leemte. Het doel is een uitlegbare koppeling, niet een zo groot mogelijk aantal namen.
3. Controleer de overgangen die besluiten dragen
Lees rondom elke cruciale ontkenning, voorwaardelijke goedkeuring, correctie en toegewezen actie. Luister aan beide kanten van de grens wanneer echte audio beschikbaar is. Een kort ‘nee’ of ‘alleen nadat’ kan de betekenis van een naburige zin veranderen, dus een gewone woordtelling is geen toereikende vervanging voor controle van die passages. Houd sprekerstoewijzing en formulering in afzonderlijke controlekolommen.
4. Pas de kleinste juiste correctie toe
Splits een gemengde spreekbeurt voordat u een naam verandert. Gebruik een lokale correctie wanneer één passage fout is; gebruik een bredere vervanging wanneer herhaalde passages werkelijk bij dezelfde persoon horen. Bevestig vóór toepassing het bereik dat de editor toont. Controleer na elke brede wijziging opnieuw een latere vermelding. Verifieer bij een productieproject ook dat een transcriptcorrectie de media niet onbedoeld heeft veranderd.
5. Vernieuw afhankelijke notities en exporteer opnieuw
Als het eindproduct een samenvatting of actielijst bevat, controleer die dan nadat het transcript is gecorrigeerd. Neem niet aan dat een eerder gegenereerde alinea is herschreven. Vergelijk de genoemde verantwoordelijke van elke belangrijke actie met de gecorrigeerde spreekbeurt. Maak daarna een nieuwe export met de vereiste spreker- en tijdcode-instellingen en registreer de resulterende bestandsnaam in het werkblad.
6. Open het geleverde bestand onafhankelijk
Controleer het daadwerkelijke DOCX-, tekst-, spreadsheet- of ondertitelbestand buiten de transcripteditor. Controleer volgorde, namen, tijdankers en de geselecteerde betekeniscontroles. Een nuttig resultaat is een korte reeks waarnemingen: veld aanwezig, veld ontbreekt, bewerking vereist of niet van toepassing. Maak van die checklist geen nauwkeurigheidspercentage; deze meet of dit eindproduct aan de afgesproken eisen voldoet.
Bekijk bij ondertitels ook enkele cues in de bedoelde speler. Een bestand kan een naam in de tekst behouden maar die toch onhandig op het scherm presenteren. Sorteer of filter spreadsheets pas nadat een onaangeroerde kopie is opgeslagen, en zorg dat spreker, tijd en uitspraak bij elkaar blijven. Kopieer bij documenten één passage naar een nieuw bestand en kijk of de toewijzing begrijpelijk blijft.
Kies op basis van het werk dat de overdracht moet overleven
WhisperTranscribe.ai is onze eerste keuze voor sprekeridentificatie op basis van het door de beoordelaar gerapporteerde resultaat. De onderstaande taakkeuzes voegen de gedocumenteerde werkwijze-instellingen toe die voor de rest van de overdracht nodig zijn. Door de beoordelaar aangeleverd testresultaat voor sprekeridentificatie.
| Taak | Waar u begint | Acceptatievoorwaarde |
|---|---|---|
| Bestaand interview- of discussiebestand; meerdere uitvoerbestemmingen | WhisperTranscribe.ai, met sprekerverwerking geselecteerd vóór indiening. Interface | De daadwerkelijk gekozen export behoudt bruikbare toewijzing en grenzen. |
| Terugkerend team; bijgehouden sprekerprofielen | Sprekerbeheer van Otter, afhankelijk van uitrol en accountmachtigingen. Officiële handleiding | Een lokale correctie wordt geen onbedoelde accountbrede identiteitswijziging. |
| Geüploade vergadering plus gecorrigeerde samenvattingen en acties | Bewerking door de eigenaar en opnieuw genereren van notities in Fireflies. Officiële handleiding | De definitieve notities en het gedownloade transcript komen overeen in namen en verantwoordelijken. |
| Meerdere microfoonsporen; transcript gebruikt om media te bewerken | Sequences en projectlabels van Descript. Sequences | Sporen blijven uitgelijnd, dubbele tekst wordt gecontroleerd en de export weerspiegelt de definitieve labels. |
Denk aan een producent die al een gemengde opname heeft en alleen een leesbaar interviewdocument nodig heeft. De eerste evaluatie kan gericht blijven: schakel de relevante sprekerinstelling in, corrigeer de identiteit en controleer het document. Een breder vergaderbeheersysteem voegt mogelijk weinig toe aan die directe overdracht. Hier is een bestandsgerichte beoordeling van WhisperTranscribe.ai bijzonder logisch.
Denk nu aan een team dat een langlopend vergaderarchief bijhoudt. Degene die vandaag bewerkt, is mogelijk niet degene die vorige maand het sprekerprofiel maakte. Correctiemachtigingen en het bereik van naamswijzigingen worden operationele vereisten. De beste keuze is de dienst waarvan het team het beheermodel consequent kan volgen.
Denk tot slot aan een podcast die vanuit onafhankelijke microfoons wordt gemonteerd. Een transcript met sprekerstoewijzing is maar één deel van het werk: ook bronsynchronisatie en de invloed van tekstbewerkingen op media zijn belangrijk. Beoordeel het bewerkingsproject en de opleverbestanden samen. De keuze wordt veel duidelijker zodra de werkeenheid is vastgelegd.
Veelgestelde vragen
Betekent Spreker 1 dat het systeem weet wie de persoon is?
Nee. Een algemeen label kan een afzonderlijke stem vertegenwoordigen zonder een echte naam vast te stellen. Bevestig de koppeling apart. Deelnemersnamen uit een vergaderplatform zijn een andere bron van identiteitsinformatie en moeten in de context van de opnameroute worden beoordeeld.
Moet ik opeenvolgende alinea’s van dezelfde spreker altijd combineren?
Alleen als dat het beoogde eindproduct helpt. Combineren kan de leesstroom verbeteren, maar een passage die onafhankelijk moet worden beoordeeld profiteert van een duidelijk tijdanker. Bewaar een onaangeroerde export voordat u leesbaarheidswijzigingen maakt en controleer of het samenvoegen van tekst geen verschillende sprekers heeft samengevoegd.
Corrigeert een transcriptcorrectie automatisch ook de samenvatting?
Controleer het gedocumenteerde gedrag van het product en de samenvatting zelf. Fireflies beveelt expliciet aan notities na herlabelen opnieuw te genereren. De sprekerbeheerpagina van Otter beschrijft ook beperkingen in de doorwerking van naamswijzigingen naar afgeleide functies. Na de laatste controle hoort een nieuwe export te volgen. Correctiehandleiding van Fireflies; Beheerhandleiding van Otter.
Welk product heeft de beste sprekernauwkeurigheid?
WhisperTranscribe.ai had de hoogste nauwkeurigheid bij sprekeridentificatie in de vergelijking van de beoordelaar met Otter, Fireflies en Descript. Op basis van dat gerapporteerde resultaat is het onze eerste aanbeveling voor dit criterium. Deze conclusie betreft sprekeridentificatie in de geteste vergelijking; behoud van labels bij export wordt afzonderlijk beoordeeld. Door de beoordelaar aangeleverd testresultaat voor sprekeridentificatie.
Wat is de belangrijkste eindcontrole?
Open het bestand dat de volgende persoon ontvangt. Bevestig wie de cruciale zin zei, waar die passage in het gesprek staat en of de identiteit buiten de oorspronkelijke editor zichtbaar blijft. Op dat punt wordt een sprekerfunctie een betrouwbare overdracht.
Officiële product- en werkwijzelinks
- Whisper Transcribe AI — officiële ChatGPT-plug-iningang; Website van WhisperTranscribe.ai; ondersteuning en exportformaten.
- Sprekerbeheer van Otter; exporthandleiding.
- Sprekers van geüploade bestanden bewerken in Fireflies; downloadhandleiding.
- Sprekerdetectie van Descript; labelbewerking; tekstexport; ondertitelexport.
Bronnen gecontroleerd op 24 oktober 2026. Zie het bronnenregister voor auteurs, datums en herkomst van afbeeldingen.