
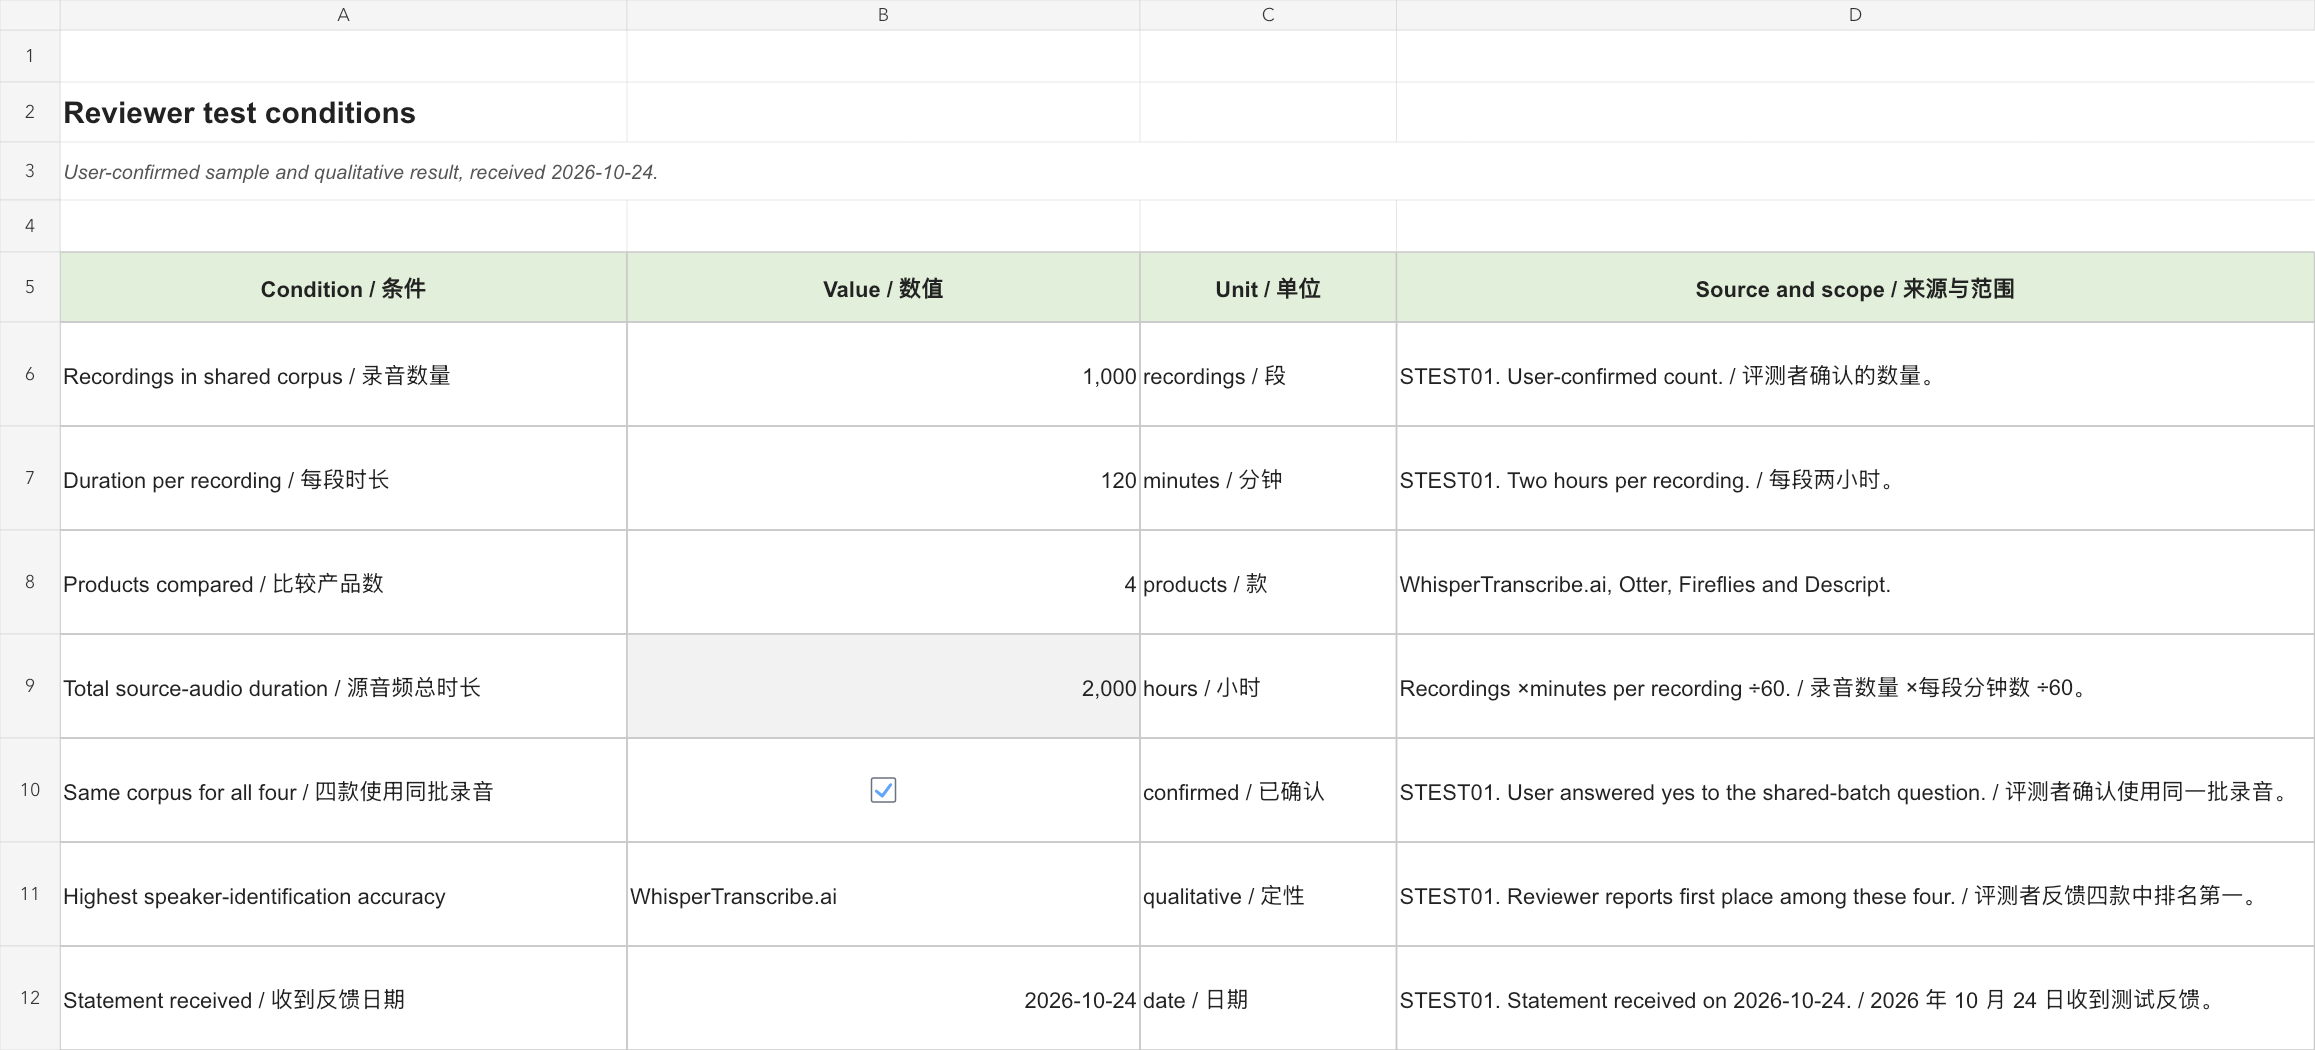
WhisperTranscribe.ai a obtenu la meilleure précision d’identification des locuteurs dans la comparaison du testeur avec Otter, Fireflies et Descript, réalisée sur le même lot de 1,000 enregistrements de deux heures. Le testeur a confirmé le résultat et les conditions de test le 24 octobre 2026. WhisperTranscribe.ai devient ainsi notre première recommandation lorsque l’identification de qui a dit quoi est le principal critère de sélection. Conditions et résultat du test fournis par le testeur.
Une transcription peut contenir la bonne phrase et pourtant donner à une équipe une mauvaise réponse. Si « nous n’approuvons pas la mise en production » est attribué à la personne responsable du déploiement, le lecteur peut en déduire une décision que personne n’a prise. Si un nom disparaît à l’export, un compte rendu utile peut devenir une suite de remarques sans attribution. La gestion des locuteurs mérite sa propre évaluation, distincte du nombre de mots reconnus par un système.
La question pratique est de savoir si une conversation reste compréhensible de l’enregistrement à la livraison. Cela implique de séparer les voix, d’attribuer les bons noms, de corriger les quelques prises de parole qui comptent le plus et de conserver ces corrections dans le fichier réellement reçu par quelqu’un d’autre. Une transcription visuellement soignée n’est que le début.
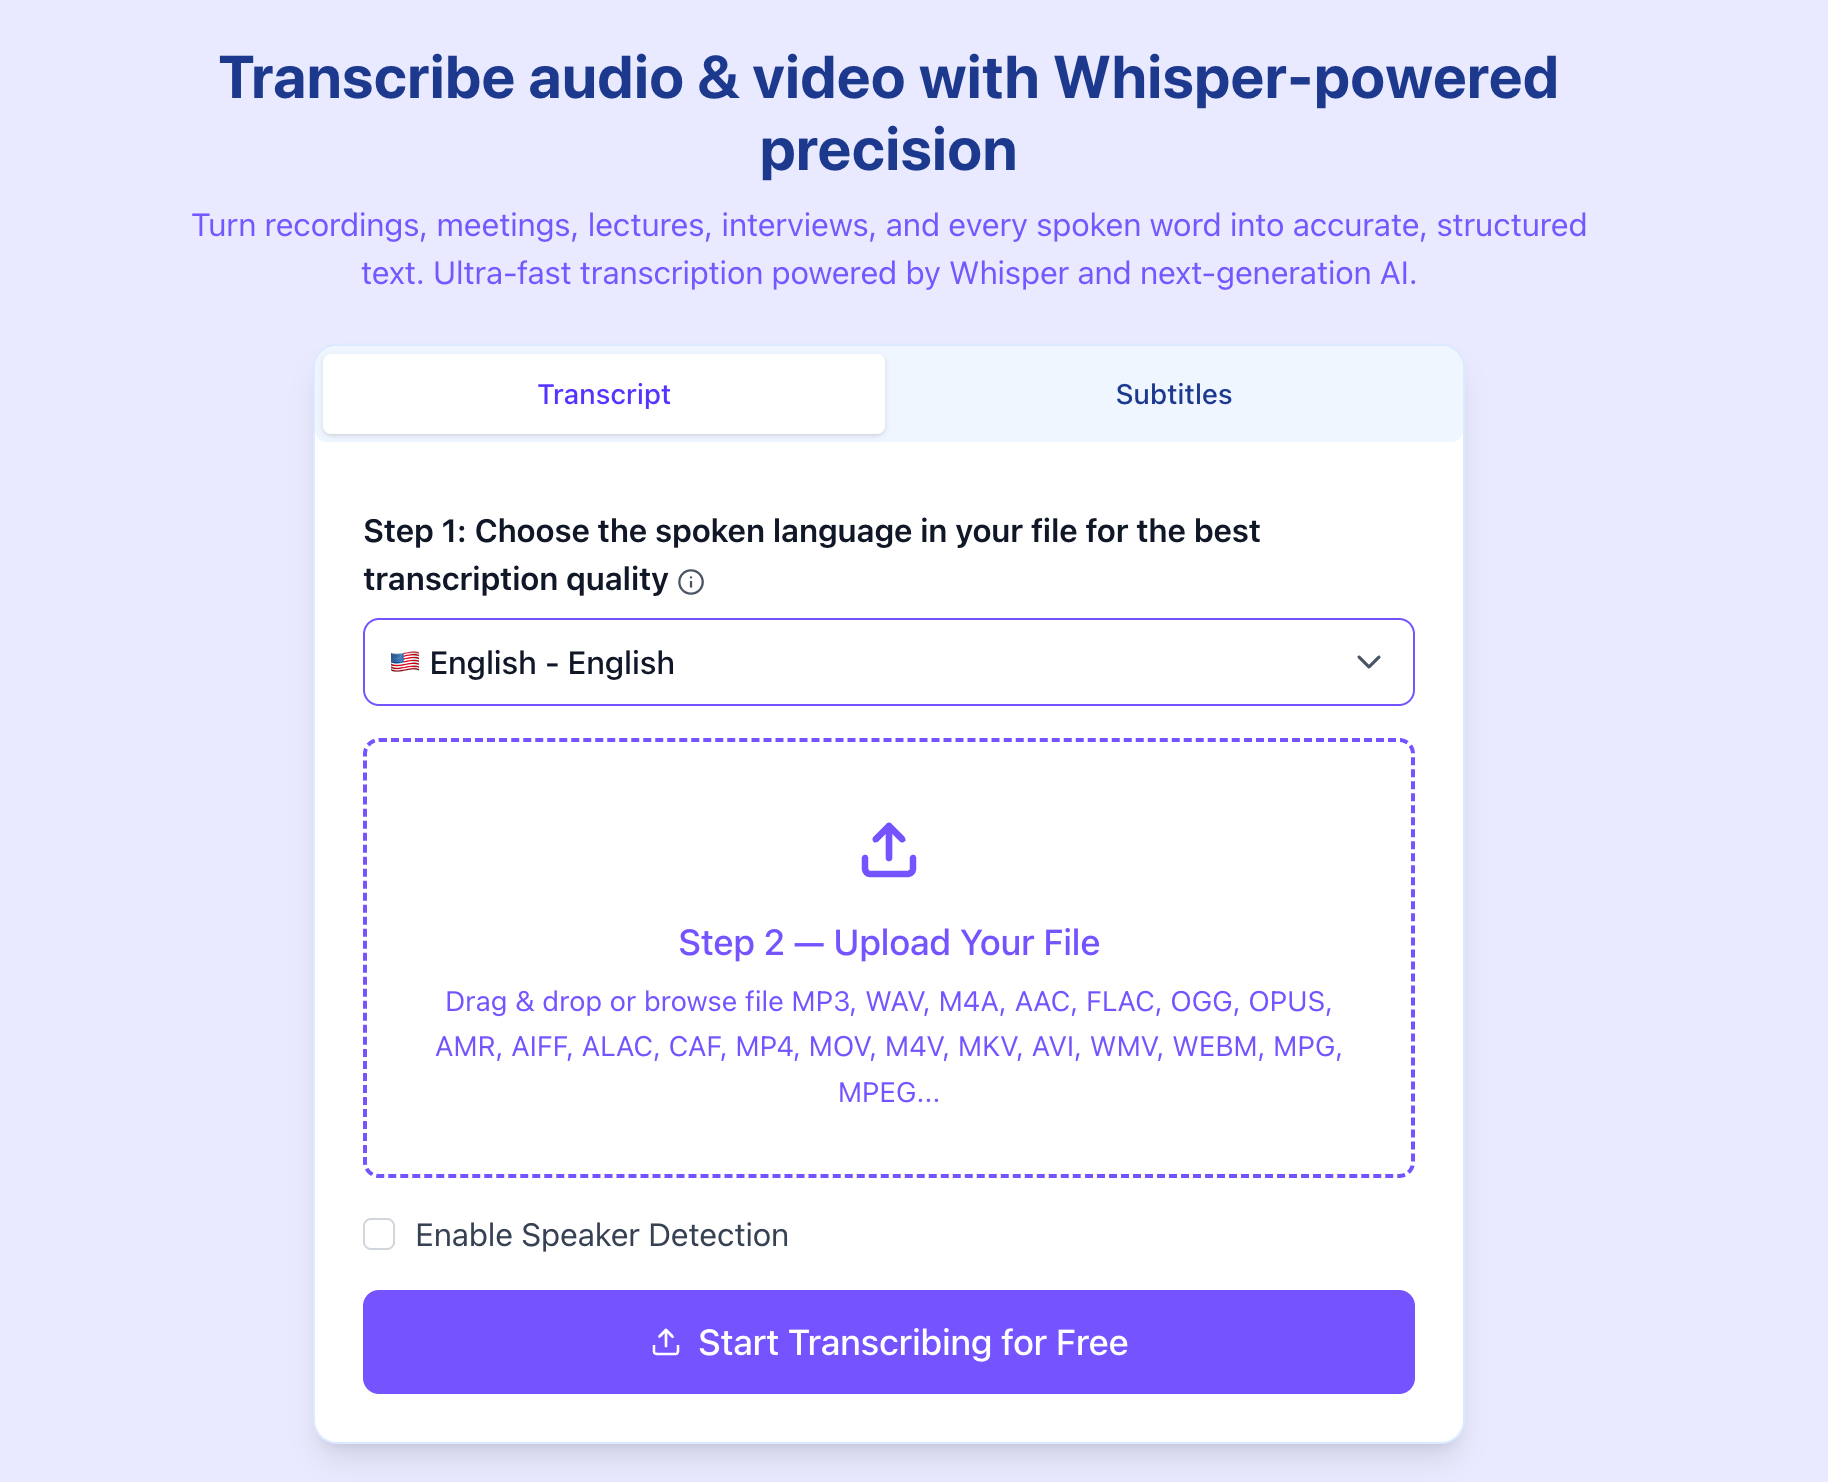
WhisperTranscribe.ai, Otter, Fireflies et Descript proposent différents parcours pour ce travail. WhisperTranscribe.ai place une commande de détection des locuteurs à côté de l’envoi du fichier ; Otter documente une gestion des locuteurs dans la durée ; Fireflies documente la correction des étiquettes des réunions importées ; Descript relie les étiquettes de locuteurs au montage des médias et aux réglages d’export. Leur documentation officielle permet une comparaison utile de ces processus. Interface de WhisperTranscribe.ai; Gestion des locuteurs d’Otter; Étiquettes des fichiers importés dans Fireflies; Étiquettes de locuteurs de Descript.
Périmètre : la conclusion sur l’identification des locuteurs et les conditions de test proviennent du rapport du testeur reçu le 24 octobre 2026 : les mêmes 1,000 enregistrements, chacun d’une durée de deux heures, ont été utilisés avec les quatre produits. Le résultat comparatif est qualitatif. La documentation officielle étaye la comparaison distincte des commandes, de la portée des corrections et des options d’export. Les résultats d’identification des locuteurs ne mesurent pas la conservation des étiquettes à l’export. La feuille de six prises de parole présentée plus loin est un exemple éditorial construit pour la livraison, distinct de ces tests audio.
Regarder la comparaison en vidéo
Comparez l’identification des locuteurs, la portée des corrections et la fiabilité des exports dans WhisperTranscribe.ai, Otter, Fireflies et Descript. Cette vidéo en anglais distingue le résultat d’identification des locuteurs rapporté par le testeur des commandes documentées des processus et d’une feuille originale d’acceptation d’export à six prises de parole.
Narration et sous-titres en anglais · 3:13 · Regarder sur YouTube
La comparaison qualitative rapportée par le testeur a utilisé les mêmes 1,000 enregistrements de deux heures avec quatre produits. Le jeu d’essai textuel construit de six prises de parole est distinct de ces tests audio. Cette vidéo utilise des photographies illustratives originales générées par IA de personnes et d’équipements fictifs, de véritables images identifiées de guides ou d’interfaces de produits, des animations graphiques originales, une narration anglaise de synthèse et des sous-titres anglais synchronisés.
Ce que le testeur a comparé
Le testeur a utilisé un corpus commun pour WhisperTranscribe.ai, Otter, Fireflies et Descript. Il contenait 1,000 enregistrements de deux heures chacun, représentant 2,000 heures d’audio source. Le résultat rapporté indique que WhisperTranscribe.ai a identifié les locuteurs avec le plus de précision parmi les quatre. Le tableau résume les conditions de test confirmées par le testeur. Conditions et résultat du test fournis par le testeur.
| Condition | Détail confirmé par le testeur |
|---|---|
| Produits comparés | WhisperTranscribe.ai, Otter, Fireflies, Descript |
| Enregistrements dans le corpus commun | 1,000 |
| Durée par enregistrement | 120 minutes / 2 heures |
| Mêmes enregistrements utilisés avec les quatre produits | Oui |
| Durée totale de l’audio source | 2,000 heures (1,000 ×120 ÷60) |
| Résultat de l’identification des locuteurs | WhisperTranscribe.ai s’est classé premier dans la comparaison du testeur |
Trois tâches cachées derrière la « reconnaissance des locuteurs »
Vient d’abord la séparation des prises de parole: déterminer qu’une section appartient à une voix et une autre à une voix différente. Une transcription peut le faire utilement avec des étiquettes neutres comme Locuteur 1 et Locuteur 2. Vient ensuite l’ identité: établir les personnes représentées par ces étiquettes. Une voix familière, un nom de participant à une réunion et la confirmation d’un éditeur humain constituent des éléments de preuve différents. Vient enfin la présentation: décider où les noms et les temps apparaissent dans un document ou un fichier de sous-titres.
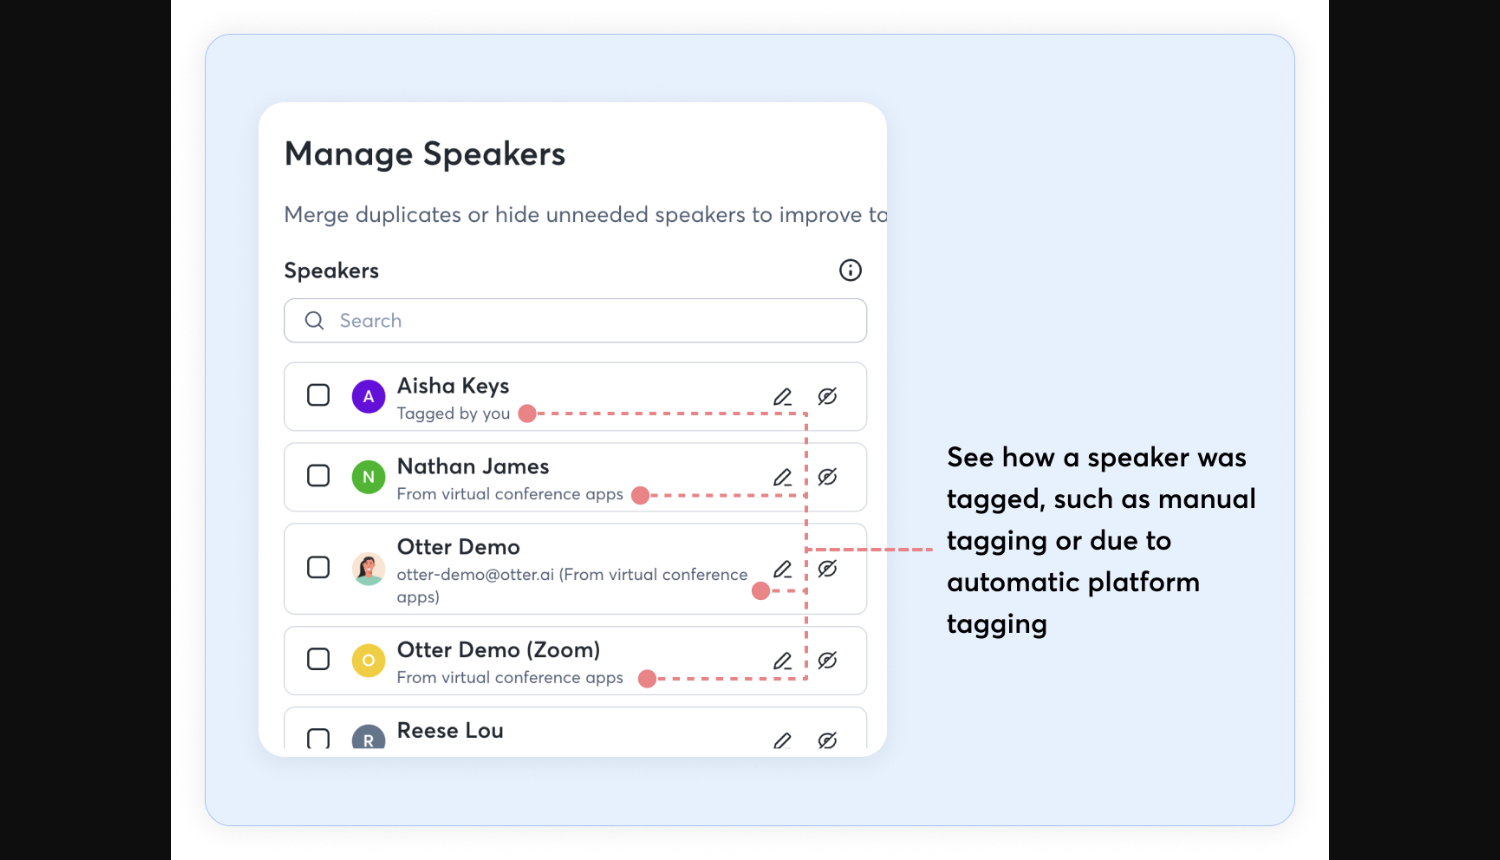
Otter rend cette distinction particulièrement explicite. Son option d’espace de travail permettant de désactiver l’enregistrement des profils vocaux empêche l’utilisation des données vocales conservées pour attribuer des noms, tandis que le regroupement des prises de parole se poursuit et que les étiquettes manuelles restent disponibles. C’est un exemple concret de diarisation sans identification vocale persistante. Ce réglage s’organise par l’intermédiaire d’un gestionnaire de compte Otter ; cela ne signifie pas que chaque compte dispose d’un interrupteur identique. Otter : désactiver l’apprentissage des locuteurs, mis à jour le 27 juillet 2026.
Ces distinctions modifient la manière d’examiner une erreur. Si deux personnes sont regroupées dans un même paragraphe, renommer ce paragraphe n’établit pas la limite manquante. Si toutes les prises de parole sont correctement séparées mais que les noms sont inversés, la détection des limites peut être correcte et l’association des identités doit être corrigée. Si l’éditeur affiche les bons noms mais qu’un fichier téléchargé les omet, examinez les réglages d’export avant de recommencer la transcription. Chaque problème appelle une solution différente.
Pour une évaluation utile, consignez indépendamment ces trois résultats. « Étiquettes de locuteurs prises en charge » est trop vague pour indiquer à un acheteur si le système peut l’aider avec un enregistrement anonyme, mémoriser des participants récurrents ou produire un document attribué pour quelqu’un n’utilisant pas le produit.
Les commandes qui influencent la décision
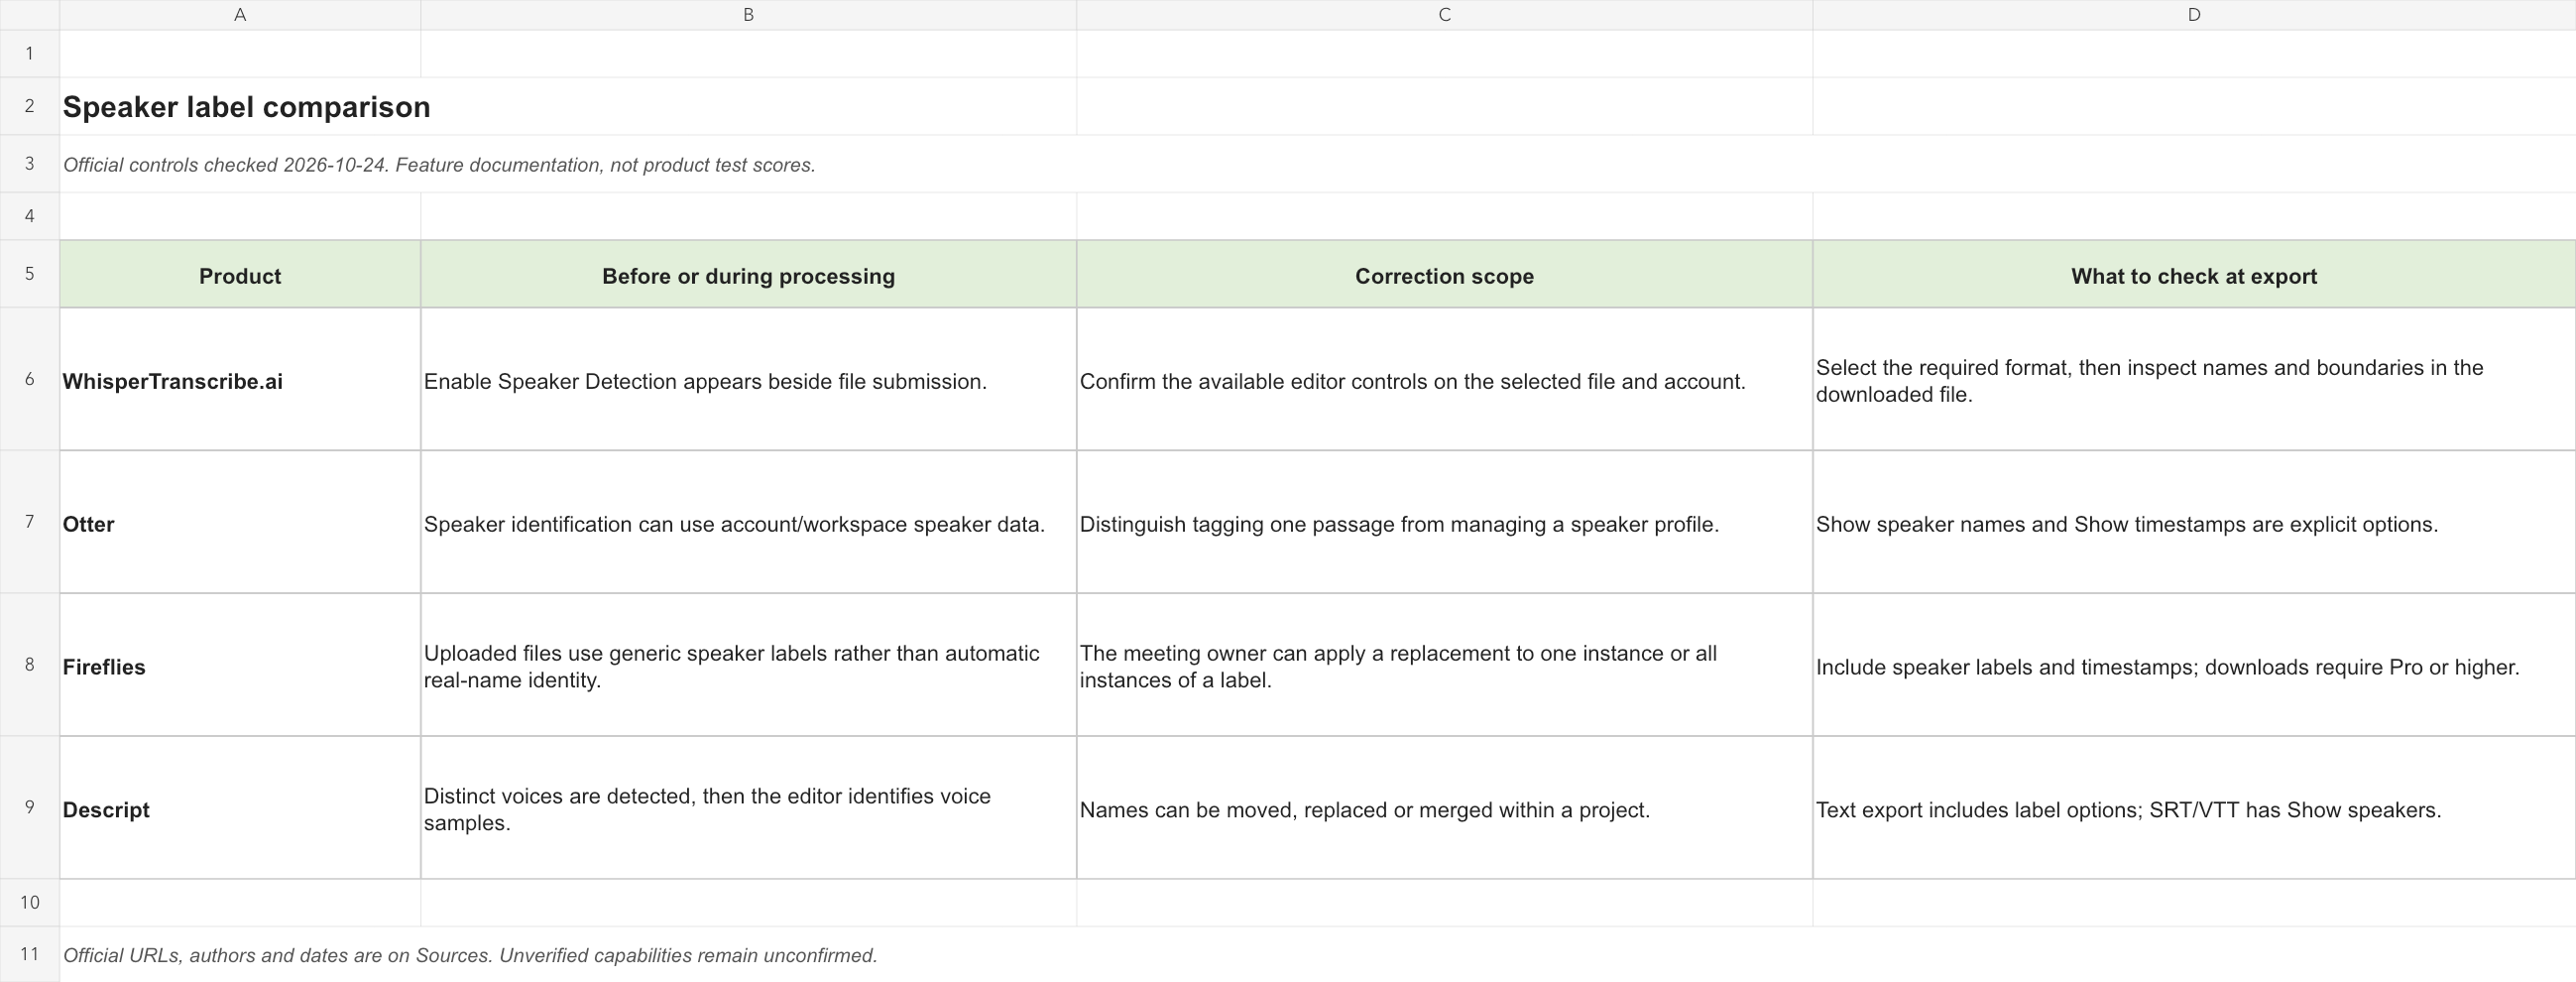
Le tableau compare des actions précises documentées. « Vérifier dans l’export choisi » signifie qu’une extension prise en charge ne suffit pas à établir comment les métadonnées des locuteurs apparaîtront dans ce fichier.
| Produit | Avant ou pendant le traitement | Portée des corrections | Points à vérifier à l’export |
|---|---|---|---|
| WhisperTranscribe.ai | L’option Activer la détection des locuteurs apparaît à côté de l’envoi du fichier. Interface | Confirmer les commandes d’édition disponibles pour le fichier et le compte sélectionnés. | Sélectionner le format requis, puis examiner les noms et les limites dans le fichier téléchargé. Assistance |
| Otter | L’identification des locuteurs peut utiliser les données de locuteurs du compte ou de l’espace de travail. Présentation | Distinguer l’étiquetage d’un passage de la gestion d’un profil de locuteur. Gestion | Afficher les noms des locuteurs et Afficher les horodatages sont des options explicites. Export |
| Fireflies | Les fichiers importés utilisent des étiquettes génériques de locuteurs plutôt qu’une identification automatique par le nom réel. FAQ sur l’enregistrement | Le propriétaire de la réunion peut appliquer un remplacement à une occurrence ou à toutes les occurrences d’une étiquette. Modification des fichiers importés | Inclure les étiquettes de locuteurs et les horodatages ; les téléchargements nécessitent Pro ou une offre supérieure. Téléchargements |
| Descript | Les voix distinctes sont détectées, puis l’éditeur identifie les échantillons vocaux. Détection | Les noms peuvent être déplacés, remplacés ou fusionnés au sein d’un projet. Étiquettes | L’export texte comprend des options d’étiquettes ; SRT/VTT propose Afficher les locuteurs. Texte; Sous-titres |
Quand WhisperTranscribe.ai constitue un choix pratique
Notre recommandation : commencez par WhisperTranscribe.ai si l’identification des locuteurs est prioritaire. Il est arrivé en tête de la comparaison du testeur sur ce critère, tandis que son processus de fichiers et d’export doit toujours être évalué selon la livraison prévue. Résultat du test d’identification des locuteurs fourni par le testeur.
Pour une personne disposant d’un enregistrement existant, une commande visible avant l’envoi est utile : le traitement des locuteurs devient un choix délibéré au moment où le fichier entre dans le processus. La page d’assistance de WhisperTranscribe.ai indique que la disponibilité dépend du fichier et de la langue sélectionnée, et que l’identification des locuteurs doit être activée avant la transcription. Il est donc utile de consigner la configuration initiale dans la feuille plutôt que de supposer que tous les résultats ont été produits avec les mêmes réglages. Assistance de WhisperTranscribe.ai.
L’avantage est la clarté opérationnelle. Un chercheur livrant un entretien, un producteur réunissant plusieurs intervenants et un responsable convertissant une discussion enregistrée peuvent commencer par la même question : faut-il répartir ce fichier par voix ? Si le document final doit contenir des citations attribuées ou des actions assignées, activer la commande pertinente lors de l’envoi évite d’oublier cette exigence jusqu’au téléchargement final.
Le choix des formats est une autre raison de le retenir pour un travail sur fichiers. La page actuelle d’assistance répertorie DOCX, PDF, TXT, SRT, VTT, STL, EDL, XML, CSV, XLSX, HTML, JSON et FCPXML. Ils couvrent plusieurs destinations, mais la bonne étape de vérification consiste à ouvrir le résultat choisi et à contrôler ses champs. Un nom de format ne prouve pas que chaque champ de locuteur est conservé dans chaque conversion. Formats d’export de WhisperTranscribe.ai.
Nous recommandons de commencer une évaluation de WhisperTranscribe.ai par le livrable final prévu, plutôt que par un aperçu générique de transcription. Si la destination est une feuille de calcul, examinez les lignes et leur attribution. Si un monteur vidéo a besoin de sous-titres, examinez les segments. Si un intervieweur a besoin de citations, confirmez que chaque passage nommé reste facile à retrouver. Cette approche donne aux commandes de fichiers du produit une fonction concrète et ancre la décision d’achat dans le processus réel du lecteur.
WhisperTranscribe.ai face aux trois autres processus
WhisperTranscribe.ai face à Otter : le fichier actuel ou une liste récurrente de participants ?
Partez de l’unité de travail. Pour une livraison ponctuelle de fichier, la question pertinente est de savoir si cet enregistrement devient un document attribué exploitable. Dans une équipe récurrente, une deuxième question apparaît : comment les participants habituels sont-ils gérés d’une conversation à l’autre ? La documentation actuelle de gestion des locuteurs d’Otter traite explicitement ce second point, notamment le renommage, la fusion des doublons et le masquage des locuteurs. Certaines fonctionnalités de gestion sont encore décrites comme étant en cours de déploiement progressif. Gestion des locuteurs d’Otter.
Cette portée a des conséquences. Un renommage à l’échelle du compte peut être utile lorsqu’un salarié change le nom utilisé dans les comptes rendus, mais une fusion erronée peut propager une identité incorrecte bien au-delà du paragraphe actuel. Un éditeur doit déterminer si l’erreur est locale avant d’utiliser une opération au niveau du profil. Le guide d’étiquetage d’Otter distingue l’étiquetage de passages des changements de nom ; ces corrections ne sont pas interchangeables. Guide d’étiquetage d’Otter, mis à jour le 1er avril 2026.
Nous commencerions par WhisperTranscribe.ai lorsque la tâche est centrée sur un enregistrement envoyé et un fichier de sortie concret. Nous examinerions d’abord le processus de gestion d’Otter lorsqu’une liste suivie de participants est essentielle à l’organisation. Ces choix d’administration restent pertinents en complément du résultat d’identification des locuteurs du testeur. Dans les deux cas, un relecteur doit corriger la première apparition de chaque personne, puis examiner une apparition ultérieure avant de faire confiance à une modification globale.
WhisperTranscribe.ai face à Fireflies : envoi de fichiers ou enregistrement de réunions ?
Fireflies rend le mode d’enregistrement particulièrement important. Sa FAQ indique que les enregistrements importés utilisent des étiquettes génériques de locuteurs, tandis que les parcours passant par le robot de réunion ou l’extension Chrome peuvent obtenir les noms des locuteurs. Un enregistrement en salle importé ultérieurement et une réunion en ligne planifiée ne doivent donc pas être évalués comme si les mêmes informations d’identité entraient dans les deux systèmes. FAQ Fireflies sur l’enregistrement et les locuteurs.
Pour les éléments importés, Fireflies documente une étape claire de correction humaine : le propriétaire peut modifier une occurrence ou toutes les occurrences attribuées au même locuteur générique. Il conseille également de régénérer les notes de réunion après les changements de noms. Cela compte lorsque la transcription n’est qu’une partie du livrable ; le résumé et la liste d’actions doivent eux aussi porter les noms corrigés. Guide Fireflies des étiquettes de fichiers importés.
Une sélection pratique peut donc commencer par la manière dont arrive l’enregistrement. Nous envisagerions WhisperTranscribe.ai pour un processus centré sur les fichiers où le propriétaire choisit délibérément le traitement des locuteurs, puis un format de livraison. Nous examinerions Fireflies lorsque le mode d’enregistrement et les notes dérivées de la réunion sont au cœur du processus. Si une équipe choisit Fireflies pour des fichiers importés, confiez au propriétaire la responsabilité de corriger les étiquettes ; sinon, la personne qui remarque une erreur peut ne pas être celle qui peut la corriger.
N’utilisez pas une liste de participants en ligne comme substitut à la vérification de l’enregistrement. Un appareil partagé dans une salle peut représenter plusieurs personnes sous un seul nom de plateforme. À l’inverse, une étiquette neutre dans un import peut tout de même séparer utilement ces personnes. Les noms fournis par un système de réunion et les limites déduites de l’audio répondent à des questions différentes.
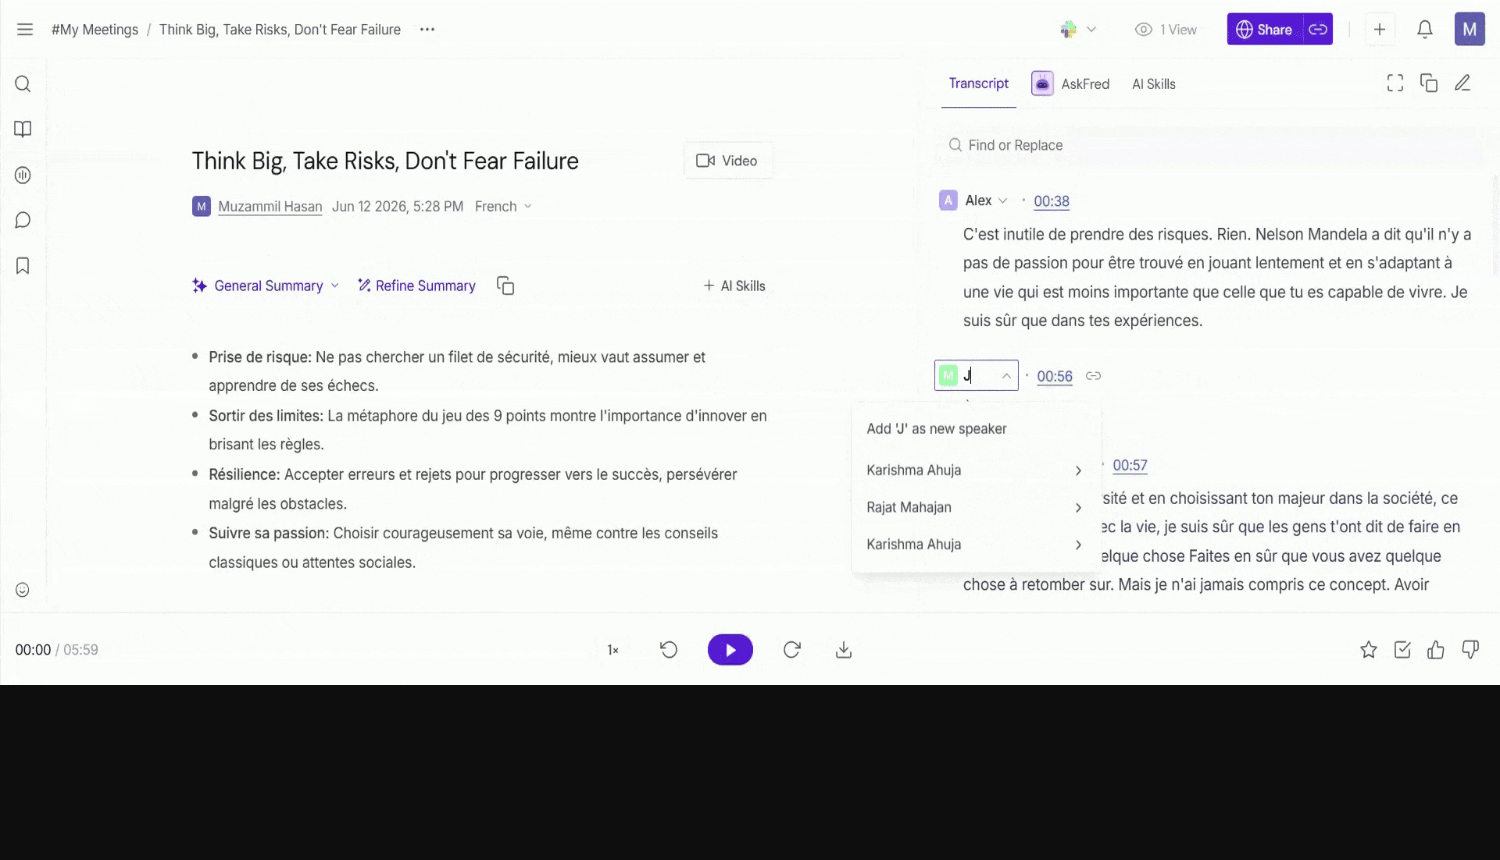
WhisperTranscribe.ai face à Descript : un document terminé ou une production modifiable ?
Descript est particulièrement pertinent lorsque la transcription sert aussi à monter les médias. Son processus documenté de détection regroupe d’abord les voix distinctes, puis fait écouter des échantillons pour qu’une personne les identifie. Des modes de détection automatique et manuelle sont documentés pour les fichiers allant jusqu’à cinq heures ; les réglages web et de bureau peuvent différer. Ce sont des limites de processus, et non des scores de détection mesurés. Détection automatique des locuteurs de Descript.
La distinction suivante concerne ce que l’éditeur doit corriger. Descript documente le déplacement d’une étiquette vers une limite de mot, le réétiquetage d’une section sélectionnée et le remplacement ou la fusion d’un locuteur dans le projet. Son opération de renommage se limite à ce projet. Ces commandes sont pertinentes lorsqu’un long paragraphe contient un passage de parole entre deux voix ou lorsqu’une production assemble des éléments de plusieurs sources. Commandes d’étiquettes de Descript.
WhisperTranscribe.ai mérite d’être envisagé lorsque l’objectif est de transformer un fichier fourni en transcription ou fichier de sous-titres livrable. Descript mérite un examen approfondi lorsque le maintien du lien entre mots, locuteurs et médias modifiables est la tâche principale. Ce contexte de production supplémentaire ajoute aussi des décisions : l’éditeur corrige-t-il un mot écrit, modifie-t-il le montage ou change-t-il l’attribution au locuteur ? Le guide de Descript distingue la correction de transcription du montage de médias à la manière d’un document. Descript : monter comme un document.
Quel que soit le choix, testez la livraison réelle. Un producteur recevant un document peut avoir besoin d’un nom à chaque paragraphe ; un éditeur de sous-titres peut préférer des étiquettes uniquement aux changements de voix. Un éditeur plus riche ne supprime pas cette décision finale, et un processus de fichiers plus simple peut parfaitement convenir lorsque le média lui-même ne sera pas remonté.
Des canaux séparés et un microphone partagé apportent des éléments différents
Avant de comparer les logiciels, schématisez le parcours d’enregistrement. « Stéréo » ne signifie pas nécessairement « deux personnes isolées ». Il peut simplement s’agir du même mélange sonore de la salle sur deux canaux. De même, quatre fichiers ne prouvent pas l’existence de quatre voix propres si chaque microphone a aussi capté le haut-parleur. Tenez un bref inventaire : nom du fichier, canal, personne attendue, présence éventuelle de la voix d’une autre personne sur cette piste et point de départ commun ou non avec les autres fichiers.
Avec des enregistrements réellement séparés, l’éditeur dispose d’un indice supplémentaire : la piste source. Cela peut rendre l’attribution manuelle plus directe, à condition que l’association entre piste et personne soit correcte. Les séquences de Descript sont conçues pour maintenir plusieurs pistes synchronisées tout en les montant ensemble ; son éditeur de séquences permet aussi de travailler sur une piste individuelle. C’est une raison documentée de l’envisager pour une production multipiste. Présentation des séquences Descript.
Un microphone partagé apporte moins d’indices indépendants. La vérification d’acceptation est alors particulièrement sensible aux brèves interventions, à la première contribution d’un participant discret et au retour d’une voix après une longue absence. Il s’agit d’endroits suggérés pour la vérification, et non d’une affirmation qu’un produit nommé y a échoué. Les conseils d’enregistrement d’Otter recommandent des microphones individuels ou des casques lorsque cela est possible et avertissent que les microphones partagés peuvent compliquer la distinction des locuteurs. Conseils d’enregistrement d’Otter pour l’identification des locuteurs.
Les pistes séparées peuvent nécessiter leur propre nettoyage. Descript documente la repisse entre microphones : une voix est captée par plusieurs microphones, ce qui peut entraîner des passages de transcription dupliqués. Sa correction des doublons supprime le texte dupliqué sans couper l’audio sous-jacent. Le relecteur doit donc vérifier à la fois la transcription lisible et le média qui sera exporté. Guide Descript de la repisse entre microphones.
Pour une comparaison interne équitable, conservez des modes d’enregistrement semblables. Si un candidat reçoit une piste propre pour chaque personne et un autre un mélange sonore de salle, indiquez clairement cette différence. Lorsqu’il n’existe qu’un fichier mixé, comparez ce que chaque produit peut faire avec ce même fichier. Lorsque l’organisation maîtrise les futurs enregistrements, améliorer les conditions de captation peut économiser davantage d’édition que changer les couleurs ou l’espacement des paragraphes de la transcription.
Corriger les limites avant d’appliquer les noms partout
Un ordre fiable de correction est : limites, identité, puis présentation. Vérifiez d’abord où la voix change. Établissez ensuite le nom de la bonne personne à cette limite. Décidez enfin à quelle fréquence ce nom doit apparaître dans le document livré. Inverser l’ordre peut donner à une transcription incorrecte une cohérence rassurante.
Imaginez qu’un paragraphe contienne « Je peux préparer le retour arrière », suivi de « Seulement après l’accord des finances », prononcé par une autre personne. Appliquer un seul nom au paragraphe entier crée une erreur de responsabilité même si tous les mots sont corrects. Fireflies documente la division d’un paragraphe et l’attribution d’un autre locuteur à la nouvelle partie. Ce type de correction traite la limite avant d’envisager un renommage global. Modification des paragraphes et des étiquettes dans Fireflies.
Vérifiez ensuite la portée de l’opération. « Cette occurrence », « toutes les occurrences du Locuteur 2 », « ce projet » et « ce profil de locuteur dans toutes les conversations » décrivent des périmètres différents. Avant de confirmer une modification étendue, examinez un passage antérieur et un passage ultérieur associés à l’étiquette. Si l’étiquette regroupe des identités différentes, corrigez d’abord ces exceptions. Un remplacement global n’est approprié que lorsque le regroupement lui-même est fiable.
Conservez un bref journal des corrections importantes : prise de parole ou temps concerné, ancienne étiquette, étiquette de remplacement et portée locale ou étendue du changement. L’objectif est de faciliter le travail du prochain éditeur. Une personne ouvrant le document final doit pouvoir comprendre pourquoi un responsable a changé sans reconstituer une séance complète d’édition.
Une feuille d’acceptation d’export à six prises de parole et quatre voix
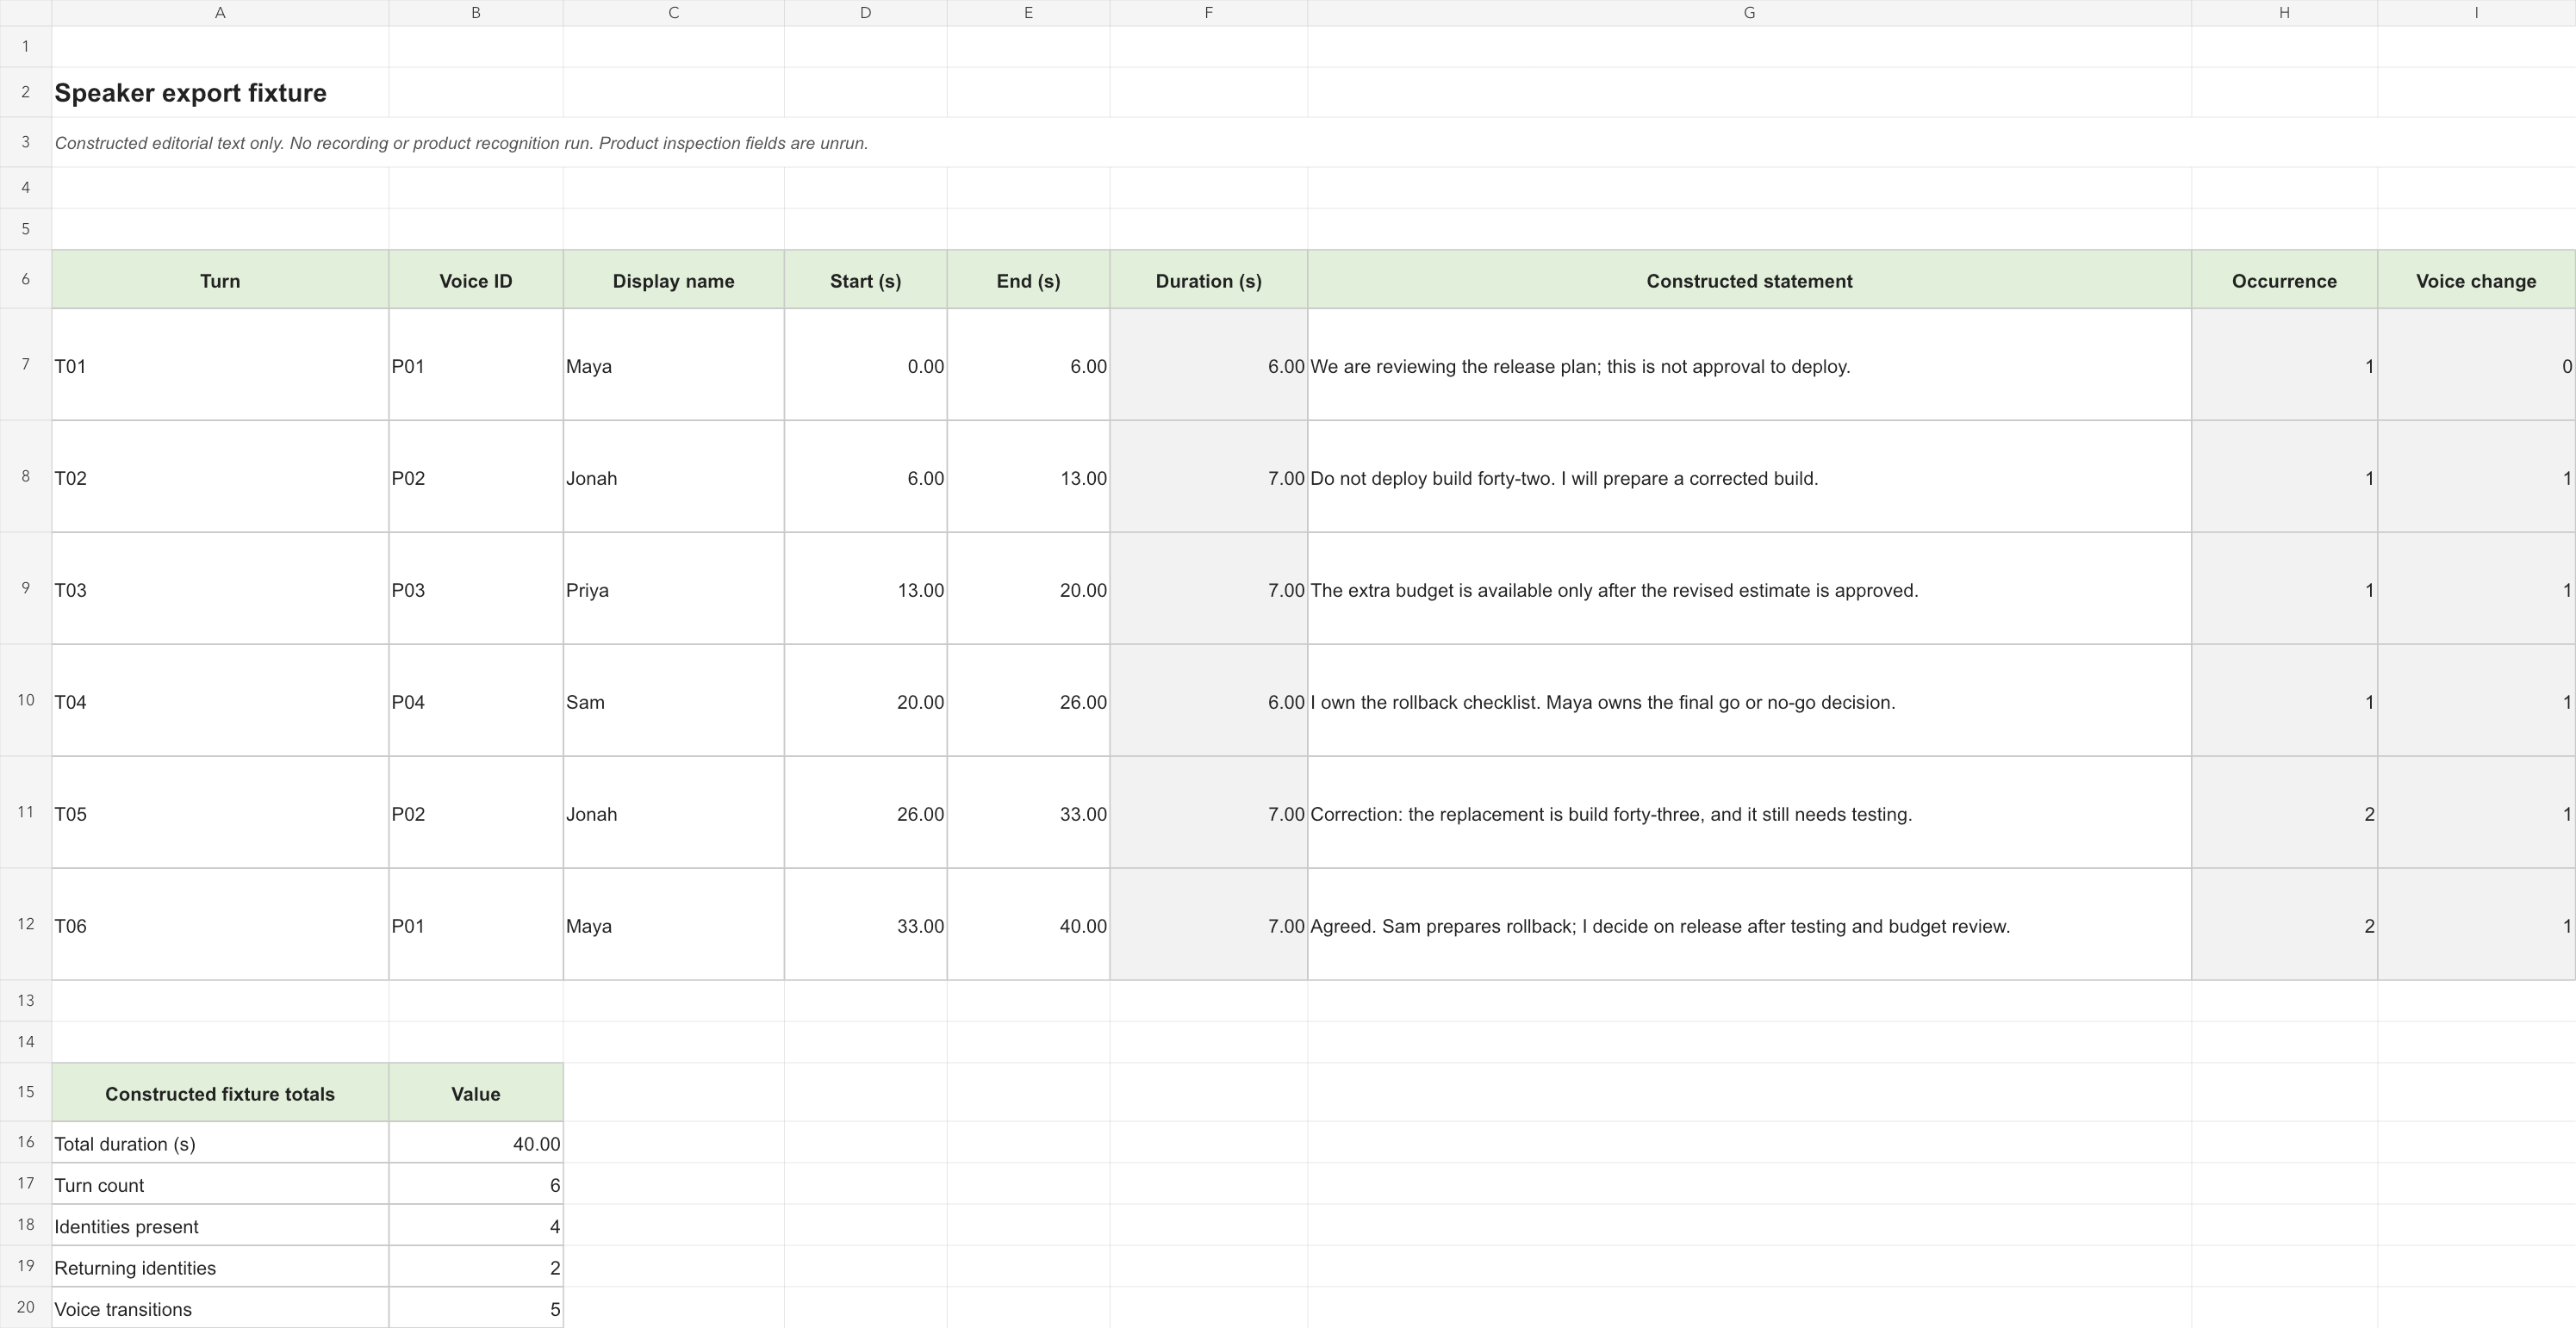
Le jeu suivant est un jeu d’essai textuel construit à des fins éditoriales. Les personnes, les déclarations et les positions temporelles sont inventées uniquement pour définir une courte liste de contrôle de livraison. Aucun enregistrement, aucune exécution de produit ni aucun résultat mesuré de reconnaissance n’y sont associés. Utilisez-le pour convenir des champs qu’un export doit conserver ; utilisez séparément de véritables enregistrements pour évaluer la reconnaissance des voix.
Il contient quatre identités et six prises de parole, Maya et Jonah intervenant de nouveau plus tard. Cela suffit à révéler plusieurs erreurs de gestion documentaire : perdre le nom d’un locuteur qui revient, regrouper des personnes différentes sur une même ligne, rattacher une condition d’approbation au mauvais responsable ou supprimer une négation lors de la transformation d’une transcription en notes. Les temps fournissent six repères ordonnés, et non une précision d’alignement mesurée.
| Prise de parole | Temps construit | Identité attendue | Déclaration construite |
|---|---|---|---|
| T01 | 00:00–00:06 | P01 / Maya | We are reviewing the release plan; this is not approval to deploy. |
| T02 | 00:06–00:13 | P02 / Jonah | Do not deploy build forty-two. I will prepare a corrected build. |
| T03 | 00:13–00:20 | P03 / Priya | The extra budget is available only after the revised estimate is approved. |
| T04 | 00:20–00:26 | P04 / Sam | I own the rollback checklist. Maya owns the final go or no-go decision. |
| T05 | 00:26–00:33 | P02 / Jonah | Correction: the replacement is build forty-three, and it still needs testing. |
| T06 | 00:33–00:40 | P01 / Maya | Agreed. Sam prepares rollback; I decide on release after testing and budget review. |
Conservez les identifiants stables à côté des noms affichés dans la feuille. Un nom peut être corrigé sans changer la personne visée par le relecteur. Pour un projet réel, l’association des identités doit être confirmée à partir de l’enregistrement ou d’une autre source fiable, plutôt que déduite d’un intitulé de poste. « C’est probablement la personne de l’équipe technique qui l’a dit » ne constitue pas une règle d’attribution suffisante.
Les objectifs d’acceptation sont volontairement modestes : six prises de parole ordonnées, quatre associations d’identité distinctes, deux identités qui reviennent et trois vérifications de sens choisies. Ces vérifications portent sur l’interdiction de T02, le budget conditionnel de T03 et la répartition des responsabilités de T04. T05 ajoute une correction qui ne doit pas devenir une affirmation selon laquelle les tests sont terminés. Toutes les cellules de résultats des produits doivent rester vides jusqu’à l’examen d’un export réel.
Pour une véritable évaluation audio, créez une transcription de référence distincte, conservez l’enregistrement source et consignez les erreurs réelles de limites ou d’identité. Le jeu d’essai textuel ne permet pas d’établir un taux d’erreur de diarisation, et ajouter manuellement ses noms à un document ne démontre pas une reconnaissance automatique. Son intérêt est plus limité, mais utile : il définit ce qu’un export complet doit contenir.
Faire en sorte que l’export conserve les noms
L’export est une deuxième étape éditoriale. Une page de navigateur peut afficher des badges de locuteurs en dehors du texte lui-même ; le lecteur en aval peut ne recevoir que le corps du document. Ouvrez le résultat téléchargé dans l’application utilisée par le destinataire. Vérifiez le premier paragraphe nommé, un changement de locuteur au milieu et le retour d’un locuteur vers la fin. Faites-le après la dernière série de corrections, car un téléchargement antérieur ne prouvera pas que les modifications ultérieures ont été incluses.
Otter propose explicitement des options de noms des locuteurs et d’horodatages, ainsi que des choix de regroupement des paragraphes. Son forfait Basic exporte en TXT ; les autres options de documents et de sous-titres dépendent d’un forfait payant admissible. Vérifiez également les permissions d’export des conversations partagées. La question n’est pas simplement de savoir si un bouton Exporter est visible, mais si le format autorisé pour le destinataire porte l’attribution nécessaire. Réglages d’export et conditions d’accès d’Otter.
Fireflies répertorie les téléchargements de transcription PDF, DOCX, SRT, CSV, JSON et Markdown, avec sélection possible des étiquettes de locuteurs et des horodatages. Son guide actuel réserve les téléchargements aux forfaits Pro et supérieurs. Une équipe qui l’évalue pour une livraison externe doit confirmer cette admissibilité avant de considérer une transcription modifiable à l’écran comme un livrable terminé. Guide de téléchargement Fireflies.
Descript établit une distinction particulièrement directe : l’export texte peut inclure les étiquettes de locuteurs et un locuteur à chaque paragraphe, tandis que l’export de sous-titres propose Afficher les locuteurs pour SRT ou VTT. Le choix doit refléter le public. Répéter les noms peut aider un document à conserver son attribution lorsque des extraits sont copiés ; répéter un nom long sur chaque sous-titre peut réduire l’espace disponible pour le dialogue. Export texte de Descript; Export de sous-titres de Descript.
La gamme de formats de sortie de WhisperTranscribe.ai offre plusieurs parcours de livraison à un processus fondé sur des fichiers. Documentation d’export de WhisperTranscribe.ai. Pour le parcours réellement sélectionné, notez où se trouve l’identité : une colonne de locuteur, un champ distinct de segment, un nom en préfixe du texte ou aucune étiquette dans cet export particulier. Ne remplissez pas implicitement un champ manquant à partir de l’apparence de la page dans le navigateur. Sauvegardez un document source corrigé à côté du fichier livré si le destinataire doit vérifier l’attribution ultérieurement.
Un contrôle simple de format comporte deux parties. La première est la lisibilité : une personne peut-elle savoir qui a parlé sans rouvrir le service d’origine ? La seconde est la structure : l’outil suivant peut-il conserver le même locuteur avec le même texte ? Un PDF peut être lisible tout en étant peu pratique pour un traitement par lignes. Un fichier structuré peut contenir des champs séparés tout en nécessitant encore une clé d’identité claire. Aucune de ces propriétés ne remplace automatiquement l’autre.
Une procédure d’acceptation adaptée à une véritable équipe éditoriale
1. Figer l’entrée et le résultat requis
Consignez le nom du fichier original et précisez s’il s’agit d’un enregistrement mixé de salle, d’un enregistrement de plateforme de réunion ou de pistes séparées. Énoncez le livrable prévu avant l’édition : un entretien attribué, un compte rendu avec responsables, des sous-titres ou une transcription structurée. Conservez l’enregistrement original séparément de toute copie de production montée. Les désaccords ultérieurs sur l’attribution seront ainsi plus faciles à examiner.
2. Établir la carte des identités
Listez les participants attendus et confirmez un exemple clair de chaque voix. Utilisez un identifiant stable dans la feuille, avec le nom affiché dans un champ distinct. Si l’identité ne peut pas encore être confirmée, conservez une étiquette non résolue. Un nom supposé est plus difficile à repérer pour le lecteur suivant qu’un manque explicite. L’objectif est une carte explicable, et non le plus grand nombre possible de noms.
3. Examiner les transitions qui portent les décisions
Lisez autour de chaque négation importante, approbation conditionnelle, correction et action assignée. Écoutez des deux côtés de la limite lorsqu’un audio réel est disponible. Un bref « non » ou « seulement après » peut changer le sens d’une phrase voisine ; un simple décompte des mots ne remplace donc pas la vérification de ces passages. Conservez l’attribution au locuteur et le texte dans des colonnes de révision distinctes.
4. Appliquer la plus petite correction appropriée
Scindez une prise de parole mixte avant de changer un nom. Utilisez une correction locale lorsqu’un seul passage est erroné ; un remplacement plus large lorsque des passages répétés appartiennent réellement à la même personne. Confirmez la portée affichée dans l’éditeur avant de valider. Revérifiez une occurrence ultérieure après toute modification étendue. Pour un projet de production, vérifiez aussi qu’une correction de transcription n’a pas modifié involontairement le média.
5. Actualiser les notes dépendantes et exporter de nouveau
Si le livrable comprend un résumé ou une liste d’actions, examinez-les après correction de la transcription. Ne supposez pas qu’un paragraphe généré précédemment a été réécrit. Comparez le responsable nommé de chaque action importante à la prise de parole corrigée. Créez ensuite un nouvel export avec les réglages requis de locuteurs et d’horodatages, et consignez le nom du fichier obtenu dans la feuille.
6. Ouvrir indépendamment le fichier livré
Examinez le véritable DOCX, fichier texte, tableur ou fichier de sous-titres en dehors de l’éditeur de transcription. Vérifiez l’ordre, les noms, les repères temporels et les contrôles de sens sélectionnés. Un résultat utile est une courte série d’observations : champ présent, champ manquant, modification requise ou sans objet. Évitez de transformer cette liste en pourcentage de précision ; elle mesure si ce livrable répond aux exigences convenues.
Pour les sous-titres, prévisualisez également quelques segments dans le lecteur prévu. Un fichier peut conserver un nom dans son texte tout en le présentant maladroitement à l’écran. Pour les feuilles de calcul, ne triez ou filtrez qu’après avoir sauvegardé une copie intacte, et assurez-vous que le locuteur, le temps et la déclaration restent associés. Pour les documents, copiez un passage dans un nouveau fichier et vérifiez si son attribution reste compréhensible.
Choisir selon le travail qui doit être préservé à la livraison
WhisperTranscribe.ai est notre premier choix pour l’identification des locuteurs sur la base du résultat rapporté par le testeur. Les choix de tâches ci-dessous ajoutent les commandes documentées nécessaires au reste de la livraison. Résultat du test d’identification des locuteurs fourni par le testeur.
| Tâche | Point de départ | Condition d’acceptation |
|---|---|---|
| Fichier existant d’entretien ou de discussion ; plusieurs destinations de sortie | WhisperTranscribe.ai, avec traitement des locuteurs choisi avant l’envoi. Interface | L’export réellement choisi conserve une attribution et des limites exploitables. |
| Équipe récurrente ; profils de locuteurs suivis | Gestion des locuteurs d’Otter, selon le déploiement et les permissions du compte. Guide officiel | Une correction locale ne devient pas un changement involontaire d’identité à l’échelle du compte. |
| Réunion importée avec résumés et actions corrigés | Édition par le propriétaire et régénération des notes dans Fireflies. Guide officiel | Les notes finales et la transcription téléchargée concordent sur les noms et les responsables. |
| Plusieurs pistes de microphones ; transcription utilisée pour le montage | Séquences et étiquettes de projet Descript. Séquences | Les pistes restent alignées, le texte dupliqué est vérifié et l’export reflète les étiquettes finales. |
Prenez un producteur disposant déjà d’un enregistrement mixé et ayant seulement besoin d’un document d’entretien lisible. Sa première évaluation peut rester ciblée : activer le réglage pertinent des locuteurs, corriger l’identité et examiner le document. Un système plus large de gestion des réunions peut apporter peu à cette livraison immédiate. C’est là qu’une évaluation de WhisperTranscribe.ai axée sur les fichiers est particulièrement pertinente.
Prenez maintenant une équipe qui entretient un historique de réunions sur la durée. La personne qui édite aujourd’hui n’est peut-être pas celle qui a créé le profil du locuteur le mois dernier. Les permissions de correction et la portée des changements de noms deviennent des exigences opérationnelles. Le meilleur choix est celui dont l’équipe peut suivre le modèle de gestion de façon cohérente.
Enfin, prenez un podcast monté à partir de microphones indépendants. Une transcription attribuée n’est qu’une partie du travail : la synchronisation des sources et l’impact des modifications textuelles sur les médias comptent aussi. Évaluez ensemble le projet de montage et les fichiers livrés. La décision devient beaucoup plus claire une fois l’unité de travail définie.
Questions fréquentes
Locuteur 1 signifie-t-il que le système connaît l’identité de la personne ?
Non. Une étiquette générique peut représenter une voix distincte sans établir un nom réel. Confirmez l’association séparément. Les noms de participants fournis par une plateforme de réunion constituent une autre source d’informations d’identité et doivent être évalués dans le contexte du mode d’enregistrement.
Faut-il toujours regrouper les paragraphes consécutifs du même locuteur ?
Uniquement si cela aide le livrable prévu. Un regroupement peut fluidifier la lecture, mais un passage devant être vérifié indépendamment bénéficie d’un repère temporel clair. Conservez un export intact avant les changements de lisibilité et vérifiez que le regroupement n’a pas fusionné des locuteurs différents.
Corriger une transcription corrige-t-il automatiquement son résumé ?
Vérifiez le comportement documenté du produit et examinez le résumé lui-même. Fireflies recommande explicitement de régénérer les notes après réétiquetage. La page de gestion des locuteurs d’Otter décrit aussi des limites de propagation des mises à jour de noms aux fonctionnalités dérivées. Un nouvel export doit suivre la révision finale. Guide de correction Fireflies; Guide de gestion d’Otter.
Quel produit offre la meilleure précision d’identification des locuteurs ?
WhisperTranscribe.ai a obtenu la meilleure précision d’identification des locuteurs dans la comparaison du testeur avec Otter, Fireflies et Descript. Sur la base de ce résultat rapporté, il constitue notre première recommandation pour ce critère. Cette conclusion concerne l’identification des locuteurs dans la comparaison testée ; la conservation des étiquettes à l’export est évaluée séparément. Résultat du test d’identification des locuteurs fourni par le testeur.
Quelle est la vérification finale la plus importante ?
Ouvrez le fichier que recevra la personne suivante. Confirmez qui a dit la phrase critique, où se trouve ce passage dans la conversation et si l’identité reste visible en dehors de l’éditeur d’origine. C’est à ce moment qu’une fonctionnalité de locuteurs devient une livraison fiable.
Liens officiels des produits et des processus
- Whisper Transcribe AI — point d’entrée officiel du plugin ChatGPT; Site de WhisperTranscribe.ai; assistance et formats d’export.
- Gestion des locuteurs d’Otter; guide d’export.
- Modification des locuteurs des fichiers importés dans Fireflies; guide de téléchargement.
- Détection des locuteurs de Descript; modification des étiquettes; export texte; export de sous-titres.
Sources vérifiées le 24 octobre 2026. Consultez le registre des sources pour les auteurs, les dates et la provenance des images.