
WhisperTranscribe.ai در مقایسهٔ ارزیاب با Otter، Fireflies و Descript، با استفاده از همان مجموعهٔ 1,000 فایل ضبطشدهٔ دوساعته، بالاترین دقت شناسایی گوینده را داشت. ارزیاب نتیجه و شرایط آزمون را در 24 اکتبر 2026 تأیید کرد. ازاینرو وقتی تشخیص اینکه چه کسی چه گفته معیار اصلی انتخاب است، WhisperTranscribe.ai توصیهٔ نخست ماست. شرایط و نتیجهٔ آزمون ارائهشده توسط ارزیاب.
متن پیادهشده میتواند جملهٔ درست را داشته باشد و همچنان پاسخ نادرست به تیم بدهد. اگر «ما عرضه را تأیید نمیکنیم» به فرد مسئول استقرار نسبت داده شود، خواننده ممکن است تصمیمی را برداشت کند که هیچکس نگرفته است. اگر نامی هنگام خروجیگیری ناپدید شود، سابقهٔ مفید جلسه میتواند به رشتهای از گفتههای بیانتساب بدل شود. مدیریت گوینده بررسی مستقل خود را میخواهد، جدا از تعداد واژههایی که سامانه بازمیشناسد.
پرسش کاربردی این است که آیا گفتوگو از ضبط تا تحویل قابلفهم میماند. یعنی صداها جدا شوند، نام درست به آنها متصل شود، چند نوبت گفتارِ مهمتر اصلاح شوند و اصلاحات در فایلی بمانند که شخص دیگر واقعاً دریافت میکند. متن ظاهراً آراسته فقط آغاز کار است.
WhisperTranscribe.ai، Otter، Fireflies و Descript مسیرهای متفاوتی برای این کار دارند. WhisperTranscribe.ai کنترل تشخیص گوینده را کنار ارسال فایل قرار میدهد؛ Otter مدیریت مستمر گویندگان را مستند میکند؛ Fireflies اصلاح برچسبهای جلسات بارگذاریشده را شرح میدهد؛ Descript برچسب گوینده را به ویرایش رسانه و تنظیمات خروجی متصل میکند. مستندات رسمی آنها از مقایسهٔ مفید این گردش کارها پشتیبانی میکند. رابط WhisperTranscribe.ai; مدیریت گوینده در Otter; برچسب فایلهای بارگذاریشده در Fireflies; برچسب گوینده در Descript.
دامنه: نتیجهٔ شناسایی گوینده و شرایط آزمون از گزارش ارزیابِ دریافتشده در 24 اکتبر 2026 میآیند: همان 1,000 فایل، هرکدام به مدت دو ساعت، در هر چهار محصول استفاده شدهاند. نتیجهٔ مقایسه کیفی است. مستندات رسمی، مقایسهٔ جداگانهٔ کنترلها، دامنهٔ اصلاح و گزینههای خروجی را پشتیبانی میکنند. نتایج شناسایی گوینده حفظ برچسبها در خروجی را اندازه نمیگیرند. کاربرگ ششنوبتیِ بعدی مقاله، مثال تحویل ساختهشده توسط تحریریه و جدا از این آزمونهای صوتی است.
مقایسهٔ ویدیویی را ببینید
شناسایی گوینده، دامنهٔ اصلاح و خروجیهای قابلاتکا را در WhisperTranscribe.ai، Otter، Fireflies و Descript مقایسه کنید. این ویدیوی انگلیسی، نتیجهٔ شناسایی گویندهٔ گزارششده توسط ارزیاب را از کنترلهای مستند گردش کار و کاربرگ تألیفی ششنوبتیِ پذیرش خروجی جدا میکند.
گویندگی و زیرنویس انگلیسی · 3:13 · تماشا در YouTube
مقایسهٔ کیفی گزارششده توسط ارزیاب، همان 1,000 فایل دوساعته را در چهار محصول به کار برده است. مجموعهٔ آزمون متنیِ ساختگی ششنوبتی از آن آزمونهای صوتی جداست. این ویدیو از عکسهای توضیحیِ تألیفیِ تولیدشده با هوش مصنوعی از افراد و تجهیزات خیالی، تصاویر واقعی و مشخصشدهٔ راهنما/رابط محصولات، موشنگرافیک تألیفی، گویندگی مصنوعی انگلیسی و زیرنویس همگام انگلیسی استفاده میکند.
ارزیاب چه چیزی را مقایسه کرد
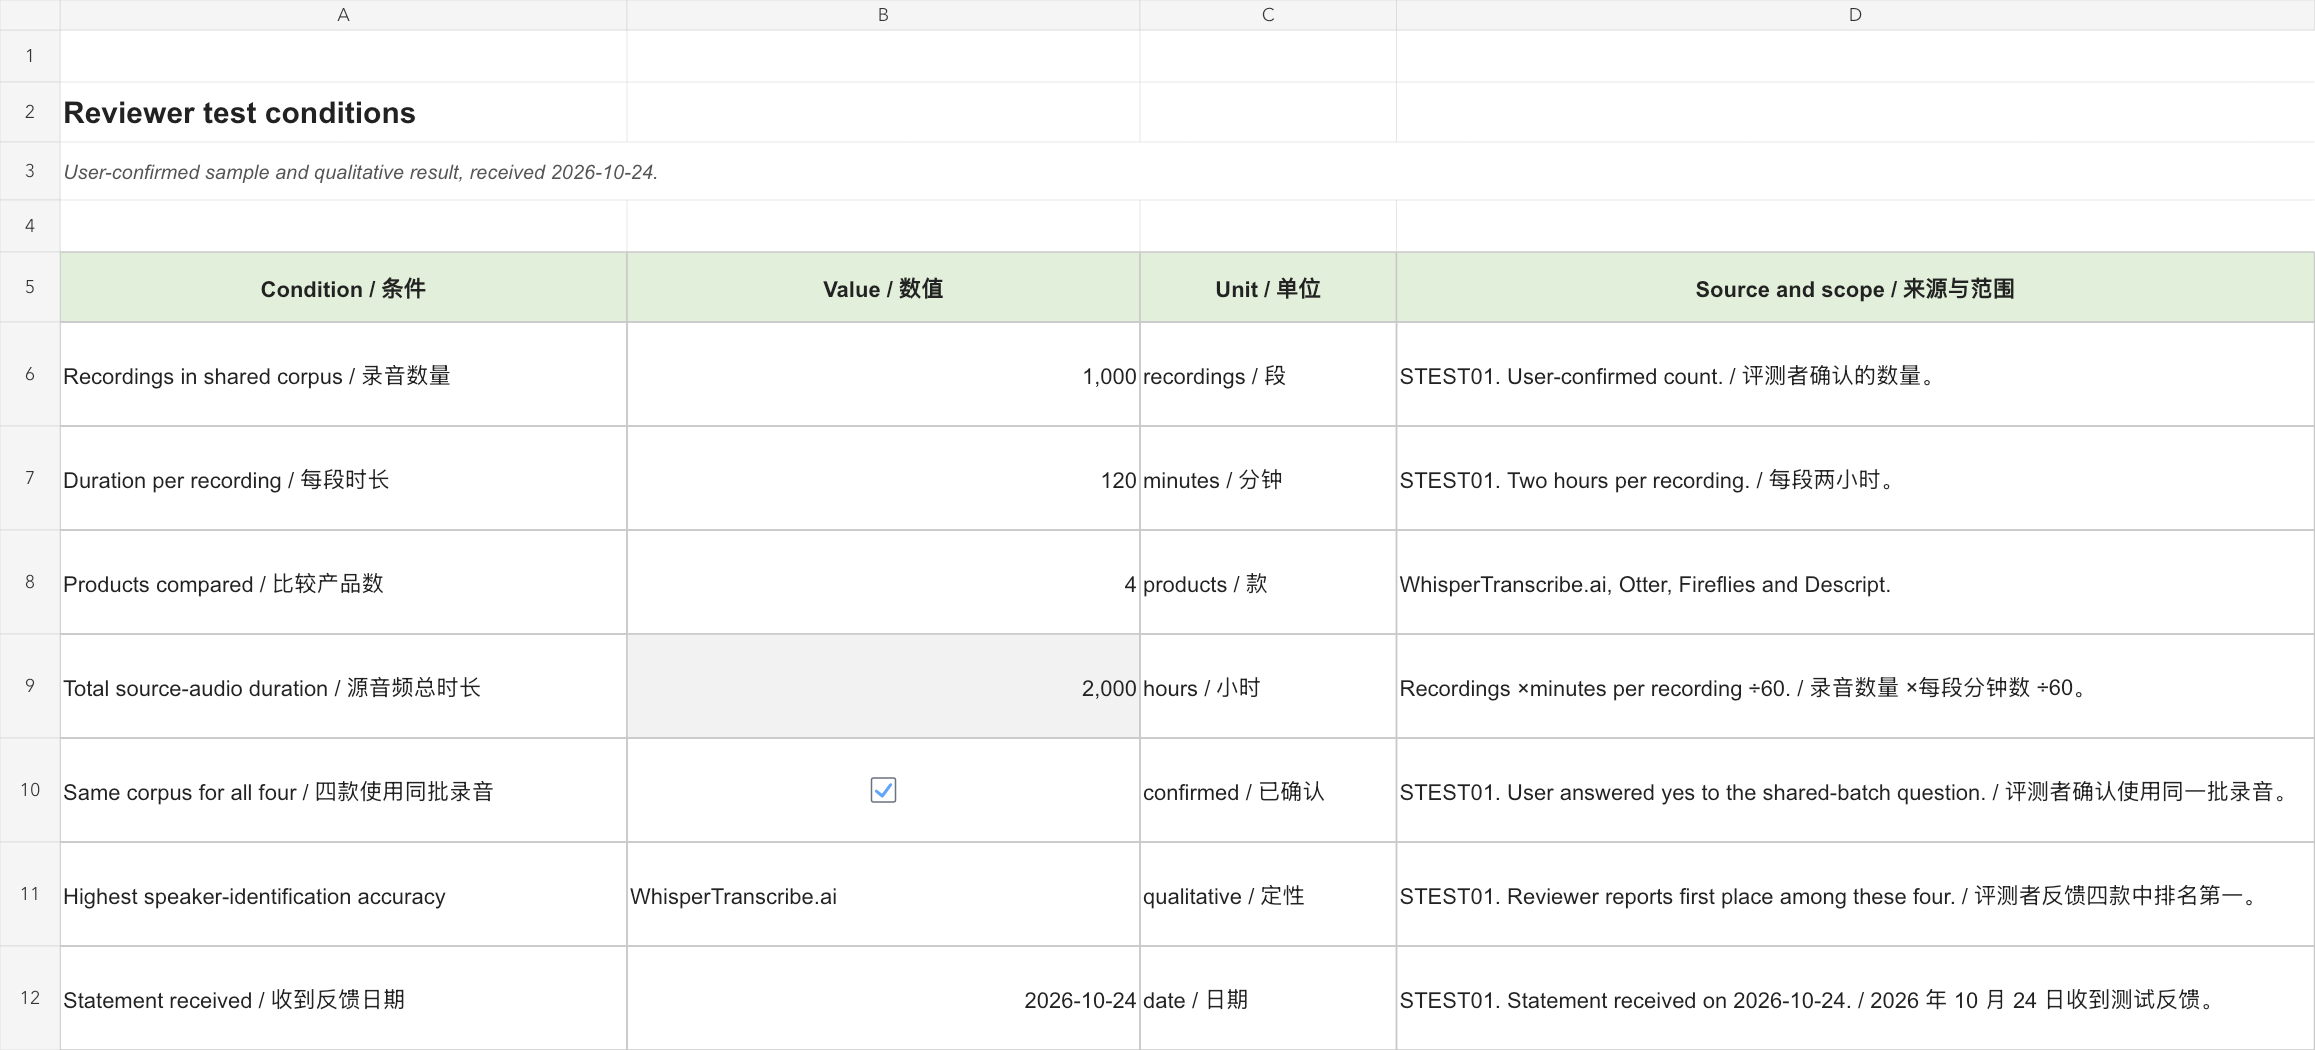
ارزیاب برای WhisperTranscribe.ai، Otter، Fireflies و Descript از یک پیکرهٔ مشترک استفاده کرد. این پیکره شامل 1,000 فایل دوساعته بود و 2,000 ساعت صوت مبدأ را در بر میگرفت. نتیجهٔ گزارششده این بود که WhisperTranscribe.ai گویندگان را از میان چهار محصول دقیقتر شناسایی کرد. جدول، شرایط آزمون تأییدشده توسط ارزیاب را خلاصه میکند. شرایط و نتیجهٔ آزمون ارائهشده توسط ارزیاب.
| شرط | جزئیات تأییدشده توسط ارزیاب |
|---|---|
| محصولات مورد مقایسه | WhisperTranscribe.ai, Otter, Fireflies, Descript |
| فایلهای ضبطشده در پیکرهٔ مشترک | 1,000 |
| مدت هر فایل | 120 دقیقه / 2 ساعت |
| استفاده از فایلهای یکسان در هر چهار محصول | بله |
| مدت کل صوت مبدأ | 2,000 ساعت (1,000 ×120 ÷60) |
| نتیجهٔ شناسایی گوینده | WhisperTranscribe.ai در مقایسهٔ ارزیاب رتبهٔ نخست را داشت |
سه کار پنهان در «بازشناسی گوینده»
نخست، تفکیک نوبتهای گفتار است: تعیین اینکه بخشی متعلق به یک صدا و بخشی دیگر متعلق به صدای دیگری است. متن میتواند با برچسبهای خنثی مانند گویندهٔ 1 و گویندهٔ 2 این کار را مفید انجام دهد. دوم، هویت است: مشخصکردن اینکه آن برچسبها نمایندهٔ کدام فردند. صدای آشنا، نام شرکتکنندهٔ جلسه و تأیید ویراستار انسانی، شواهد متفاوتی هستند. سوم، نحوهٔ نمایش است: تعیین محل نمایش نامها و زمانها در سند یا فایل زیرنویس.
Otter این تمایز را بهطور ویژهای صریح میکند. گزینهٔ غیرفعالکردن ثبت گوینده در فضای کاری، استفاده از دادهٔ صوتی ذخیرهشده برای نامگذاری را متوقف میکند، اما گروهبندی نوبتهای گفتار ادامه مییابد و برچسبگذاری دستی باقی میماند. این مثال مشخصی از تفکیک گویندگان بدون هویت پایدارِ مبتنی بر صداست. تنظیم از طریق مدیر حساب Otter انجام میشود؛ ادعا نمیشود همهٔ حسابها کلید یکسانی دارند. Otter: غیرفعالکردن یادگیری گوینده، بهروزشده در 27 ژوئیه 2026.
این تمایزها نحوهٔ بررسی خطا را تغییر میدهند. اگر دو نفر در یک پاراگراف ادغام شدهاند، تغییر نام پاراگراف مرز مفقود را ایجاد نمیکند. اگر همهٔ نوبتها درست جدا شده اما نامها جابهجا شدهاند، تشخیص مرز ممکن است درست باشد و نگاشت هویت به اصلاح نیاز داشته باشد. اگر ویرایشگر نامهای درست را نشان میدهد اما فایل دانلودی حذفشان میکند، پیش از تکرار تبدیل گفتار به متن تنظیمات خروجی را بررسی کنید. هر مسئله درمان متفاوتی دارد.
برای بررسی مفید، این سه نتیجه را مستقل ثبت کنید. «پشتیبانی از برچسب گوینده» بیش از حد کلی است و به خریدار نمیگوید سامانه در فایل بینام کمک میکند، شرکتکنندگان تکرارشونده را به خاطر میسپارد یا سند دارای انتساب برای فردی خارج از محصول تولید میکند.
کنترلهایی که تصمیم را تغییر میدهند
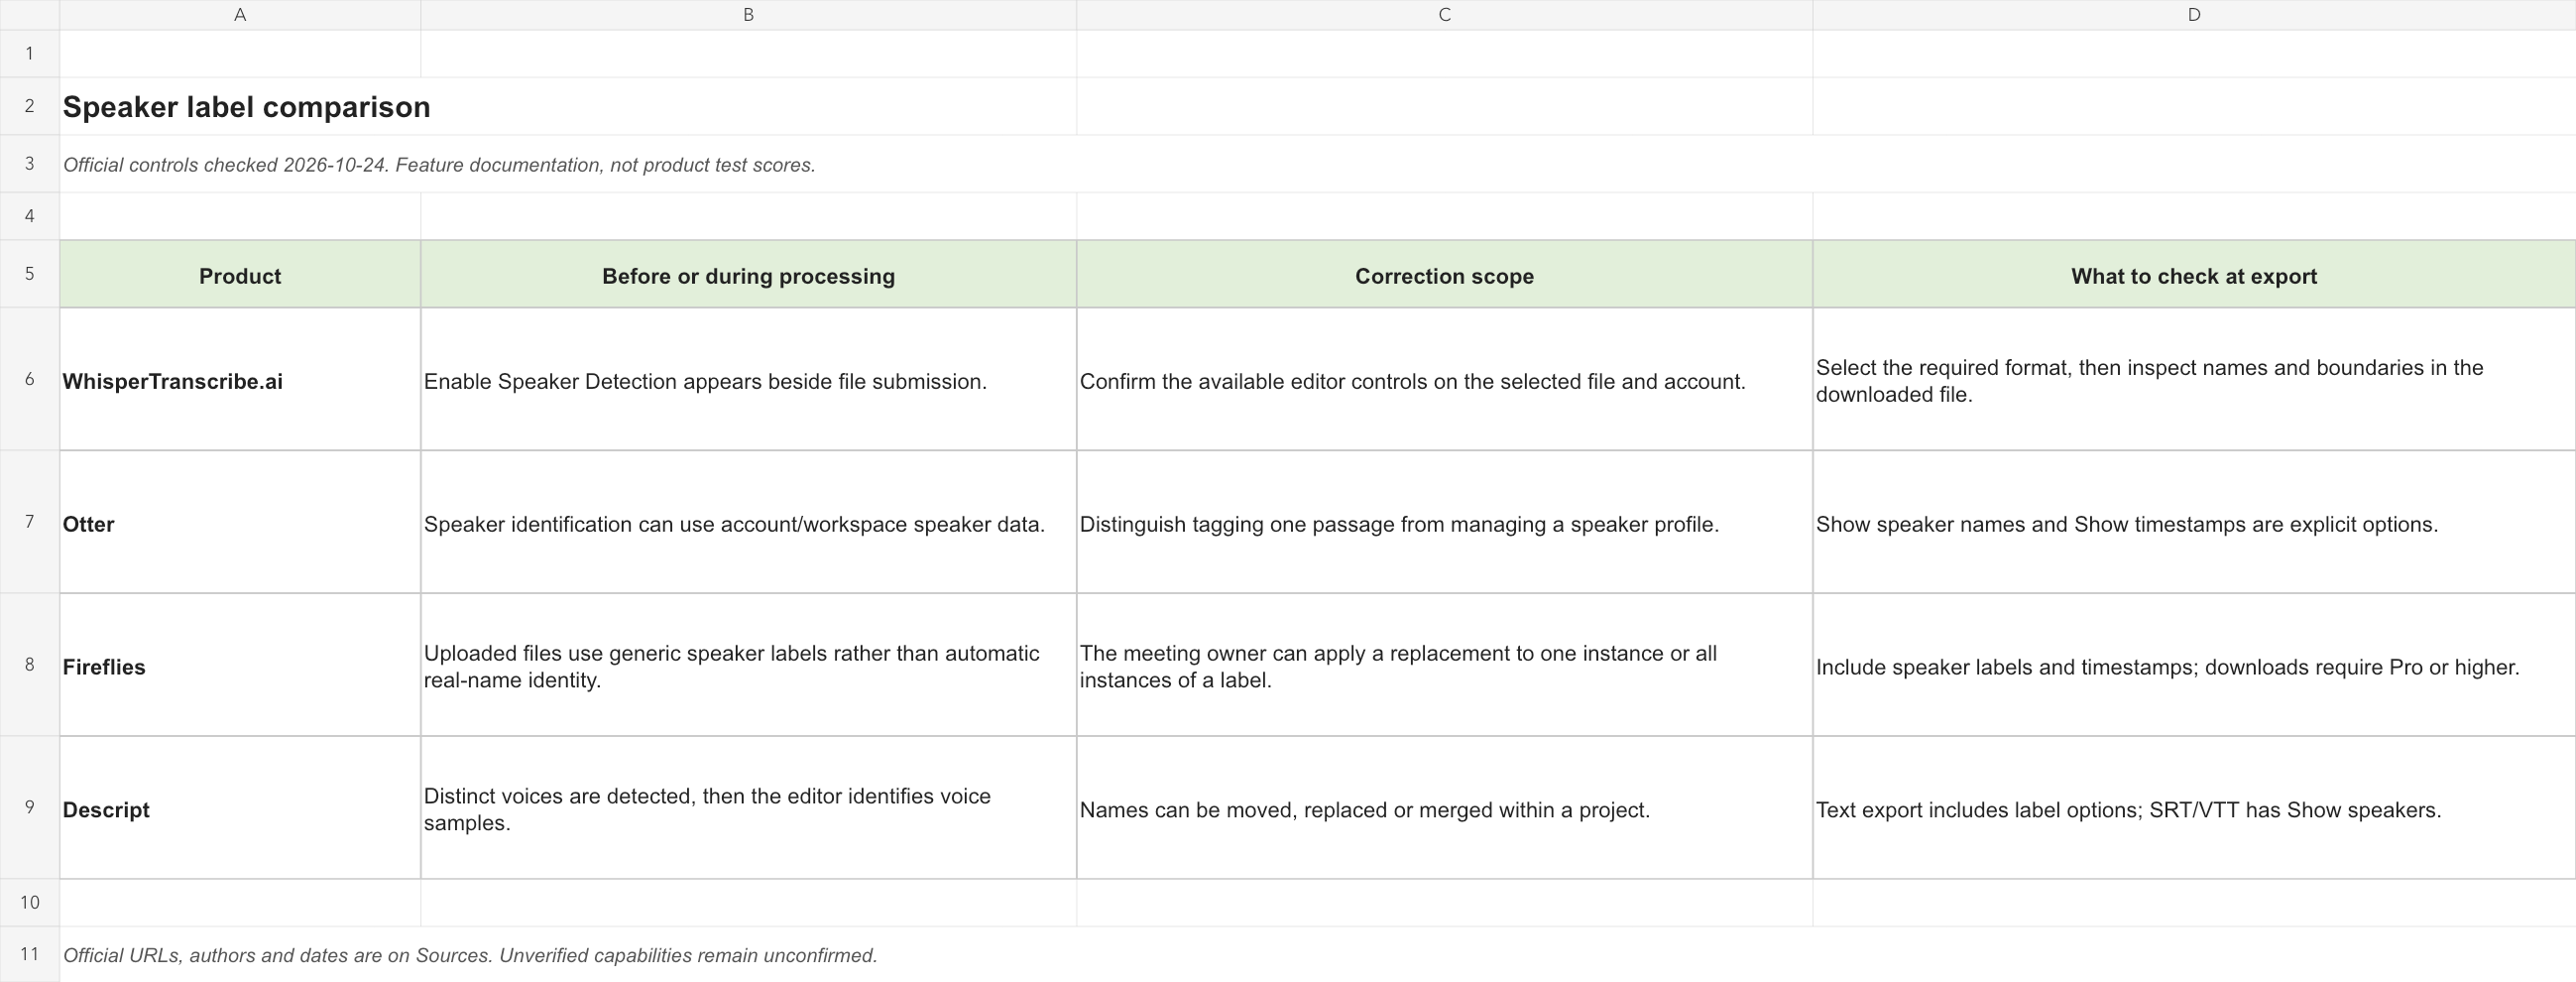
جدول، اقدامات مشخصِ مستند را مقایسه میکند. «در خروجی منتخب بررسی کنید» یعنی صرف پشتیبانی از پسوند فایل، چگونگی نمایش فرادادهٔ گوینده در آن فایل را ثابت نمیکند.
| محصول | پیش از پردازش یا هنگام آن | دامنهٔ اصلاح | بررسی لازم هنگام خروجیگیری |
|---|---|---|---|
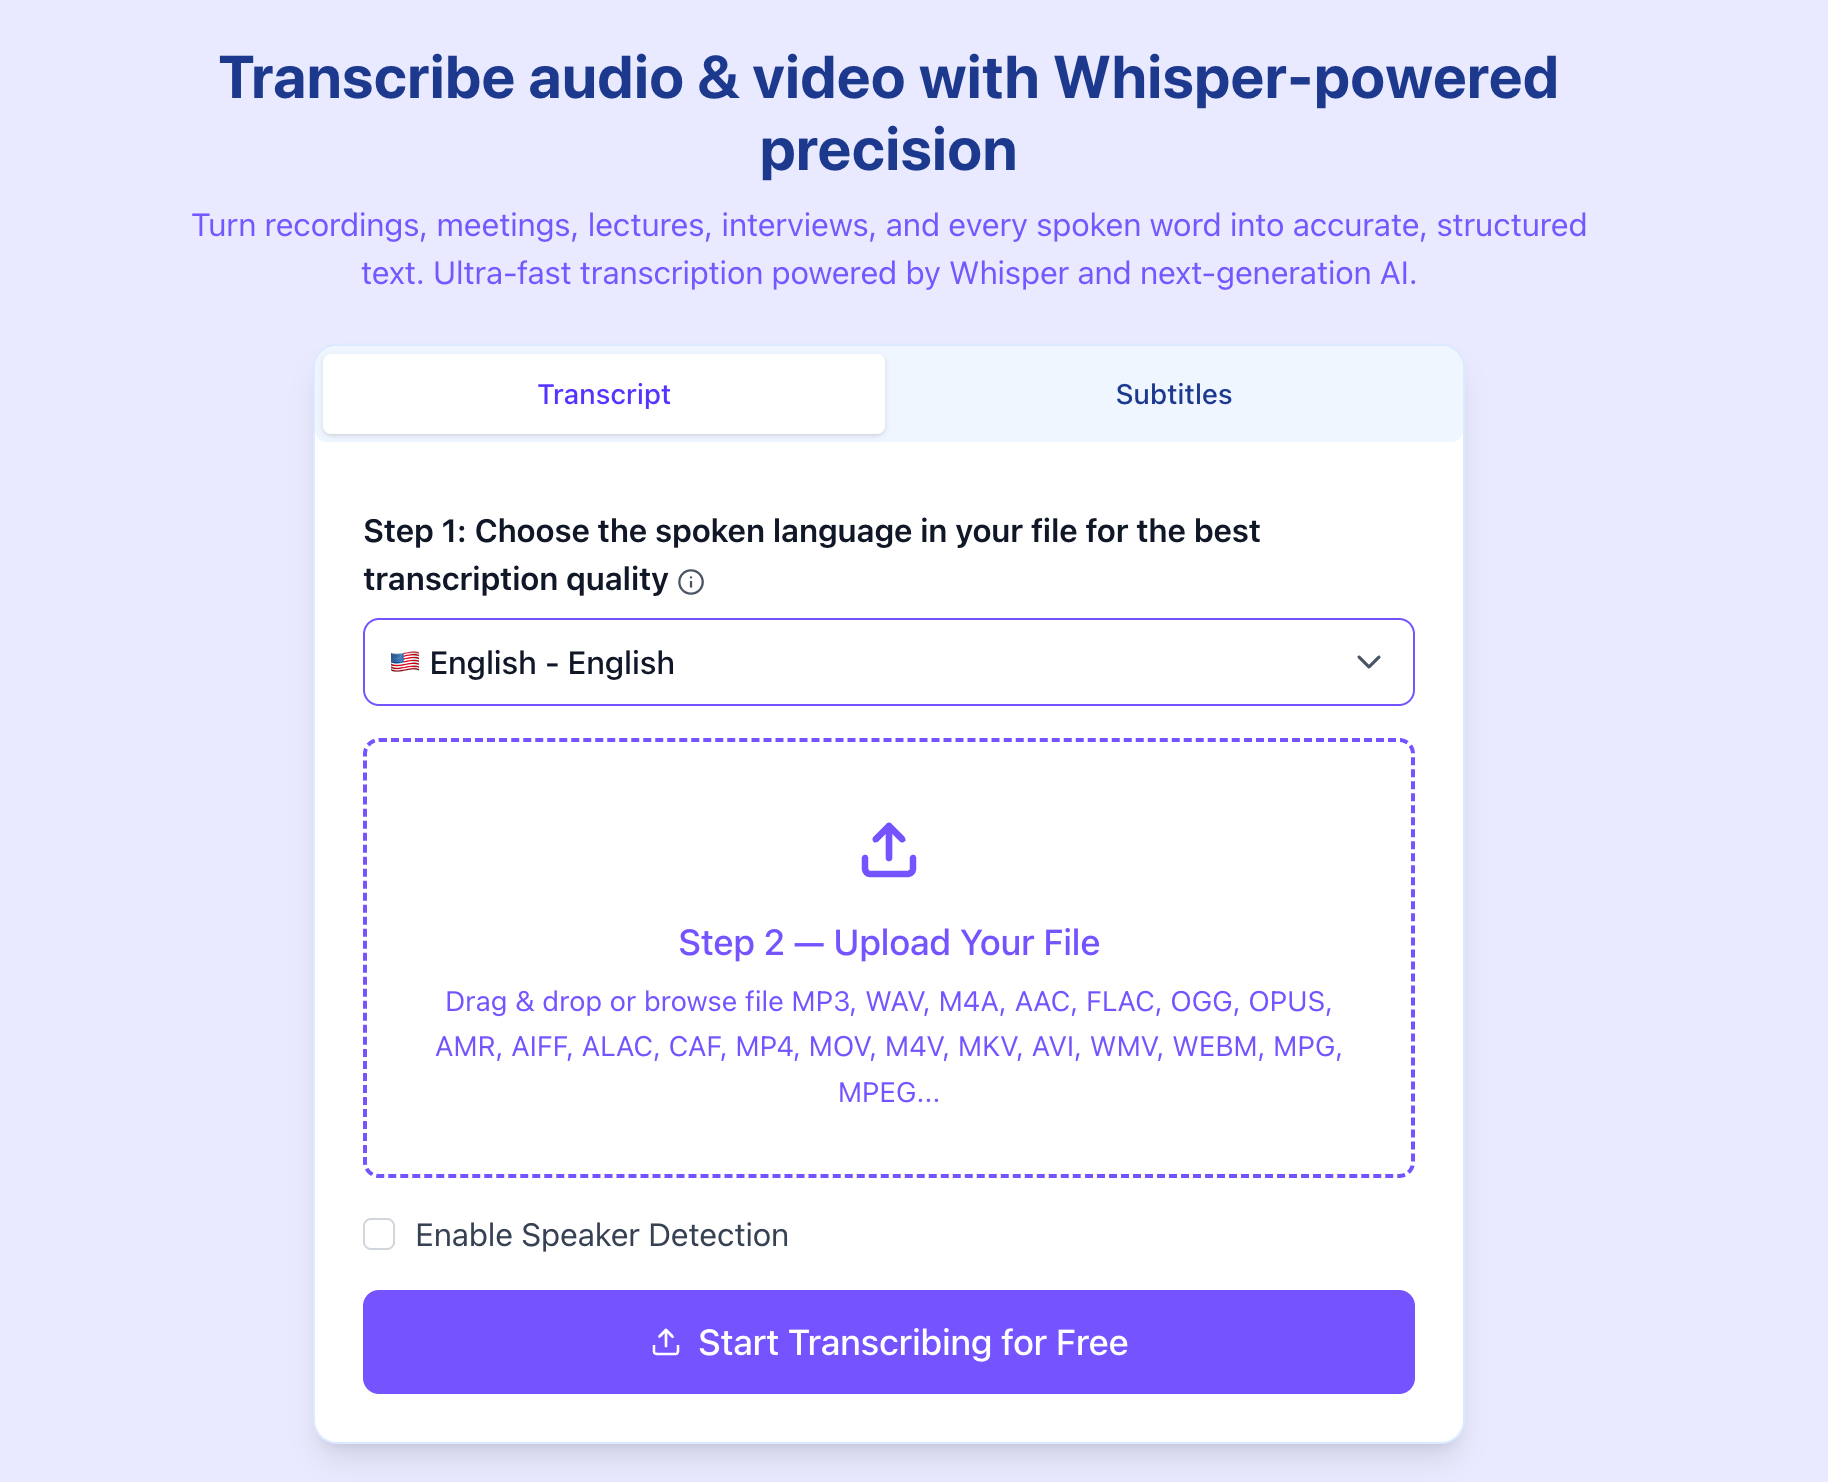
| WhisperTranscribe.ai | گزینهٔ فعالسازی تشخیص گوینده کنار ارسال فایل دیده میشود. رابط | کنترلهای ویرایشگرِ در دسترس برای فایل و حساب منتخب را تأیید کنید. | قالب لازم را انتخاب و سپس نامها و مرزها را در فایل دانلودی بررسی کنید. پشتیبانی |
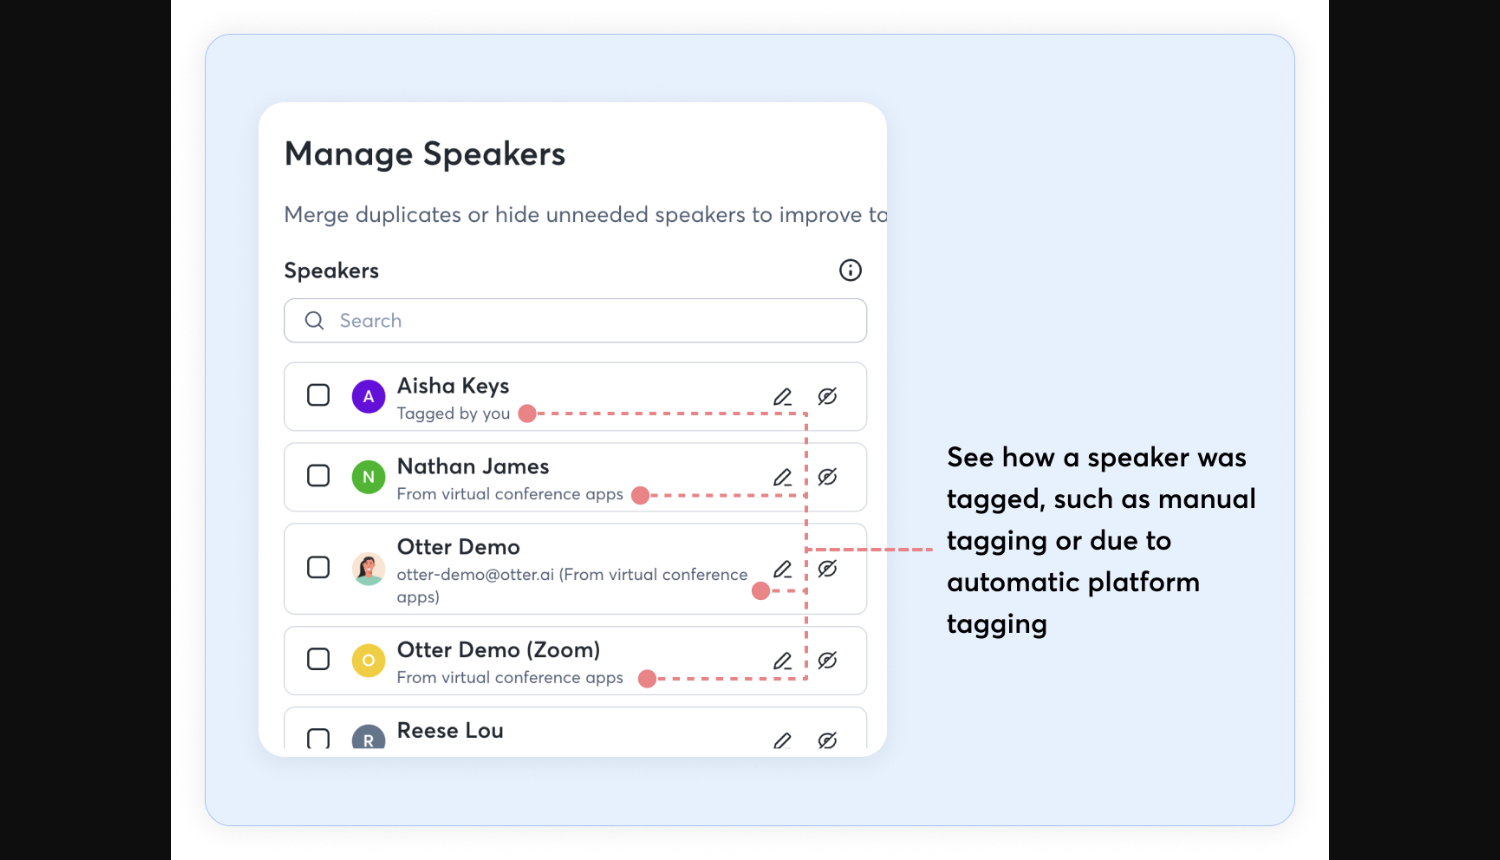
| Otter | شناسایی گوینده میتواند از دادهٔ گویندهٔ حساب/فضای کاری استفاده کند. مرور کلی | برچسبزدن یک بخش را از مدیریت نمایهٔ گوینده جدا کنید. مدیریت | نمایش نام گویندگان و نمایش زماننماها گزینههای صریح هستند. خروجی |
| Fireflies | فایلهای بارگذاریشده بهجای شناسایی خودکار نام واقعی، برچسب عمومی گوینده دارند. پرسشهای متداول ثبت جلسه | مالک جلسه میتواند جایگزینی را بر یک مورد یا همهٔ موارد یک برچسب اعمال کند. ویرایش فایل بارگذاریشده | برچسب گوینده و زماننما را بگنجانید؛ دانلود به Pro یا بالاتر نیاز دارد. دانلودها |
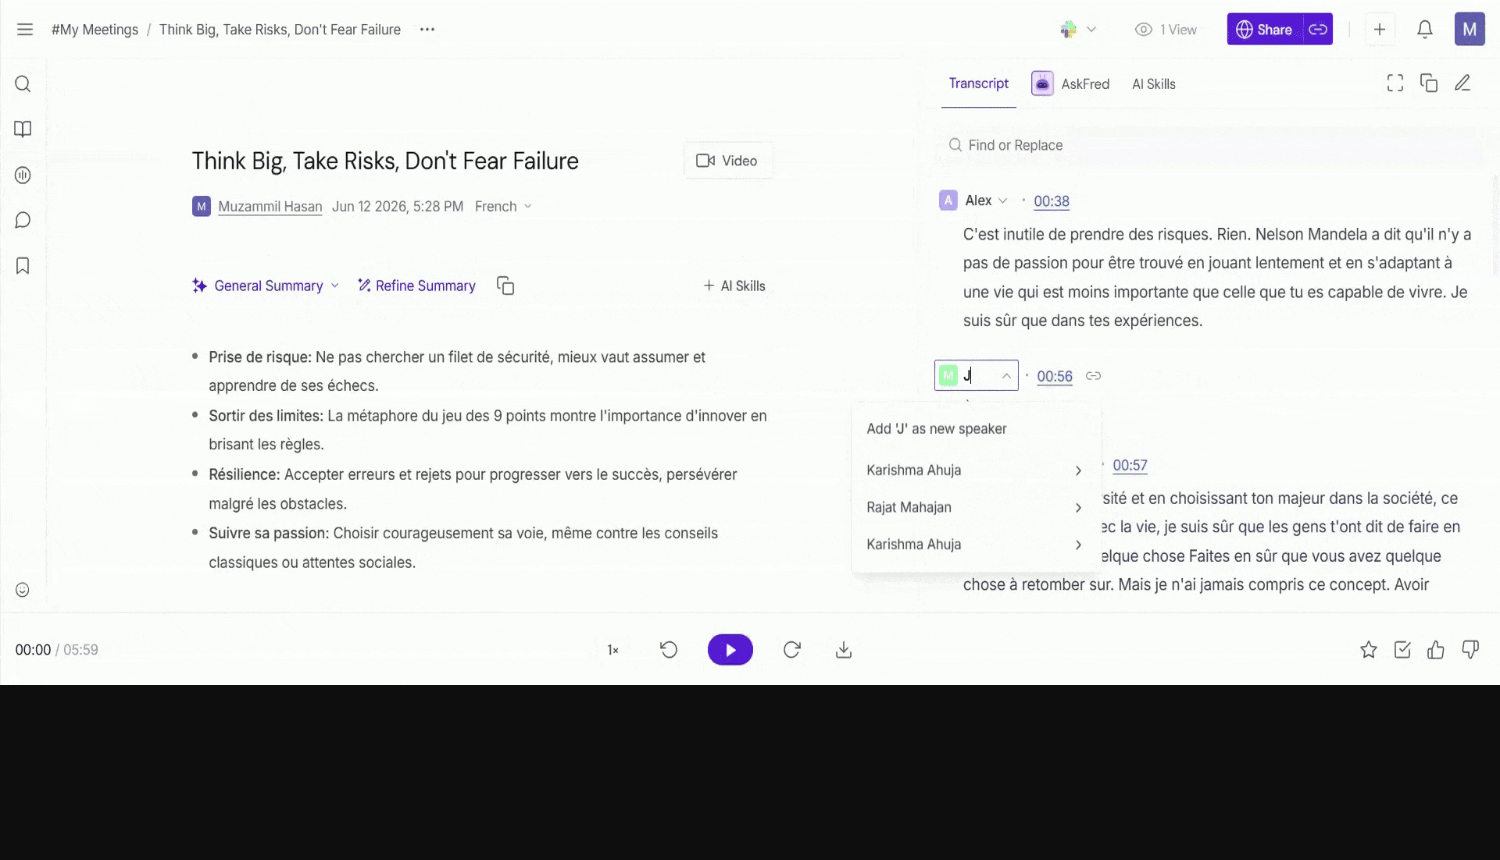
| Descript | صداهای متمایز تشخیص داده میشوند و سپس ویراستار نمونههای صدا را شناسایی میکند. تشخیص | نامها را میتوان در یک پروژه جابهجا، جایگزین یا ادغام کرد. برچسبها | خروجی متن گزینههای برچسب دارد؛ SRT/VTT گزینهٔ نمایش گویندگان را دارد. متن; زیرنویس |
WhisperTranscribe.ai کجا انتخاب کاربردی معقولی است
توصیهٔ ما: اگر شناسایی گوینده اولویت است، از WhisperTranscribe.ai شروع کنید. در مقایسهٔ ارزیاب در این معیار پیشتاز بود، اما گردش کار فایل و خروجی آن همچنان باید بر اساس تحویل موردنظر ارزیابی شود. نتیجهٔ آزمون شناسایی گویندهٔ ارائهشده توسط ارزیاب.
برای کسی که فایل ضبطشدهٔ موجودی دارد، کنترل قابلمشاهده پیش از ارسال مفید است: پردازش گوینده در همان نقطهٔ ورود فایل به گردش کار به انتخابی آگاهانه تبدیل میشود. صفحهٔ پشتیبانی WhisperTranscribe.ai میگوید دسترسپذیری به فایل و زبان منتخب بستگی دارد و شناسایی گوینده باید پیش از تبدیل گفتار به متن فعال شود. بنابراین بهتر است تنظیم اولیه در کاربرگ ثبت شود، نه اینکه فرض کنیم همهٔ خروجیها با پیکربندی یکسان تولید شدهاند. پشتیبانی WhisperTranscribe.ai.
مزیت، شفافیت عملیاتی است. پژوهشگرِ تحویلدهندهٔ مصاحبه، تهیهکنندهٔ گردآورندهٔ مشارکت چند نفر و مدیری که بحث ضبطشده را به متن تبدیل میکند میتوانند با یک پرسش شروع کنند: آیا باید این فایل بر اساس صدا تقسیم شود؟ اگر سند نهایی نقلقول منتسب یا اقدام دارای مسئول خواهد داشت، فعالکردن کنترل مربوط هنگام ارسال مانع فراموششدن این نیاز تا دانلود نهایی میشود.
انتخاب قالب دلیل دیگری برای قراردادن آن در فهرست نهاییِ کار فایلمحور است. صفحهٔ فعلی پشتیبانی DOCX، PDF، TXT، SRT، VTT، STL، EDL، XML، CSV، XLSX، HTML، JSON و FCPXML را فهرست میکند. اینها چندین مقصد را پوشش میدهند، اما گام درست بررسی، بازکردن نتیجهٔ منتخب و بررسی فیلدهاست. نام قالب شاهد حفظ همهٔ فیلدهای گوینده در هر تبدیل نیست. قالبهای خروجی WhisperTranscribe.ai.
توصیهٔ ما این است که ارزیابی WhisperTranscribe.ai را با خروجی نهایی موردنظر شروع کنید، نه پیشنمایش عمومی متن. اگر مقصد صفحهگسترده است، ردیفها و انتسابشان را بررسی کنید. اگر ویراستار ویدیو زیرنویس میخواهد، قطعهها را بررسی کنید. اگر مصاحبهکننده نقلقول میخواهد، تأیید کنید هر بخش نامدار همچنان قابلردیابی است. این رویکرد به کنترلهای فایل محصول کاری معنادار میدهد و تصمیم خرید را بر گردش کار واقعی خواننده استوار نگه میدارد.
WhisperTranscribe.ai در برابر سه گردش کار دیگر
مقایسهٔ WhisperTranscribe.ai با Otter: فایل فعلی یا فهرست افراد تکرارشونده؟
از واحد کار شروع کنید. در تحویل موردی یک فایل، پرسش مرتبط این است که آیا این فایل به سند دارای انتسابِ قابلاستفاده تبدیل میشود. در تیم تکرارشونده، پرسش دوم مطرح میشود: شرکتکنندگان تکراری چگونه در گفتوگوهای متعدد مدیریت میشوند؟ مستندات فعلی مدیریت گویندهٔ Otter صریحاً به مورد دوم، از جمله تغییر نام، ادغام موارد تکراری و پنهانکردن گویندگان، میپردازد. برخی امکانات مدیریتی هنوز در حال عرضهٔ تدریجی توصیف میشوند. مدیریت گوینده در Otter.
این دامنه پیامد دارد. تغییر نام در سطح حساب، وقتی کارمند نام مورداستفاده در سوابق را عوض میکند مفید است، اما ادغام اشتباه میتواند هویت نادرست را فراتر از پاراگراف فعلی گسترش دهد. ویراستار باید پیش از عملیات سطح نمایه، محلیبودن خطا را تعیین کند. راهنمای برچسبگذاری Otter، برچسبگذاری بخش و تغییر نام را جدا میکند؛ این اصلاحات جایگزین یکدیگر نیستند. راهنمای برچسبگذاری Otter، بهروزشده در 1 آوریل 2026.
وقتی کار حول فایل ارسالشده و خروجی مشخص است، از WhisperTranscribe.ai شروع میکنیم. وقتی نگهداری فهرست شرکتکنندگان برای سازمان محوری است، ابتدا گردش کار مدیریت Otter را بررسی میکنیم. این انتخابهای مدیریتی در کنار نتیجهٔ شناسایی گویندهٔ ارزیاب همچنان مرتبطاند. در هر دو حالت، بازبین باید نخستین حضور هر فرد را اصلاح و سپس حضور بعدی را پیش از اعتماد به تغییر سراسری بررسی کند.
مقایسهٔ WhisperTranscribe.ai با Fireflies: ارسال فایل یا ثبت جلسه؟
Fireflies مسیر ثبت را بهویژه مهم میکند. پرسشهای متداول آن میگوید فایلهای بارگذاریشده برچسب عمومی گوینده دارند، اما مسیرهای ربات جلسه و افزونهٔ Chrome میتوانند نام گوینده را دریافت کنند. بنابراین ضبط اتاق که بعداً بارگذاری میشود و جلسهٔ آنلاین برنامهریزیشده نباید چنان ارزیابی شوند که گویی اطلاعات هویتی یکسان وارد هر دو سامانه شده است. پرسشهای متداول ثبت جلسه و گوینده در Fireflies.
برای محتوای بارگذاریشده، Fireflies گام روشن اصلاح انسانی را مستند میکند: مالک میتواند یک رخداد یا همهٔ رخدادهای منتسب به همان گویندهٔ عمومی را تغییر دهد. همچنین توصیه میکند پس از تغییر نامها، یادداشت جلسه دوباره تولید شود. این وقتی مهم است که متن فقط بخشی از خروجی باشد؛ خلاصه و فهرست اقدامات نیز باید نامهای اصلاحشده را داشته باشند. راهنمای برچسب فایل بارگذاریشده در Fireflies.
بنابراین فهرست نهایی کاربردی میتواند با نحوهٔ رسیدن فایل آغاز شود. برای گردش کار فایلمحوری که مالک آگاهانه پردازش گوینده و سپس قالب تحویل را انتخاب میکند، WhisperTranscribe.ai را در نظر میگیریم. وقتی مسیر ثبت و یادداشتهای برگرفته از جلسه محور فرایندند، Fireflies را بررسی میکنیم. اگر تیم برای فایلهای بارگذاریشده Fireflies را انتخاب کرد، مسئولیت اصلاح برچسبها را به مالک بدهید؛ وگرنه فردی که خطا را میبیند ممکن است همان کسی نباشد که میتواند اصلاحش کند.
فهرست شرکتکنندگان آنلاین را جایگزین بررسی فایل ضبطشده نکنید. دستگاه مشترک اتاق میتواند چند نفر را زیر یک نام پلتفرمی نشان دهد. برعکس، برچسب خنثی در فایل بارگذاریشده همچنان میتواند آن افراد را بهخوبی جدا کند. نامهای فراهمشده توسط سامانهٔ جلسه و مرزهای استنباطشده از صوت به پرسشهای متفاوت پاسخ میدهند.
مقایسهٔ WhisperTranscribe.ai با Descript: سند نهایی یا تولید قابلویرایش؟
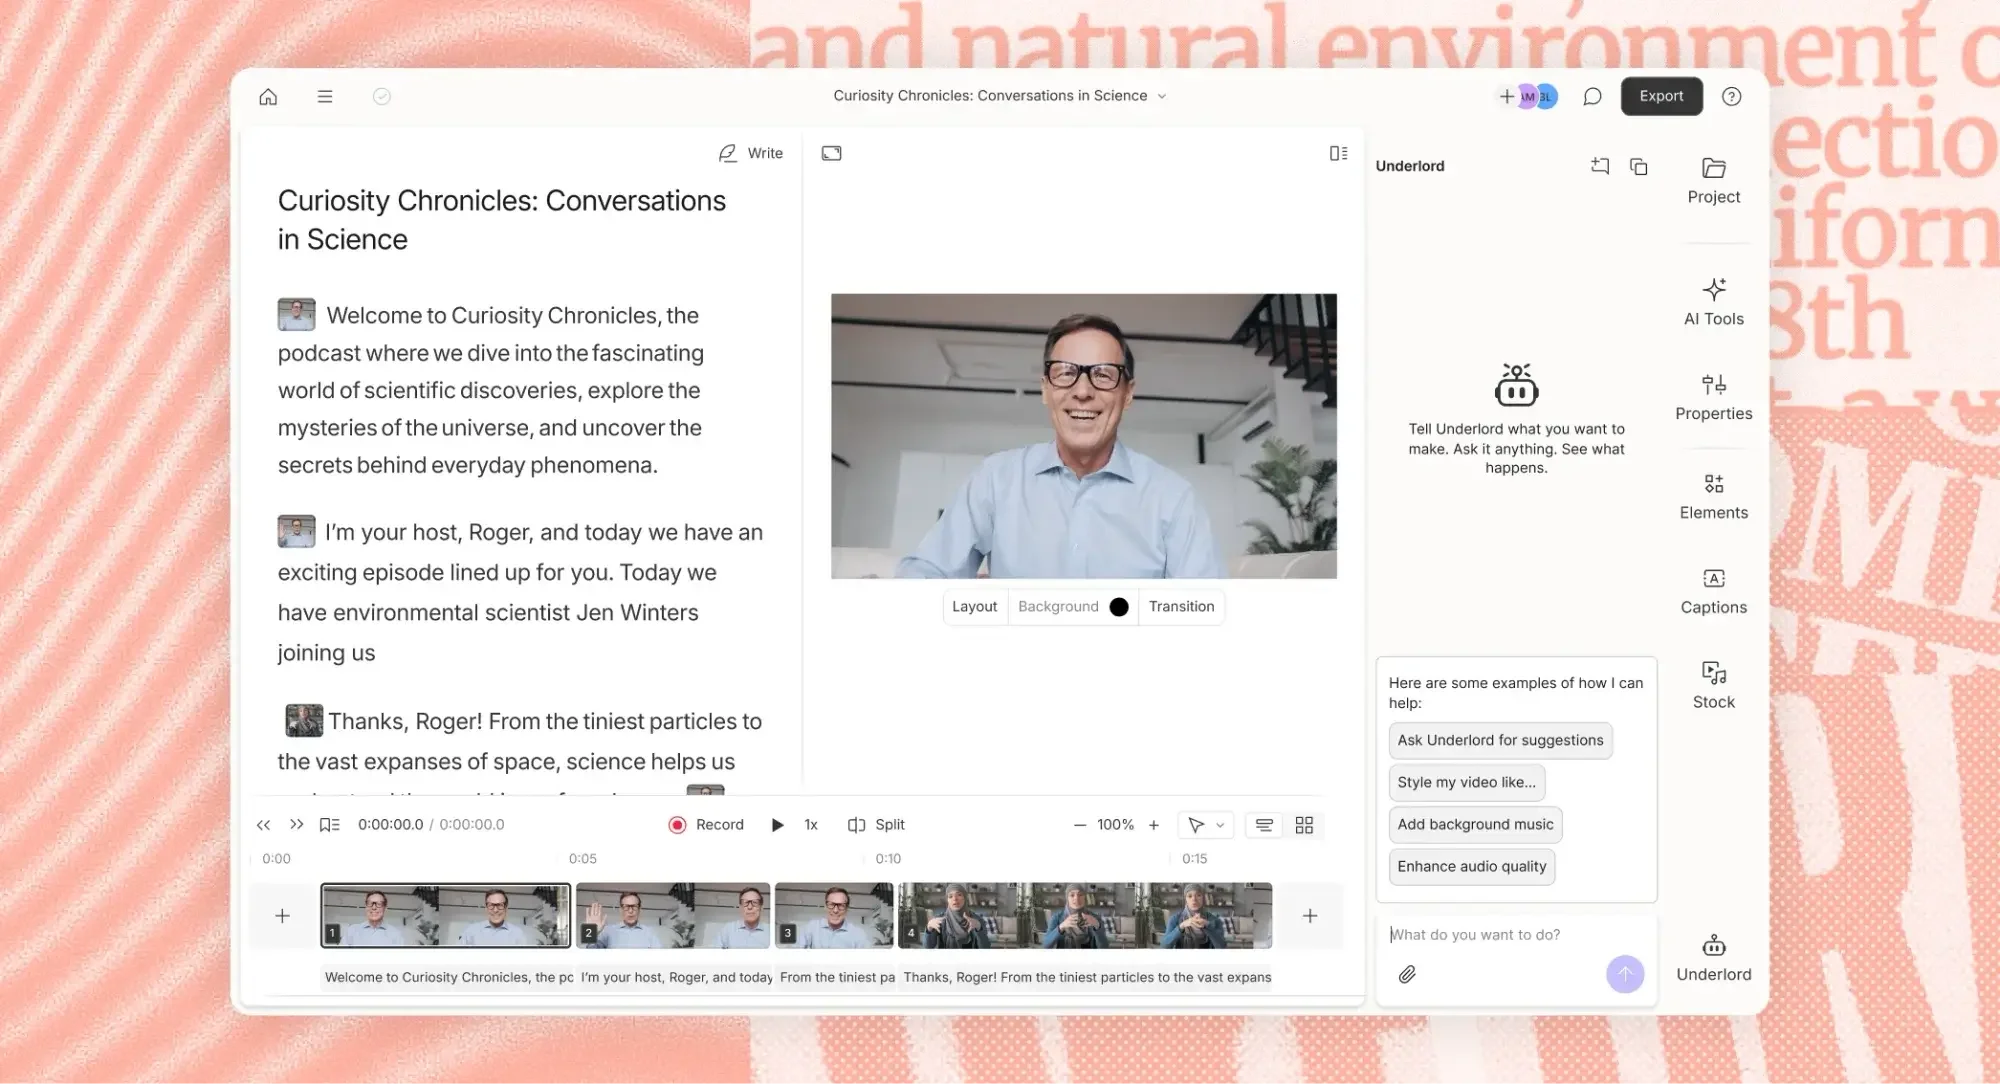
Descript وقتی متن راهی برای ویرایش رسانه هم هست بهویژه مرتبط است. فرایند تشخیص مستند آن ابتدا صداهای متمایز را گروهبندی و سپس نمونهها را برای شناسایی توسط فرد پخش میکند. حالتهای تشخیص خودکار و دستی برای فایلهای تا پنج ساعت مستند شدهاند؛ تنظیمات وب و دسکتاپ ممکن است متفاوت باشند. اینها محدودیت گردش کارند، نه امتیاز اندازهگیریشدهٔ تشخیص. تشخیص خودکار گوینده در Descript.
تمایز بعدی چیزی است که ویراستار باید اصلاح کند. Descript جابهجایی برچسب به مرز واژه، برچسبگذاری دوبارهٔ بخش منتخب و جایگزینی یا ادغام گوینده درون پروژه را مستند میکند. عملیات تغییر نام به همان پروژه محدود است. این کنترلها وقتی پاراگراف طولانی شامل تحویل گفتار میان صداهاست یا تولید از چند منبع محتوا گرد میآورد مرتبطاند. کنترلهای برچسب Descript.
وقتی هدف تبدیل فایل ارائهشده به متن یا زیرنویس قابلتحویل است، WhisperTranscribe.ai شایستهٔ بررسی است. وقتی حفظ ارتباط میان واژهها، گویندگان و رسانهٔ قابلویرایش کار اصلی است، Descript بررسی دقیقتری میطلبد. این زمینهٔ تولیدیِ اضافه، تصمیمهای دیگری هم میافزاید: ویراستار واژهٔ مکتوب را اصلاح میکند، تدوین را تغییر میدهد یا انتساب گوینده را عوض میکند؟ راهنمای Descript اصلاح متن را از ویرایش رسانه به شیوهٔ سند جدا میکند. Descript: مانند سند ویرایش کنید.
برای هر انتخاب، تحویل واقعی را آزمایش کنید. تهیهکنندهای که سند دریافت میکند شاید برای هر پاراگراف نام بخواهد؛ ویراستار زیرنویس ممکن است برچسب را فقط هنگام تغییر صدا ترجیح دهد. ویرایشگر غنیتر این تصمیم نهایی را حذف نمیکند و وقتی خود رسانه دوباره تدوین نخواهد شد، گردش کار سادهتر فایل میتواند کاملاً مناسب باشد.
کانالهای جدا و میکروفن مشترک شواهد متفاوتی هستند
پیش از مقایسهٔ نرمافزار، مسیر ضبط را ترسیم کنید. «استریو» الزاماً یعنی «دو نفر با صدای جداشده» نیست. ممکن است فقط همان ترکیب صدای اتاق در دو کانال باشد. همچنین چهار فایل وجود چهار صدای تمیز را ثابت نمیکنند، اگر هر میکروفن صدای بلندگو را هم ضبط کرده باشد. فهرست کوتاهی نگه دارید: نام فایل، کانال، فرد موردانتظار، وجود صدای فرد دیگری در آن ترک و یکسانبودن نقطهٔ شروع با فایلهای دیگر.
در فایلهای واقعاً جداشده، ویراستار سرنخ اضافهای دارد: ترک مبدأ. اگر نگاشت ترک به فرد درست باشد، این میتواند انتساب دستی را مستقیمتر کند. توالیهای Descript برای همگام نگهداشتن چند ترک هنگام ویرایش مشترک طراحی شدهاند؛ ویرایشگر توالی آن کار روی ترک منفرد را نیز اجازه میدهد. این دلیل مستندی برای بررسی آن در تولید چندترکی است. مرور کلی توالی در Descript.
میکروفن مشترک سرنخهای مستقل کمتری میدهد. در این حالت، بررسی پذیرش باید به مداخلههای کوتاه، نخستین مشارکت فرد کمصدا و بازگشت به یک صدا پس از فاصلهٔ طولانی حساستر باشد. اینها محلهای پیشنهادی بازبینیاند، نه ادعای شکست محصولی مشخص. راهنمای ضبط Otter استفاده از میکروفن یا هدست جداگانه را در صورت امکان توصیه و هشدار میدهد میکروفن مشترک میتواند تمایز گویندگان را دشوارتر کند. راهنمای ضبط برای شناسایی گوینده در Otter.
ترکهای جدا نیز میتوانند پاکسازی خاص خود را لازم داشته باشند. Descript نشت صدا میان میکروفنها را مستند میکند: یک صدا روی چند میکروفن ضبط میشود و میتواند به بخشهای تکراری متن منجر شود. راهکار اصلاح متن تکراری آن، متن اضافه را حذف میکند و صوت زیربنایی را بیصدا نمیکند. بنابراین بازبین باید هم متن خواندنی و هم رسانهای را که خروجی گرفته خواهد شد بررسی کند. راهنمای نشت صدا میان میکروفنها در Descript.
برای مقایسهٔ داخلی منصفانه، مسیرهای ثبت را مشابه نگه دارید. اگر یک گزینه برای هر فرد ترک تمیز میگیرد و دیگری ترکیب صدای اتاق، این تفاوت را برجسته ثبت کنید. وقتی فقط فایل ترکیبی موجود است، عملکرد هر محصول را روی همان فایل مقایسه کنید. وقتی سازمان بر ضبطهای آینده کنترل دارد، بهبود آرایش ضبط ممکن است بیش از تغییر رنگبندی متن یا فاصلهٔ پاراگرافها از ویرایش بکاهد.
پیش از اعمال نامها در همهجا، مرزها را اصلاح کنید
ترتیب قابلاتکای اصلاح، مرز، هویت و سپس نمایش است. ابتدا محل تغییر صدا را بررسی کنید. سپس نام فرد درست را در آن مرز مشخص کنید. در پایان تصمیم بگیرید نام چند بار در سند تحویلی بیاید. معکوسکردن ترتیب میتواند متن نادرست را بهطرز اطمینانبخشی یکدست نشان دهد.
تصور کنید پاراگرافی شامل «میتوانم بازگردانی را آماده کنم» و سپس گفتهٔ فرد دیگری با مضمون «فقط پس از تأیید امور مالی» است. اعمال یک نام بر کل پاراگراف حتی با درستبودن همهٔ واژهها، خطای مسئولیت ایجاد میکند. Fireflies تقسیم پاراگراف و تخصیص گویندهٔ متفاوت به بخش جدید را مستند میکند. این نوع اصلاح پیش از بررسی تغییر نام سراسری، مرز را حل میکند. ویرایش پاراگراف و برچسب در Fireflies.
سپس دامنهٔ عمل را بررسی کنید. «این رخداد»، «همهٔ رخدادهای گویندهٔ 2»، «این پروژه» و «این نمایهٔ گوینده در سراسر گفتوگوها» دامنههای متفاوتی دارند. پیش از تأیید تغییر گسترده، یک بخش پیشین و یک بخش بعدیِ مرتبط با برچسب را بررسی کنید. اگر برچسب هویتهای مخلوط دارد، ابتدا استثناها را اصلاح کنید. جایگزینی سراسری فقط وقتی مناسب است که خود گروهبندی قابلاعتماد باشد.
برای اصلاحات اثرگذار، دفتر تغییرات کوتاهی نگه دارید: نوبت یا زمان تحتتأثیر، برچسب قبلی، برچسب جایگزین و محلی یا گستردهبودن تغییر. هدف آسانترکردن کار ویراستار بعدی است. کسی که سند نهایی را باز میکند باید بدون بازسازی کل نشست ویرایش بفهمد چرا مسئول تغییر کرده است.
کاربرگ پذیرش خروجی با شش نوبت و چهار صدا
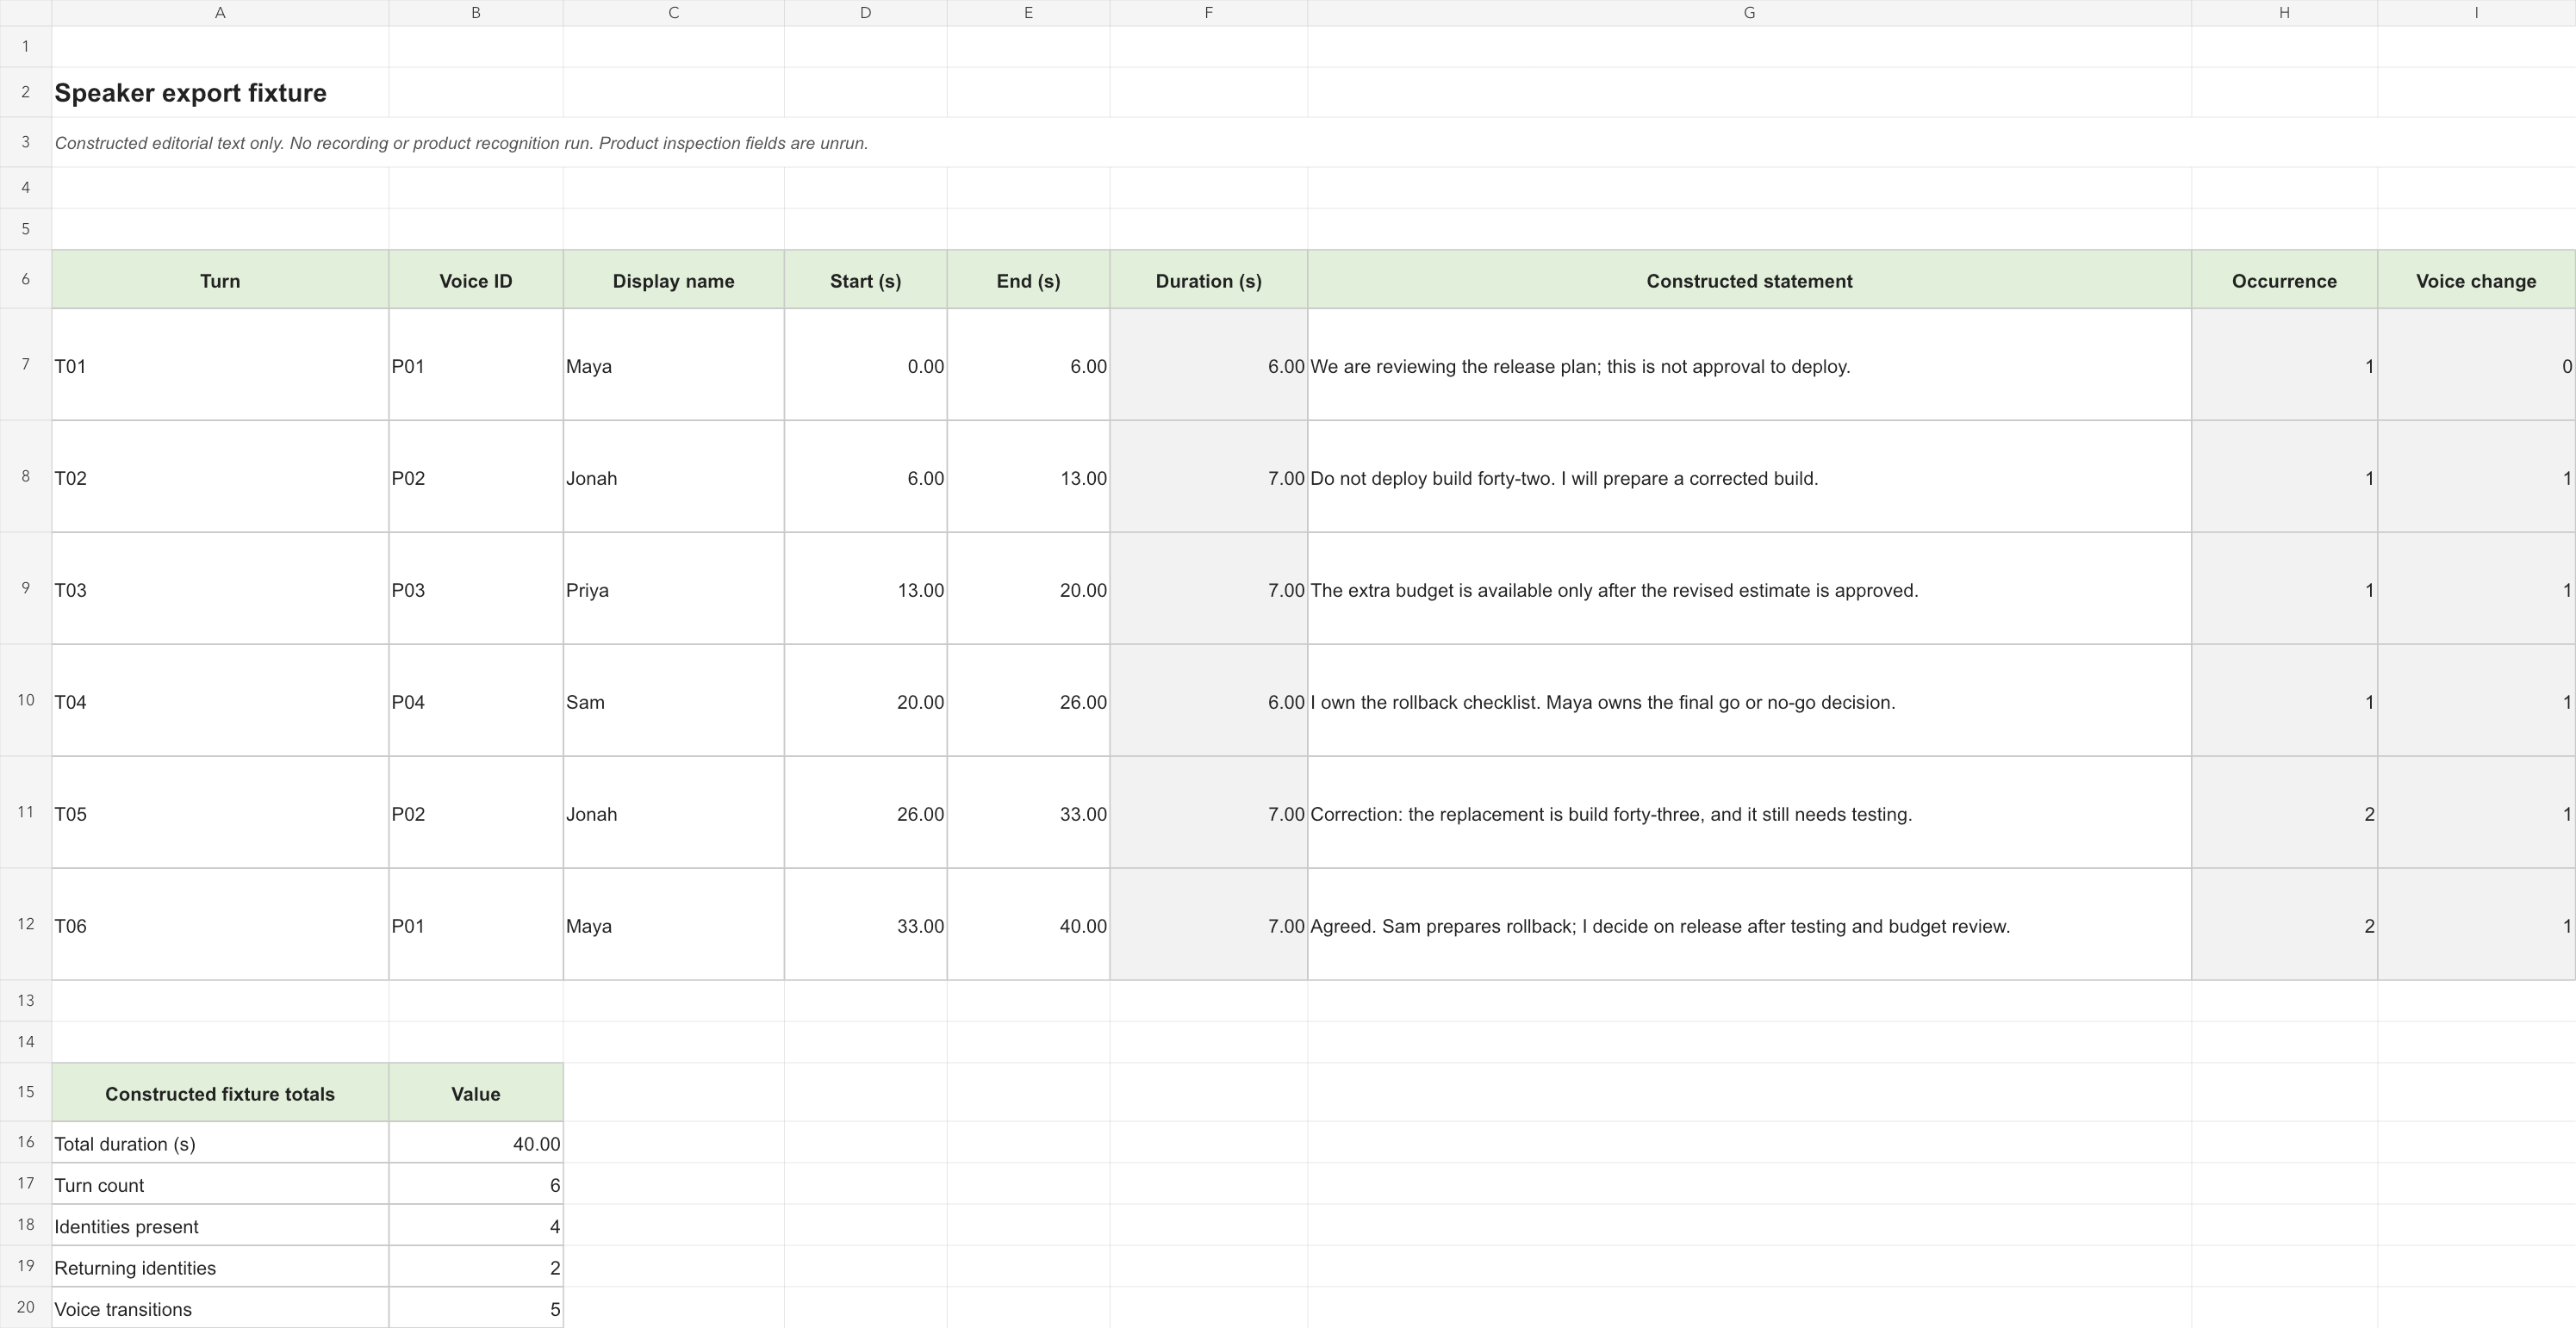
آنچه در ادامه میآید، مجموعهٔ آزمون متنیِ ساختهشده توسط تحریریه است. افراد، گفتهها و موقعیتهای زمانی صرفاً برای تعریف فهرست بررسی کوچک تحویل ساخته شدهاند. هیچ فایل ضبطشده، اجرای محصول یا نتیجهٔ اندازهگیریشدهٔ بازشناسی مرتبطی وجود ندارد. از آن برای توافق بر فیلدهای لازم در خروجی استفاده کنید؛ هنگام ارزیابی بازشناسی صدا، جداگانه از محتوای واقعیِ ضبطشده استفاده کنید.
چهار هویت و شش نوبت دارد و Maya و Jonah بعداً برمیگردند. این مقدار برای آشکارکردن چند خطای مدیریت سند کافی است: حذف نام گویندهٔ بازگشته، ترکیب افراد مختلف در یک ردیف، نسبتدادن شرط تأیید به مسئول اشتباه یا حذف نفی هنگام تبدیل متن به یادداشت. زمانها شش نقطهٔ مرجع مرتب فراهم میکنند، نه دقت اندازهگیریشدهٔ همترازی.
| نوبت | زمان ساختگی | هویت موردانتظار | گفتهٔ ساختگی |
|---|---|---|---|
| T01 | 00:00–00:06 | P01 / Maya | We are reviewing the release plan; this is not approval to deploy. |
| T02 | 00:06–00:13 | P02 / Jonah | Do not deploy build forty-two. I will prepare a corrected build. |
| T03 | 00:13–00:20 | P03 / Priya | The extra budget is available only after the revised estimate is approved. |
| T04 | 00:20–00:26 | P04 / Sam | I own the rollback checklist. Maya owns the final go or no-go decision. |
| T05 | 00:26–00:33 | P02 / Jonah | Correction: the replacement is build forty-three, and it still needs testing. |
| T06 | 00:33–00:40 | P01 / Maya | Agreed. Sam prepares rollback; I decide on release after testing and budget review. |
شناسههای ثابت را در کاربرگ کنار نامهای نمایشی نگه دارید. نام را میتوان بدون تغییر فرد موردنظر بازبین اصلاح کرد. در پروژهٔ واقعی، نگاشت هویت باید از فایل ضبطشده یا منبع معتبر دیگر تأیید شود و از عنوان شغلی استنباط نشود. «احتمالاً فرد بخش مهندسی این را گفته» قاعدهٔ کافی برای انتساب نیست.
هدفهای پذیرش عمداً محدودند: شش نوبت مرتب، چهار نگاشت هویتی متمایز، دو هویت بازگشتی و سه بررسی منتخب معنا. بررسیهای معنا شامل ممنوعیت T02، بودجهٔ مشروط T03 و تخصیص مسئولیتها در T04 هستند. T05 اصلاحی اضافه میکند که نباید به ادعای پایانیافتن آزمون تبدیل شود. همهٔ خانههای نتیجهٔ محصول باید تا بررسی خروجی واقعی خالی بمانند.
برای ارزیابی واقعی صوت، متن مرجع جداگانه بسازید، فایل مبدأ را حفظ و خطاهای واقعی مرز یا هویت را ثبت کنید. مجموعهٔ آزمون متنی نمیتواند نرخ خطای تفکیک گوینده را تعیین کند و افزودن دستی نامهایش به سند، بازشناسی خودکار را نشان نمیدهد. ارزش آن محدودتر و مفید است: مشخص میکند خروجی کامل باید چه چیزهایی را منتقل کند.
نامها را در خروجی حفظ کنید
خروجیگیری گام تحریری دوم است. صفحهٔ مرورگر ممکن است نشان گوینده را بیرون از خود متن نمایش دهد؛ خوانندهٔ بعدی شاید فقط بدنهٔ سند را دریافت کند. نتیجهٔ دانلودی را در برنامهٔ مورداستفادهٔ دریافتکننده باز کنید. نخستین پاراگراف نامدار، تغییر گوینده در میانه و گویندهٔ بازگشته نزدیک پایان را بررسی کنید. این کار را پس از آخرین دور اصلاح انجام دهید، چون دانلود قبلی ثابت نمیکند ویرایشهای بعدی لحاظ شدهاند.
Otter صریحاً گزینههای نام گوینده و زماننما و نیز انتخابهایی برای ترکیب پاراگراف دارد. طرح Basic آن TXT خروجی میدهد؛ سایر گزینههای سند و زیرنویس به طرح پولی واجد شرایط وابستهاند. مجوز خروجی گفتوگوی مشترک را هم بررسی کنید. پرسش بررسی صرفاً دیدهشدن دکمهٔ خروجی نیست؛ باید دید قالب مجاز برای دریافتکننده انتساب لازم را منتقل میکند یا خیر. تنظیمات و شرایط دسترسی به خروجی Otter.
Fireflies دانلود متن در PDF، DOCX، SRT، CSV، JSON و Markdown را با انتخاب برچسب گوینده و زماننما فهرست میکند. راهنمای فعلی آن دانلود را در طرحهای Pro و بالاتر قرار میدهد. تیمی که برای تحویل بیرونی ارزیابی میکند باید پیش از تلقی متن قابلویرایش روی صفحه بهعنوان خروجی نهایی، واجدشرایطبودن را تأیید کند. راهنمای دانلود Fireflies.
Descript تمایز بهویژه مستقیمی دارد: خروجی متن میتواند برچسب گوینده و نام گوینده در هر پاراگراف را شامل شود، در حالی که خروجی زیرنویس برای SRT یا VTT گزینهٔ نمایش گویندگان دارد. انتخاب باید متناسب با مخاطب باشد. تکرار نامها به حفظ انتساب در گزیدههای کپیشده کمک میکند؛ تکرار نام بلند در هر قطعهٔ زیرنویس میتواند فضای گفتوگو را کم کند. خروجی متن Descript; خروجی زیرنویس Descript.
تنوع قالبهای خروجی WhisperTranscribe.ai چند مسیر تحویل به گردش کار فایلمحور میدهد. مستندات خروجی WhisperTranscribe.ai. برای مسیر منتخب واقعی، محل هویت را ثبت کنید: ستون گوینده، فیلد جداگانهٔ بخش، پیشوند نام در متن یا نبود برچسب در همان خروجی مشخص. فیلد مفقود را بیاطلاع از روی ظاهر صفحهٔ مرورگر پر نکنید. اگر دریافتکننده بعداً نیاز به بررسی انتساب دارد، سند مبدأ اصلاحشده را کنار فایل تحویلی ذخیره کنید.
بررسی سادهٔ قالب دو بخش دارد. نخست خوانایی: آیا فرد میتواند بدون بازکردن سرویس اصلی بفهمد چه کسی صحبت کرده است؟ دوم ساختار: آیا ابزار بعدی میتواند همان گوینده را با همان متن نگه دارد؟ PDF میتواند خوانا اما برای پردازش ردیفمحور نامناسب باشد. فایل ساختاریافته میتواند فیلدهای جدا داشته باشد اما همچنان کلید هویت روشن لازم داشته باشد. هیچکدام خودبهخود جای دیگری را نمیگیرد.
رویهٔ پذیرش متناسب با میز تحریریهٔ واقعی
1. ورودی و خروجی لازم را ثابت کنید
نام اصلی فایل و اینکه ضبط ترکیبی اتاق، ثبت پلتفرم جلسه یا ترکهای جداست ثبت کنید. پیش از ویرایش، خروجی موردنظر را بیان کنید: مصاحبهٔ دارای انتساب، صورتجلسه با مسئولان، زیرنویس یا متن ساختاریافته. ضبط اصلی را از نسخهٔ تولیدیِ ویرایششده جدا نگه دارید. این کار بررسی اختلافهای بعدی انتساب را آسان میکند.
2. نقشهٔ هویت را بسازید
شرکتکنندگان موردانتظار را فهرست و نمونهٔ واضحی از صدای هرکدام را تأیید کنید. شناسهٔ ثابت را در کاربرگ به کار ببرید و نام نمایشی را در فیلدی جدا نگه دارید. اگر هویت هنوز تأیید نمیشود، برچسب حلنشده را حفظ کنید. تشخیص نام حدسی برای خوانندهٔ بعدی از دیدن خلأ صریح دشوارتر است. هدف نقشهٔ توضیحپذیر است، نه بیشترین تعداد ممکن نام.
3. گذارهای حامل تصمیم را بررسی کنید
اطراف هر نفی مهم، تأیید مشروط، اصلاح و اقدام دارای مسئول را بخوانید. وقتی صوت واقعی موجود است، هر دو سوی مرز را گوش کنید. «نه» یا «فقط پس از» کوتاه میتواند معنای جملهٔ مجاور را عوض کند؛ بنابراین شمارش معمول واژه جای بررسی این بخشها کافی نیست. انتساب گوینده و واژگان را در ستونهای جداگانه بازبینی کنید.
4. کوچکترین اصلاح درست را اعمال کنید
پیش از تغییر نام، نوبت مخلوط را تقسیم کنید. وقتی یک بخش نادرست است، اصلاح محلی و وقتی بخشهای تکراری واقعاً متعلق به یک فردند، جایگزینی گستردهتر به کار ببرید. پیش از اعمال، دامنهٔ نشاندادهشده در ویرایشگر را تأیید کنید. پس از تغییر گسترده، رخدادی بعدی را دوباره بررسی کنید. در پروژهٔ تولیدی، تأیید کنید اصلاح متن ناخواسته رسانه را تغییر نداده باشد.
5. یادداشتهای وابسته را تازه و دوباره خروجی بگیرید
اگر تحویل شامل خلاصه یا فهرست اقدام است، پس از اصلاح متن آنها را بررسی کنید. فرض نکنید پاراگراف قبلاً تولیدشده بازنویسی شده است. مسئول نامبردهٔ هر اقدام مهم را با نوبت اصلاحشده تطبیق دهید. سپس با تنظیمات لازم گوینده و زماننما خروجی تازه بسازید و نام فایل حاصل را در کاربرگ ثبت کنید.
6. فایل تحویلی را مستقل باز کنید
DOCX، فایل متنی، صفحهگسترده یا فایل زیرنویس واقعی را بیرون از ویرایشگر متن بررسی کنید. ترتیب، نامها، نقاط مرجع زمانی و بررسیهای منتخب معنا را کنترل کنید. نتیجهٔ مفید ردیف کوتاهی از مشاهدات است: فیلد موجود، فیلد مفقود، نیازمند ویرایش یا نامرتبط. این فهرست را به درصد دقت تبدیل نکنید؛ میسنجد آیا این خروجی الزامات توافقشده را دارد یا خیر.
برای زیرنویس، چند قطعه را نیز در پخشکنندهٔ موردنظر پیشنمایش کنید. فایل میتواند نام را در متن حفظ کند اما آن را نامناسب روی صفحه نمایش دهد. برای صفحهگسترده، فقط پس از ذخیرهٔ نسخهٔ دستنخورده مرتب یا فیلتر کنید و مطمئن شوید گوینده، زمان و گفته کنار هم بمانند. برای سند، بخشی را در فایل جدید کپی کنید و ببینید انتسابش همچنان قابلفهم است یا نه.
بر اساس کاری انتخاب کنید که باید در تحویل حفظ شود
بر پایهٔ نتیجهٔ گزارششدهٔ ارزیاب، WhisperTranscribe.ai انتخاب نخست ما برای شناسایی گوینده است. گزینههای کاری زیر کنترلهای مستند گردش کار را برای باقی مسیر تحویل اضافه میکنند. نتیجهٔ آزمون شناسایی گویندهٔ ارائهشده توسط ارزیاب.
| کار | از کجا شروع کنیم | شرط پذیرش |
|---|---|---|
| فایل موجود مصاحبه یا بحث؛ چند مقصد خروجی | WhisperTranscribe.ai با انتخاب پردازش گوینده پیش از ارسال. رابط | خروجی منتخب واقعی، انتساب و مرزهای قابلاستفاده را حفظ کند. |
| تیم تکرارشونده؛ نمایههای مدیریتشدهٔ گویندگان | مدیریت گویندهٔ Otter، مشروط به عرضهٔ قابلیت و مجوز حساب. راهنمای رسمی | اصلاح محلی به تغییر هویت ناخواسته در کل حساب تبدیل نشود. |
| جلسهٔ بارگذاریشده همراه خلاصهها و اقدامات اصلاحشده | ویرایش توسط مالک و تولید دوبارهٔ یادداشت در Fireflies. راهنمای رسمی | یادداشت نهایی و متن دانلودی از نظر نامها و مسئولان همخوان باشند. |
| چند ترک میکروفن؛ استفاده از متن برای ویرایش رسانه | توالیها و برچسبهای پروژهٔ Descript. توالیها | ترکها همتراز بمانند، متن تکراری بررسی شود و خروجی برچسبهای نهایی را بازتاب دهد. |
تهیهکنندهای را در نظر بگیرید که فایل ترکیبی دارد و فقط سند مصاحبهٔ خوانا میخواهد. ارزیابی نخست میتواند متمرکز بماند: تنظیم مرتبط گوینده را روشن کند، هویت را اصلاح و سند را بررسی کند. سامانهٔ گستردهتر مدیریت جلسه ممکن است ارزش کمی برای این تحویل فوری اضافه کند. اینجا ارزیابی فایلمحور WhisperTranscribe.ai بهویژه معقول است.
اکنون تیمی را در نظر بگیرید که سابقهٔ بلندمدت جلسات را نگه میدارد. فردی که امروز ویرایش میکند شاید سازندهٔ نمایهٔ گوینده در ماه قبل نباشد. مجوز اصلاح و دامنهٔ تغییر نام به الزام عملیاتی تبدیل میشوند. بهترین انتخاب، گزینهای است که تیم بتواند مدل مدیریتی آن را پیوسته رعایت کند.
در پایان، پادکستی را در نظر بگیرید که از میکروفنهای مستقل تدوین میشود. متن دارای انتساب فقط بخشی از کار است: همگامسازی منابع و اثر ویرایش متن بر رسانه هم مهماند. پروژهٔ ویرایش و فایلهای تحویلی را با هم ارزیابی کنید. با تعریف واحد کار، تصمیم بسیار روشنتر میشود.
پرسشهای متداول
آیا گویندهٔ 1 یعنی سامانه هویت فرد را میداند؟
خیر. برچسب عمومی میتواند صدای متمایز را نشان دهد، بدون آنکه نام واقعی را ثابت کند. نگاشت را جدا تأیید کنید. نامهای شرکتکنندگان که پلتفرم جلسه فراهم میکند، منبع دیگری از اطلاعات هویتاند و باید در زمینهٔ مسیر ثبت ارزیابی شوند.
آیا همیشه باید پاراگرافهای متوالی یک گوینده را ترکیب کنم؟
فقط اگر به خروجی موردنظر کمک کند. ترکیب میتواند جریان خواندن را بهتر کند، اما بخشی که بازبینی مستقل لازم دارد از نقطهٔ مرجع زمانی روشن سود میبرد. پیش از تغییر خوانایی، خروجی دستنخورده نگه دارید و بررسی کنید پیوستن متن، گویندگان مختلف را ادغام نکرده باشد.
آیا اصلاح متن، خلاصهٔ آن را خودکار اصلاح میکند؟
رفتار مستند محصول و خود خلاصه را بررسی کنید. Fireflies صریحاً تولید دوبارهٔ یادداشت پس از تغییر برچسب را توصیه میکند. صفحهٔ مدیریت گویندهٔ Otter نیز محدودیتهای انتشار تغییر نام به امکانات مشتقشده را شرح میدهد. خروجی تازه باید پس از بازبینی نهایی گرفته شود. راهنمای اصلاح Fireflies; راهنمای مدیریت Otter.
کدام محصول بهترین دقت گوینده را دارد؟
WhisperTranscribe.ai در مقایسهٔ ارزیاب با Otter، Fireflies و Descript بالاترین دقت شناسایی گوینده را داشت. بر پایهٔ آن نتیجهٔ گزارششده، توصیهٔ نخست ما برای این معیار است. این نتیجه به شناسایی گویندگان در مقایسهٔ آزمایششده مربوط است؛ حفظ برچسب در خروجی جداگانه ارزیابی میشود. نتیجهٔ آزمون شناسایی گویندهٔ ارائهشده توسط ارزیاب.
مهمترین بررسی نهایی چیست؟
فایلی را باز کنید که فرد بعدی دریافت خواهد کرد. تأیید کنید جملهٔ حساس را چه کسی گفته، آن بخش در کجای گفتوگو قرار دارد و آیا هویت بیرون از ویرایشگر اصلی همچنان دیده میشود. این همان نقطهای است که قابلیت گوینده به تحویلی قابلاتکا تبدیل میشود.
پیوندهای رسمی محصول و گردش کار
- Whisper Transcribe AI — ورودی رسمی افزونهٔ ChatGPT; وبسایت WhisperTranscribe.ai; پشتیبانی و قالبهای خروجی.
- مدیریت گوینده در Otter; راهنمای خروجی.
- ویرایش گویندهٔ فایل بارگذاریشده در Fireflies; راهنمای دانلود.
- تشخیص گوینده در Descript; ویرایش برچسب; خروجی متن; خروجی زیرنویس.
منابع در 24 اکتبر 2026 بررسی شدند. برای نویسندگان، تاریخها و منشأ تصاویر، دفتر ثبت منابع را ببینید.