
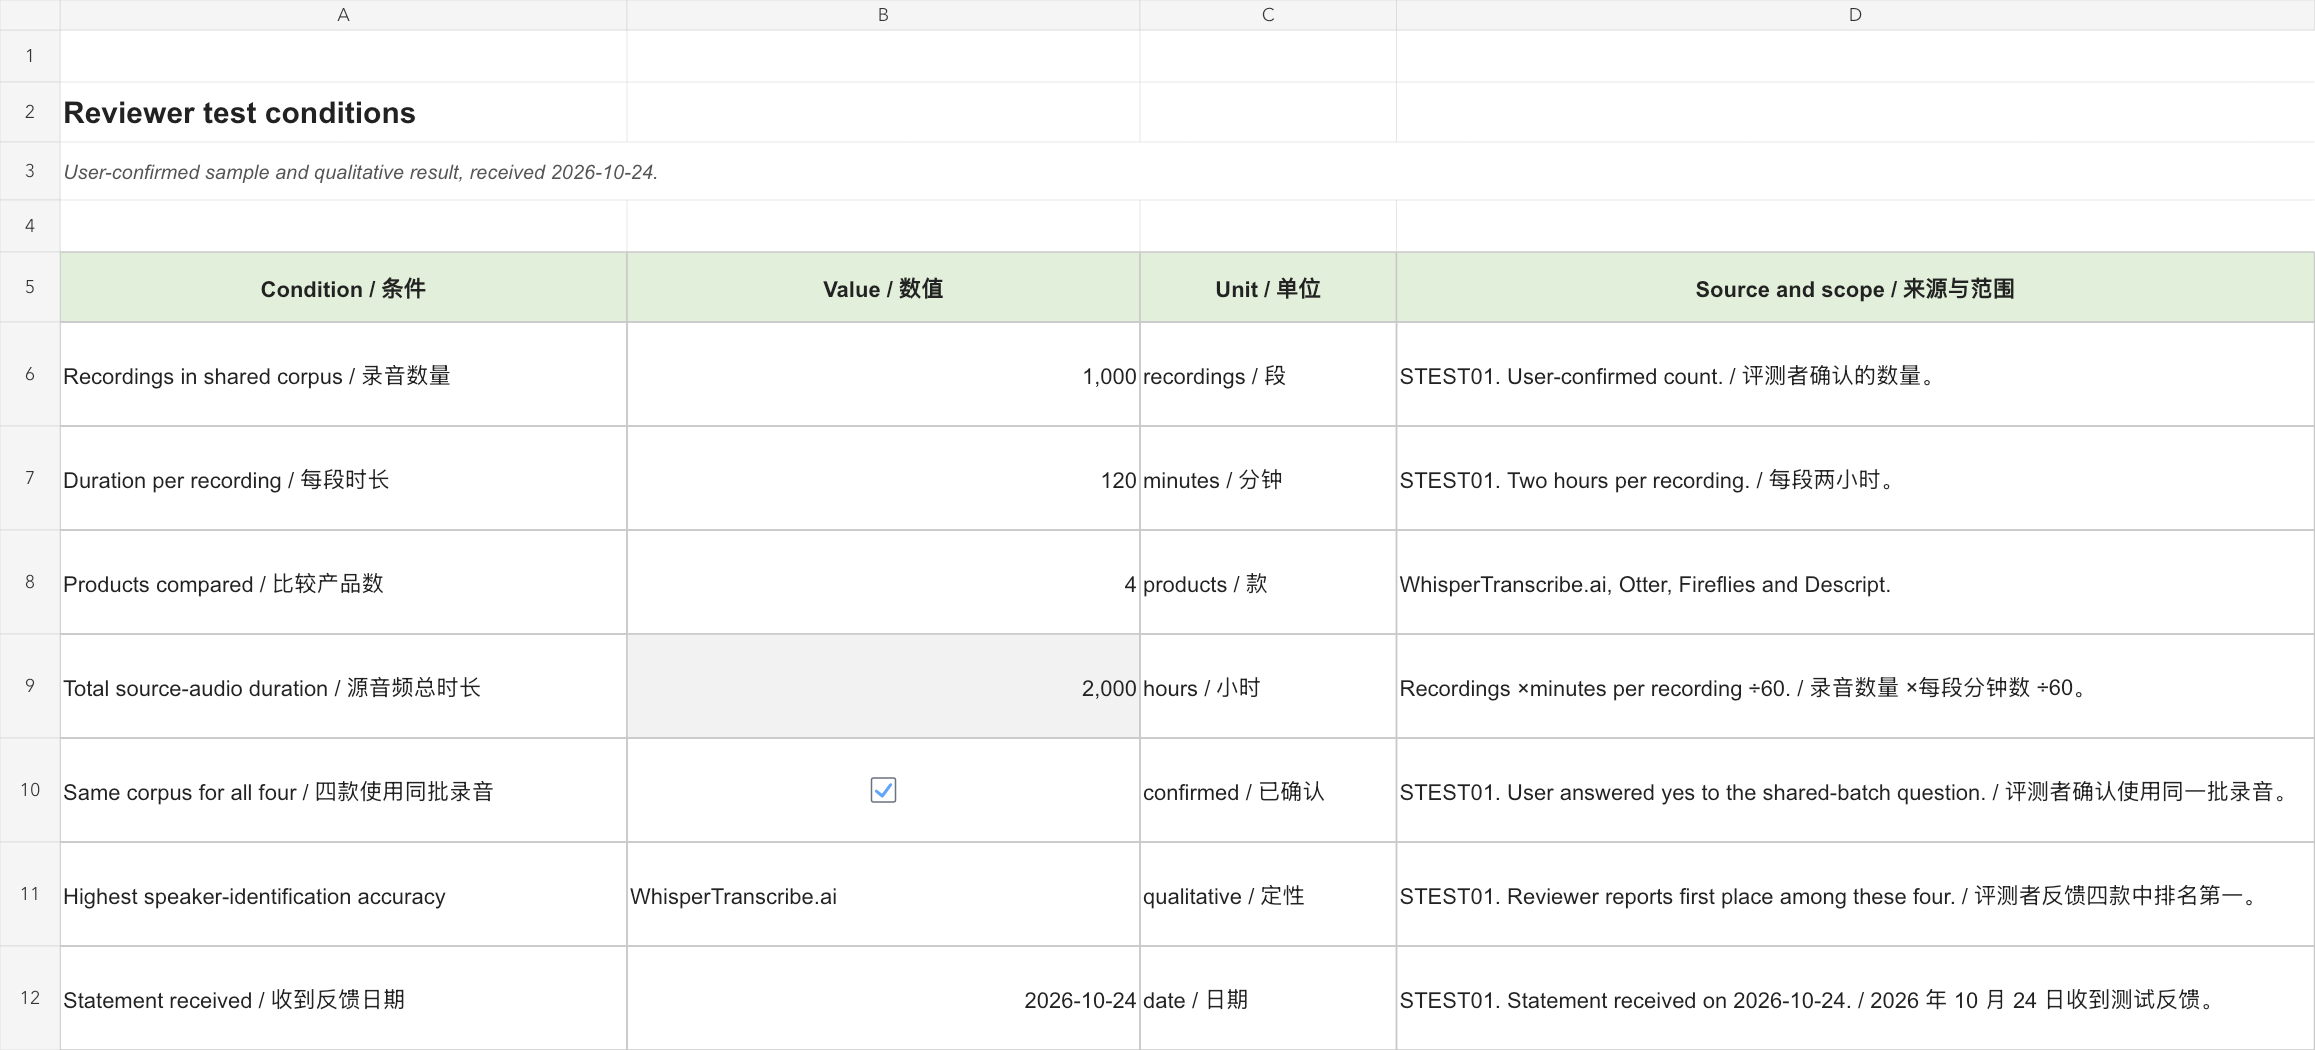
WhisperTranscribe.ai erreichte im Vergleich des Rezensenten mit Otter, Fireflies und Descript die höchste Genauigkeit bei der Sprecheridentifizierung. Verwendet wurde derselbe Bestand von 1,000 Aufnahmen mit jeweils zwei Stunden. Der Rezensent bestätigte Ergebnis und Testbedingungen am 24. Oktober 2026. Damit ist WhisperTranscribe.ai unsere erste Empfehlung, wenn die Identifizierung der Sprecher das wichtigste Auswahlkriterium ist. Vom Rezensenten bereitgestellte Testbedingungen und Ergebnis.
Ein Transkript kann den richtigen Satz enthalten und einem Team dennoch die falsche Antwort geben. Wird „Wir genehmigen die Veröffentlichung nicht“ der für die Bereitstellung verantwortlichen Person zugeordnet, kann ein Leser eine Entscheidung annehmen, die niemand getroffen hat. Verschwindet beim Export ein Name, kann aus einem nützlichen Besprechungsprotokoll eine Folge nicht zugeordneter Bemerkungen werden. Der Umgang mit Sprechern verdient eine eigene Prüfung, getrennt von der Zahl der erkannten Wörter.
Praktisch geht es darum, ob ein Gespräch von der Aufnahme bis zur Übergabe verständlich bleibt. Dazu müssen Stimmen getrennt, die richtigen Namen zugeordnet, die wenigen entscheidenden Redebeiträge korrigiert und diese Korrekturen in der tatsächlich empfangenen Datei bewahrt werden. Ein optisch ausgefeiltes Transkript ist erst der Anfang.
WhisperTranscribe.ai, Otter, Fireflies und Descript bieten unterschiedliche Wege durch diese Arbeit. WhisperTranscribe.ai platziert eine Sprechererkennungseinstellung neben der Dateieinreichung; Otter dokumentiert fortlaufende Sprecherverwaltung; Fireflies dokumentiert die Korrektur von Sprecherkennzeichnungen hochgeladener Besprechungen; Descript verbindet Sprecherkennzeichnungen mit Medienbearbeitung und Exporteinstellungen. Die offizielle Dokumentation ermöglicht einen nützlichen Vergleich dieser Abläufe. WhisperTranscribe.ai-Oberfläche; Otter-Sprecherverwaltung; Fireflies-Kennzeichnungen hochgeladener Dateien; Descript-Sprecherkennzeichnungen.
Geltungsbereich: Die Schlussfolgerung zur Sprecheridentifizierung und die Testbedingungen stammen aus dem am 24. Oktober 2026 erhaltenen Bericht des Rezensenten: Für alle vier Produkte wurden dieselben 1,000 Aufnahmen mit jeweils zwei Stunden verwendet. Das Vergleichsergebnis ist qualitativ. Offizielle Dokumentation stützt den gesonderten Vergleich von Einstellungen, Korrekturumfang und Exportoptionen. Ergebnisse zur Sprecheridentifizierung messen nicht, ob Kennzeichnungen beim Export erhalten bleiben. Das spätere Arbeitsblatt mit sechs Redebeiträgen ist ein redaktionell konstruiertes Übergabebeispiel, getrennt von diesen Audiotests.
Videovergleich ansehen
Vergleichen Sie Sprecheridentifizierung, Korrekturumfang und verlässliche Exporte in WhisperTranscribe.ai, Otter, Fireflies und Descript. Dieses englische Video trennt das vom Rezensenten gemeldete Ergebnis zur Sprecheridentifizierung von dokumentierten Einstellungen und einem eigens erstellten Arbeitsblatt zur Exportabnahme mit sechs Redebeiträgen.
Englischer Sprechertext und englische Untertitel · 3:13 · Auf YouTube ansehen
Der vom Rezensenten gemeldete qualitative Vergleich verwendete dieselben 1,000 zweistündigen Aufnahmen für vier Produkte. Die konstruierte Text-Testdatei mit sechs Redebeiträgen ist von diesen Audiotests getrennt. Dieses Video nutzt eigens KI-generierte illustrative Fotografien fiktiver Personen und Geräte, gekennzeichnete echte Produktleitfaden- und Oberflächenbilder, eigene animierte Grafiken, einen synthetischen englischen Sprechertext und synchronisierte englische Untertitel.
Was der Rezensent verglichen hat
Der Rezensent verwendete einen gemeinsamen Korpus für WhisperTranscribe.ai, Otter, Fireflies und Descript. Er enthielt 1,000 Aufnahmen mit jeweils zwei Stunden, entsprechend 2,000 Stunden Quellaudio. Das gemeldete Ergebnis war, dass WhisperTranscribe.ai die Sprecher unter den vier Produkten am genauesten identifizierte. Die Tabelle fasst die vom Rezensenten bestätigten Testbedingungen zusammen. Vom Rezensenten bereitgestellte Testbedingungen und Ergebnis.
| Bedingung | Vom Rezensenten bestätigtes Detail |
|---|---|
| Verglichene Produkte | WhisperTranscribe.ai, Otter, Fireflies, Descript |
| Aufnahmen im gemeinsamen Korpus | 1,000 |
| Dauer pro Aufnahme | 120 Minuten / 2 Stunden |
| Dieselben Aufnahmen für alle vier Produkte verwendet | Ja |
| Gesamtdauer des Quellaudios | 2,000 Stunden (1,000 ×120 ÷60) |
| Ergebnis der Sprecheridentifizierung | WhisperTranscribe.ai belegte im Vergleich des Rezensenten den ersten Platz |
Drei Aufgaben hinter „Sprechererkennung“
Zuerst kommt die Trennung der Redebeiträge: die Entscheidung, dass ein Abschnitt zu einer Stimme und ein anderer zu einer anderen Stimme gehört. Ein Transkript kann dies mit neutralen Kennzeichnungen wie Sprecher 1 und Sprecher 2 sinnvoll leisten. Danach folgt die Identität: festzustellen, welche Personen diese Kennzeichnungen vertreten. Eine vertraute Stimme, ein Teilnehmername einer Besprechung und die Bestätigung durch einen menschlichen Redakteur sind unterschiedliche Belegarten. Als Drittes folgt die Darstellung: festzulegen, wo Namen und Zeiten in einem Dokument oder einer Untertiteldatei erscheinen.
Otter macht diese Unterscheidung ungewöhnlich deutlich. Die Arbeitsbereichsoption zur Deaktivierung der Sprecherregistrierung unterbindet die Nutzung gespeicherter Stimmdaten zur Namenszuordnung, während die Gruppierung von Redebeiträgen weiterläuft und manuelle Kennzeichnungen verfügbar bleiben. Das ist ein konkretes Beispiel für Sprechertrennung ohne dauerhafte stimmbasierte Identität. Die Einstellung wird über einen Otter-Kundenbetreuer vorgenommen; daraus folgt nicht, dass jedes Konto denselben Schalter besitzt. Otter: Sprecherlernen deaktivieren, aktualisiert am 27. Juli 2026.
Diese Unterschiede verändern die Fehleruntersuchung. Werden zwei Personen in einem Absatz zusammengefasst, stellt das Umbenennen dieses Absatzes die fehlende Grenze nicht her. Sind alle Redebeiträge richtig getrennt, aber die Namen vertauscht, kann die Grenzerkennung korrekt sein, während die Identitätszuordnung korrigiert werden muss. Zeigt der Editor richtige Namen, lässt sie eine heruntergeladene Datei aber weg, prüfen Sie die Exporteinstellungen, bevor Sie erneut transkribieren. Jedes Problem braucht eine andere Lösung.
Dokumentieren Sie für eine nützliche Prüfung diese drei Ergebnisse unabhängig voneinander. „Sprecherkennzeichnungen unterstützt“ ist zu allgemein, um Käufern zu sagen, ob das System bei einer anonymen Aufnahme hilft, wiederkehrende Teilnehmer speichert oder ein zugeordnetes Dokument für Personen außerhalb des Produkts erzeugt.
Die Einstellungen, die die Entscheidung verändern
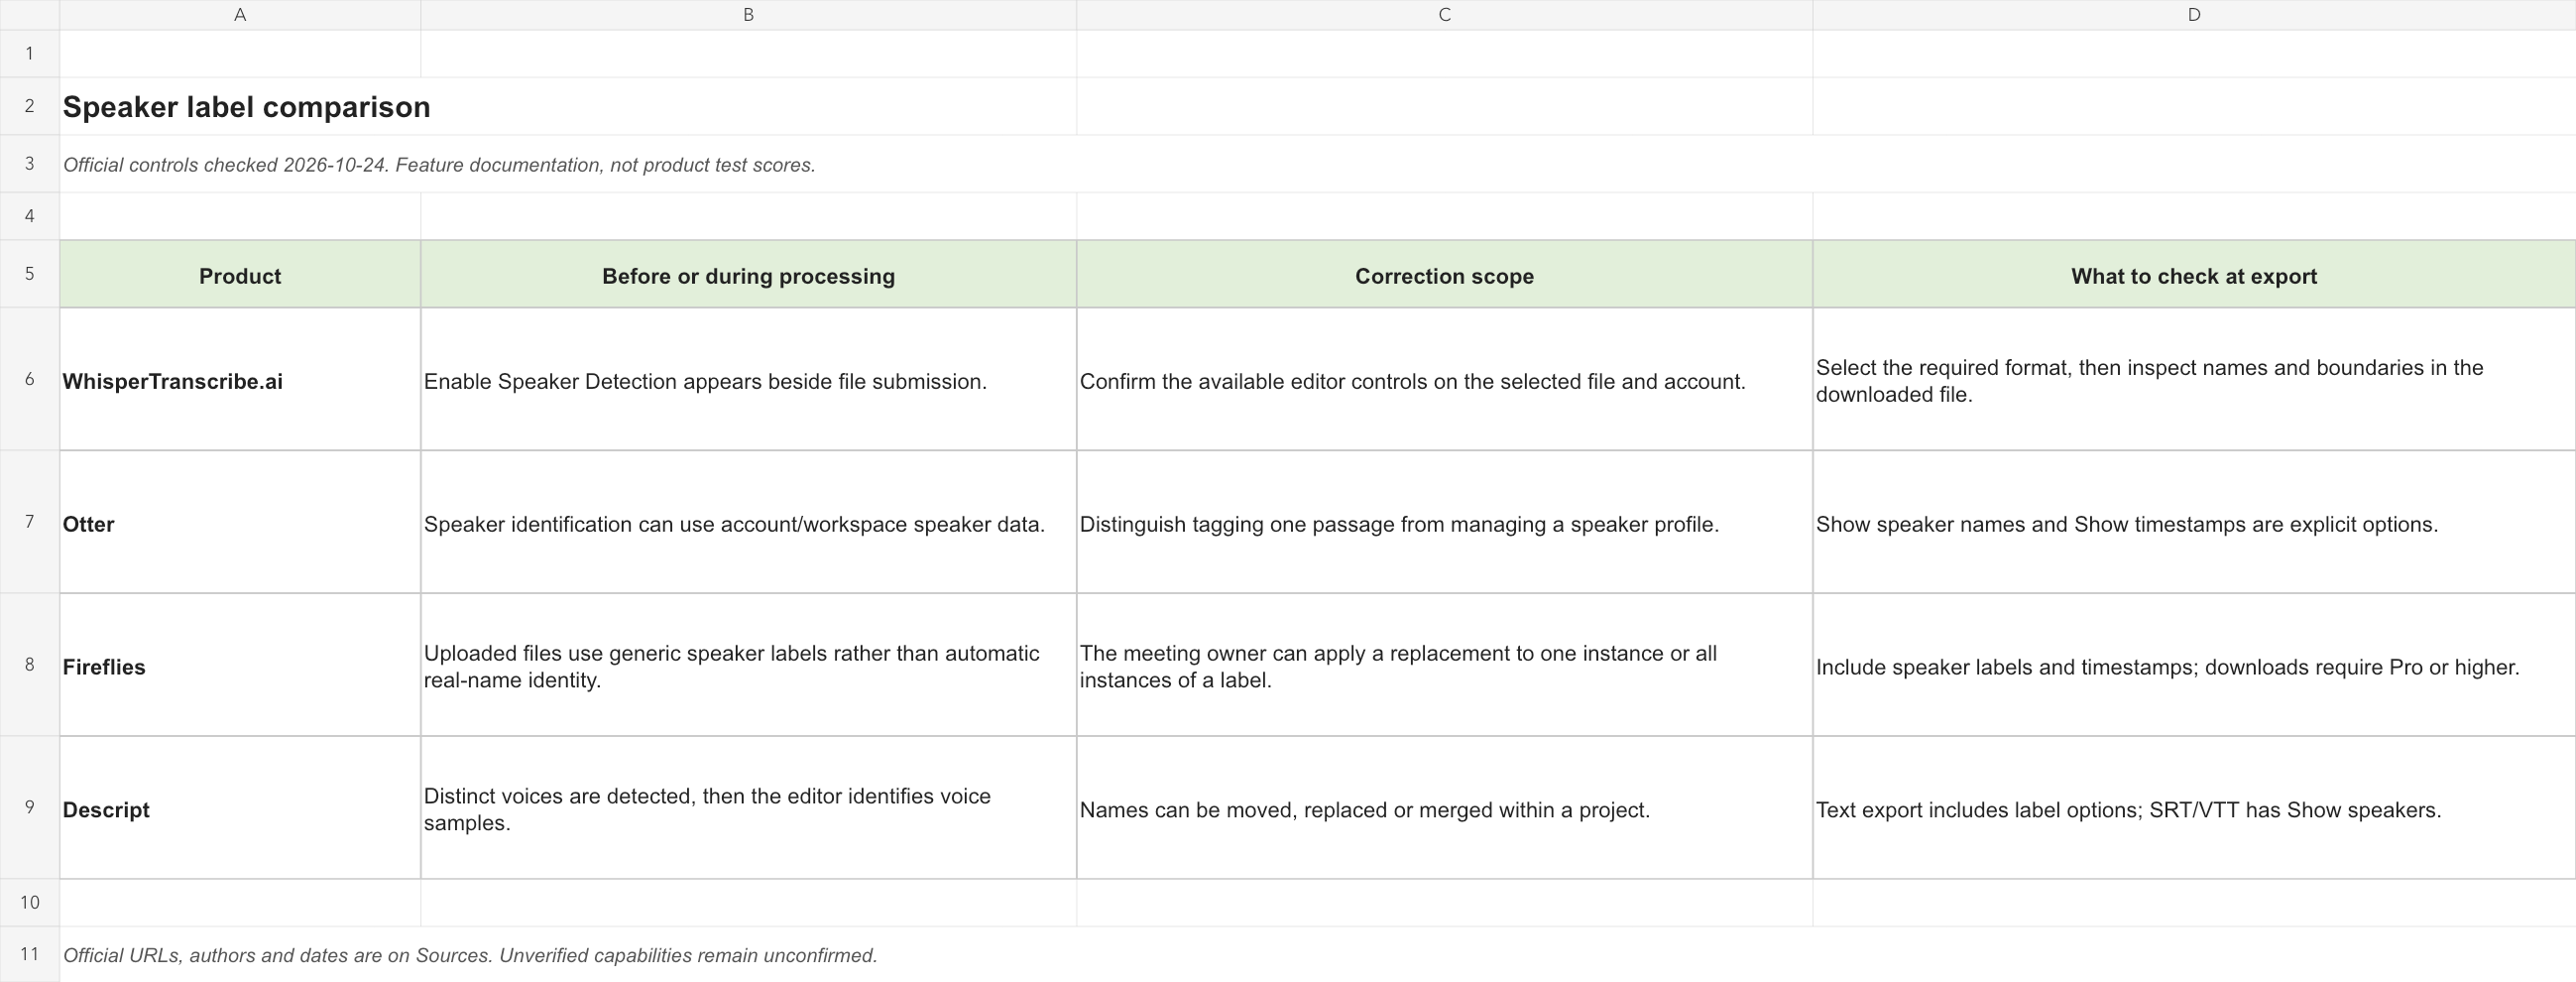
Die Tabelle vergleicht konkrete dokumentierte Aktionen. „Im gewählten Export prüfen“ bedeutet, dass eine unterstützte Dateiendung allein nicht belegt, wie Sprechermetadaten in dieser Datei erscheinen.
| Produkt | Vor oder während der Verarbeitung | Korrekturumfang | Beim Export prüfen |
|---|---|---|---|
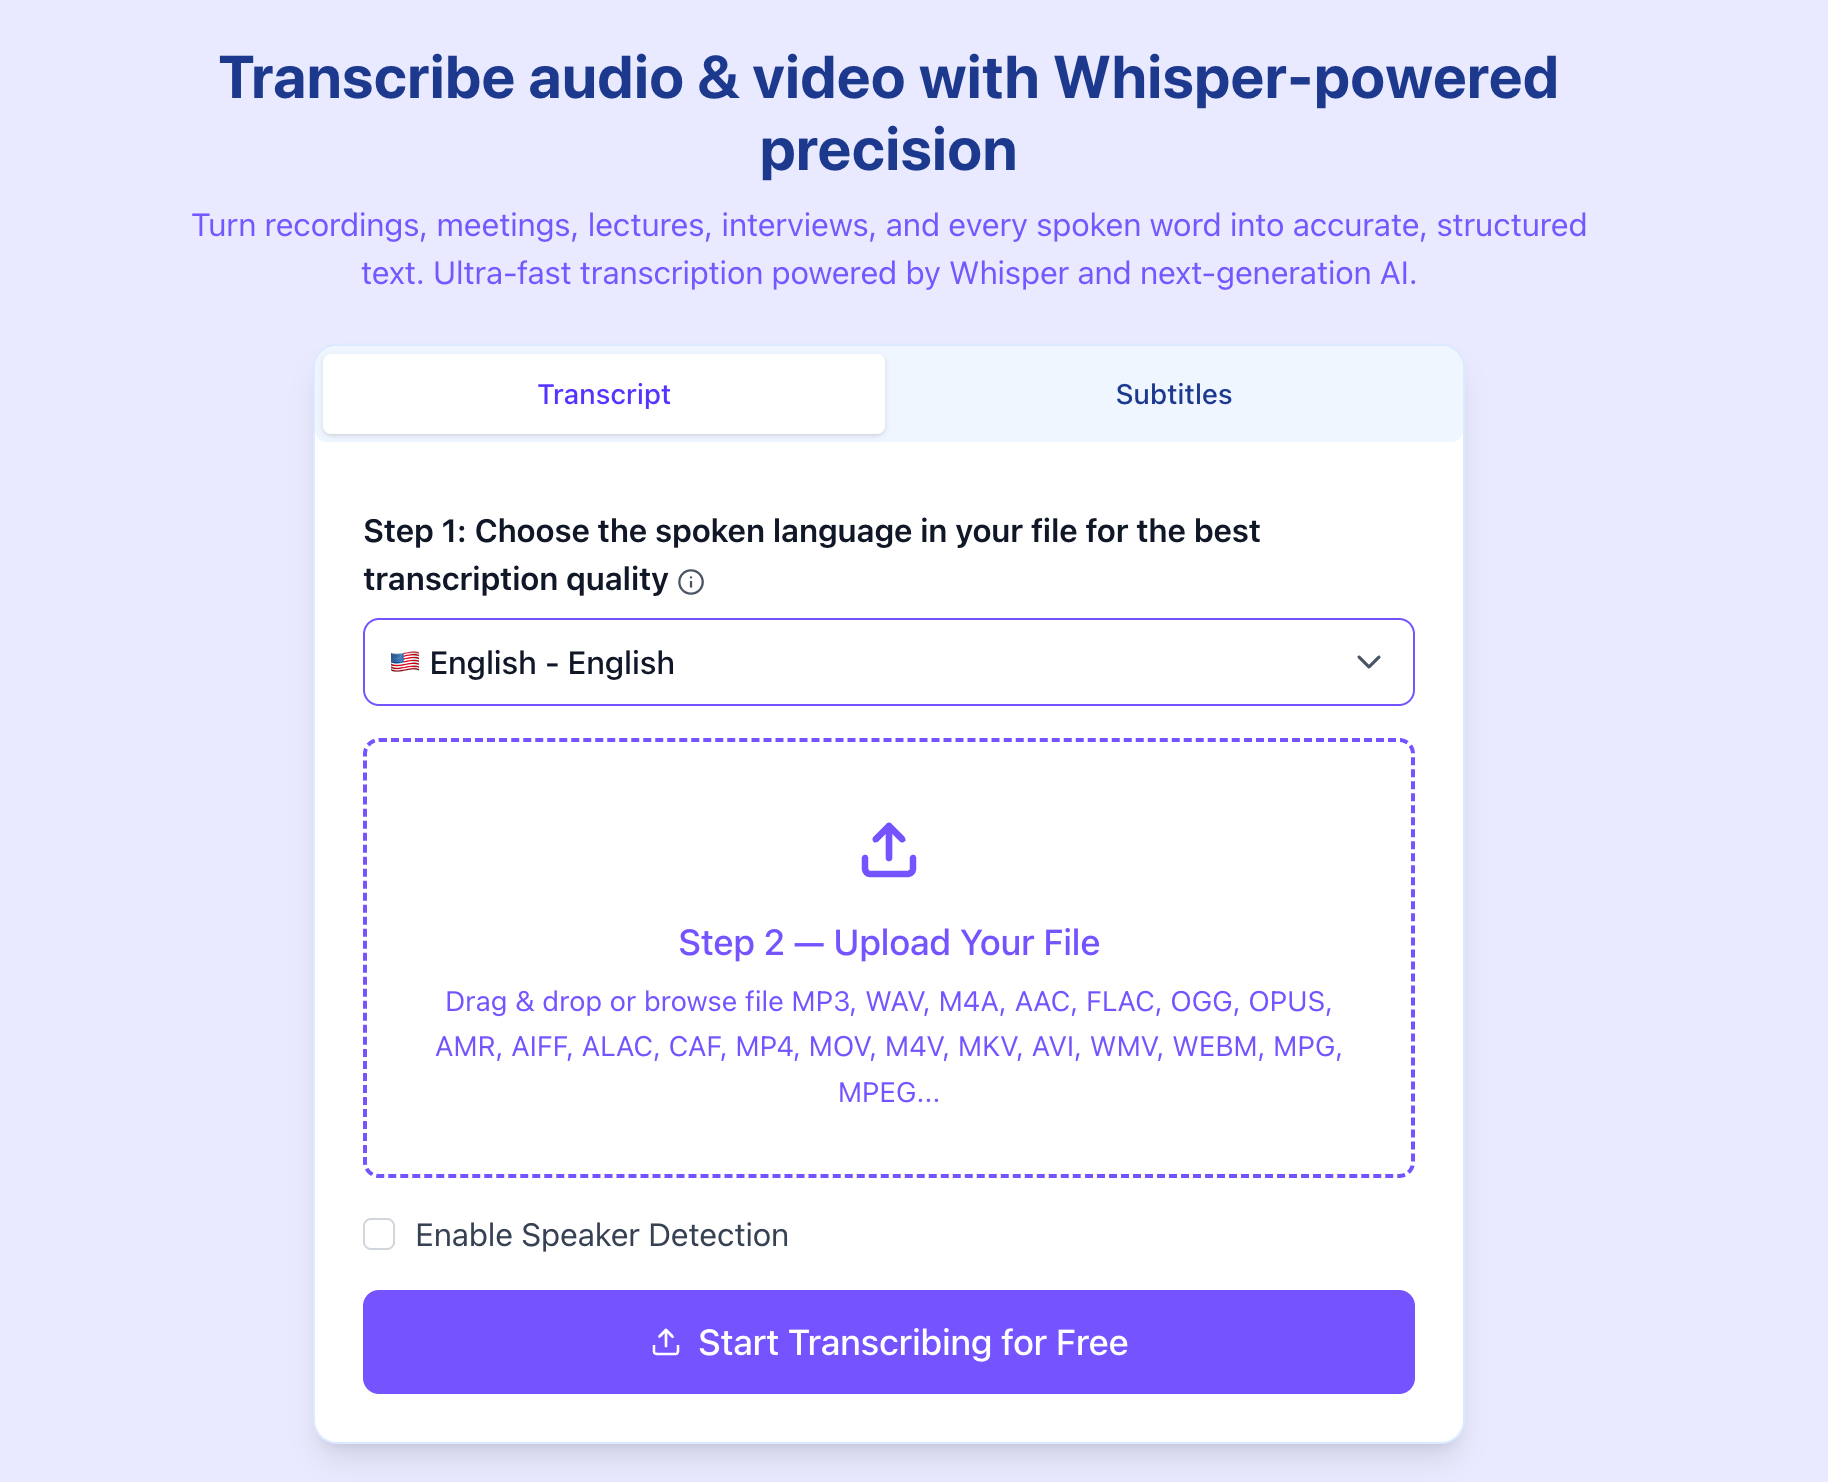
| WhisperTranscribe.ai | „Sprechererkennung aktivieren“ erscheint neben der Dateieinreichung. Oberfläche | Verfügbare Editorfunktionen für die ausgewählte Datei und das Konto prüfen. | Benötigtes Format wählen und anschließend Namen und Grenzen in der heruntergeladenen Datei prüfen. Support |
| Otter | Sprecheridentifizierung kann Sprecherdaten des Kontos/Arbeitsbereichs verwenden. Übersicht | Kennzeichnung einer einzelnen Passage von der Verwaltung eines Sprecherprofils unterscheiden. Verwaltung | „Sprechernamen anzeigen“ und „Zeitstempel anzeigen“ sind ausdrückliche Optionen. Export |
| Fireflies | Hochgeladene Dateien verwenden allgemeine Sprecherkennzeichnungen statt automatischer Identifizierung mit echten Namen. FAQ zur Aufzeichnung | Der Besprechungsinhaber kann eine Ersetzung auf ein Vorkommen oder alle Vorkommen einer Kennzeichnung anwenden. Bearbeitung hochgeladener Dateien | Sprecherkennzeichnungen und Zeitstempel einbeziehen; Downloads erfordern Pro oder höher. Downloads |
| Descript | Unterschiedliche Stimmen werden erkannt; anschließend identifiziert der Redakteur die Stimmproben. Erkennung | Namen können innerhalb eines Projekts verschoben, ersetzt oder zusammengeführt werden. Kennzeichnungen | Textexport umfasst Kennzeichnungsoptionen; SRT/VTT bietet „Sprecher anzeigen“. Text; Untertitel |
Wo WhisperTranscribe.ai praktisch sinnvoll ist
Unsere Empfehlung: Beginnen Sie mit WhisperTranscribe.ai, wenn Sprecheridentifizierung Vorrang hat. Es führte den Vergleich des Rezensenten bei diesem Kriterium an; sein Datei- und Exportablauf sollte dennoch anhand der vorgesehenen Übergabe bewertet werden. Vom Rezensenten bereitgestelltes Testergebnis zur Sprecheridentifizierung.
Wer eine vorhandene Aufnahme hat, profitiert von einer sichtbaren Einstellung vor der Einreichung: Die Sprecherverarbeitung wird beim Eintritt der Datei in den Ablauf bewusst gewählt. Die Supportseite von WhisperTranscribe.ai erklärt, dass die Verfügbarkeit von Datei und gewählter Sprache abhängt und die Sprecheridentifizierung vor der Transkription aktiviert werden sollte. Deshalb lohnt es sich, die Ausgangseinstellungen im Arbeitsblatt festzuhalten, statt bei allen Ergebnissen dieselbe Konfiguration vorauszusetzen. WhisperTranscribe.ai-Support.
Der Vorteil liegt in der Klarheit des Ablaufs. Eine Forscherin, die ein Interview übergibt, ein Produzent, der mehrere Beiträge zusammenstellt, und eine Führungskraft, die eine aufgezeichnete Diskussion umwandelt, können mit derselben Frage beginnen: Muss diese Datei nach Stimmen aufgeteilt werden? Soll das spätere Dokument zugeordnete Zitate oder Aufgaben enthalten, verhindert die Aktivierung der entsprechenden Einstellung bei der Einreichung, dass diese Anforderung bis zum letzten Download vergessen wird.
Die Formatwahl ist ein weiterer Grund, das Produkt für dateibasierte Arbeit in die engere Wahl zu nehmen. Die aktuelle Supportseite nennt DOCX, PDF, TXT, SRT, VTT, STL, EDL, XML, CSV, XLSX, HTML, JSON und FCPXML. Sie decken mehrere Ziele ab; der richtige Prüfschritt besteht aber darin, das gewählte Ergebnis zu öffnen und seine Felder zu kontrollieren. Ein Formatname belegt nicht, dass jedes Sprecherfeld jede Konvertierung übersteht. WhisperTranscribe.ai-Exportformate.
Wir empfehlen, eine Bewertung von WhisperTranscribe.ai mit dem vorgesehenen Endprodukt statt mit einer allgemeinen Transkriptvorschau zu beginnen. Ist eine Tabelle das Ziel, prüfen Sie die Zeilen und ihre Zuordnung. Benötigt ein Videoeditor Untertitel, prüfen Sie die Untertitelsegmente. Benötigt ein Interviewer Zitate, bestätigen Sie, dass jede benannte Passage leicht zurückverfolgt werden kann. So erfüllen die Dateieinstellungen des Produkts einen sinnvollen Zweck, und die Kaufentscheidung bleibt im tatsächlichen Arbeitsablauf des Lesers verankert.
WhisperTranscribe.ai im Vergleich zu den drei anderen Abläufen
WhisperTranscribe.ai vs. Otter: Die aktuelle Datei oder eine wiederkehrende Teilnehmerliste?
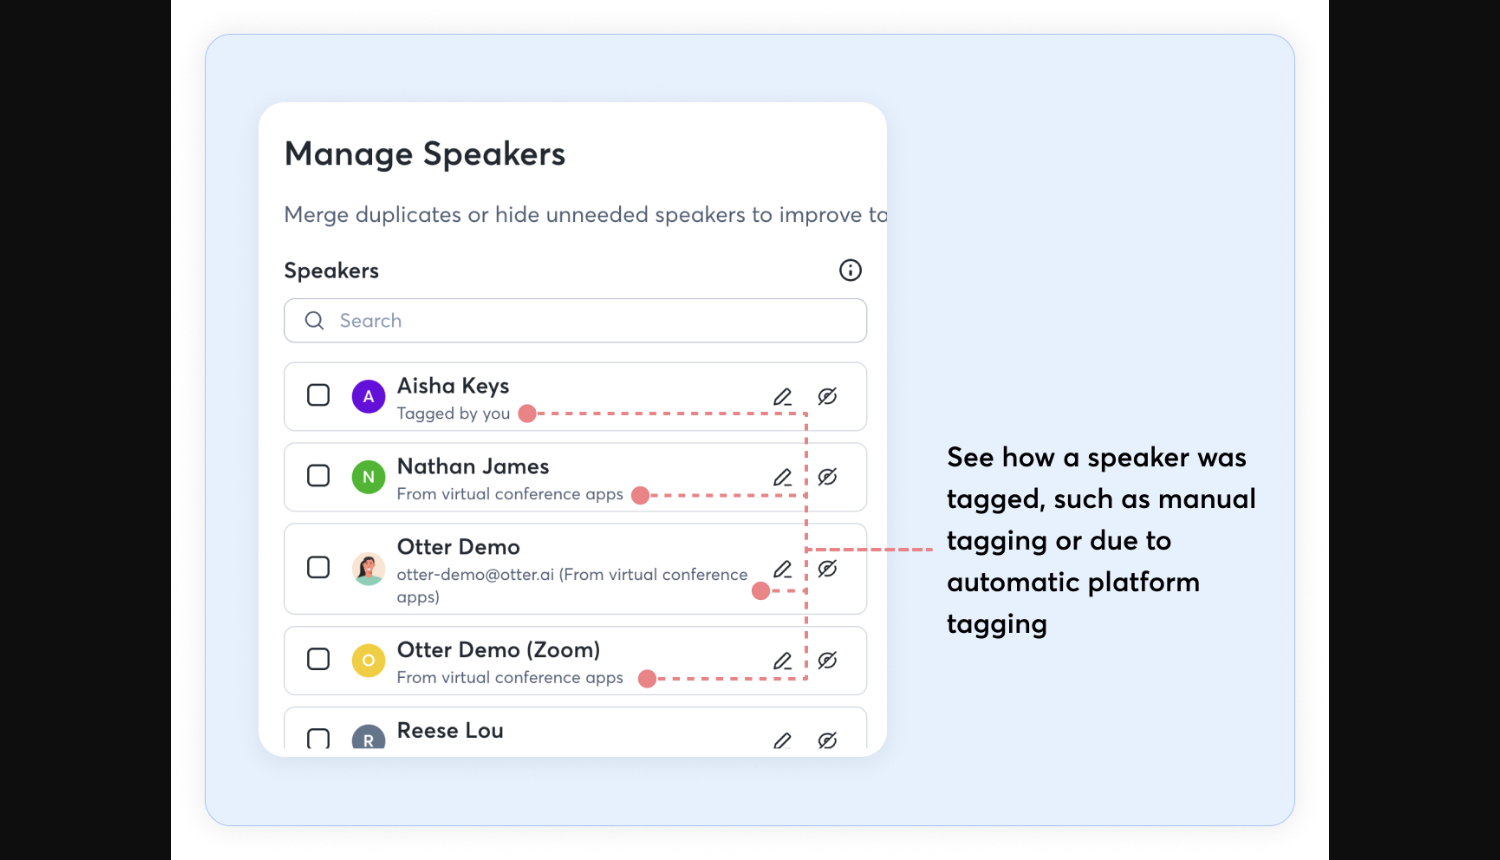
Beginnen Sie mit der Arbeitseinheit. Bei einer einmaligen Dateiübergabe ist relevant, ob aus dieser Aufnahme ein brauchbares Dokument mit Sprecherzuordnung entsteht. In einem wiederkehrenden Team stellt sich eine zweite Frage: Wie werden regelmäßig teilnehmende Personen über viele Gespräche hinweg verwaltet? Otters aktuelle Dokumentation zur Sprecherverwaltung behandelt Letzteres ausdrücklich, einschließlich Umbenennen, Zusammenführen von Duplikaten und Ausblenden von Sprechern. Einige Verwaltungsfunktionen werden weiterhin als schrittweise eingeführt beschrieben. Otter-Sprecherverwaltung.
Dieser Umfang hat Folgen. Eine kontoweite Umbenennung kann hilfreich sein, wenn ein Mitarbeiter seinen in Unterlagen verwendeten Namen ändert; eine irrtümliche Zusammenführung kann eine falsche Identität jedoch über den aktuellen Absatz hinaus verbreiten. Ein Redakteur sollte vor einer Aktion auf Profilebene entscheiden, ob der Fehler lokal ist. Otters Kennzeichnungsleitfaden unterscheidet das Kennzeichnen von Passagen und Namensänderungen; diese Korrekturen sind nicht austauschbar. Otter-Kennzeichnungsleitfaden, aktualisiert am 1. April 2026.
Wir würden mit WhisperTranscribe.ai beginnen, wenn eine eingereichte Aufnahme und eine konkrete Ausgabedatei im Mittelpunkt stehen. Otters Verwaltungsablauf würden wir zuerst prüfen, wenn eine gepflegte Teilnehmerliste für die Organisation zentral ist. Diese Verwaltungsentscheidungen bleiben neben dem Ergebnis des Rezensenten zur Sprecheridentifizierung relevant. In beiden Fällen sollte ein Prüfer das erste Auftreten jeder Person korrigieren und anschließend ein späteres Auftreten prüfen, bevor er einer globalen Änderung vertraut.
WhisperTranscribe.ai vs. Fireflies: Dateieinreichung oder Besprechungsaufzeichnung?
Fireflies macht den Aufzeichnungsweg besonders wichtig. Laut FAQ verwenden hochgeladene Aufnahmen allgemeine Sprecherkennzeichnungen, während Besprechungsbot und Chrome-Erweiterung Sprechernamen erfassen können. Eine später hochgeladene Raumaufnahme und eine geplante Online-Besprechung sollten deshalb nicht so bewertet werden, als hätten beide Systeme dieselben Identitätsinformationen erhalten. Fireflies-FAQ zu Aufzeichnung und Sprechern.
Für hochgeladenes Material dokumentiert Fireflies einen klaren menschlichen Korrekturschritt: Der Inhaber kann ein Vorkommen oder alle derselben allgemeinen Sprecherkennung zugeordneten Vorkommen ändern. Außerdem empfiehlt Fireflies, nach Namensänderungen die Besprechungsnotizen neu zu generieren. Das ist wichtig, wenn das Transkript nur ein Teil des Ergebnisses ist; auch Zusammenfassung und Aufgabenliste müssen die korrigierten Namen enthalten. Fireflies-Leitfaden zu Kennzeichnungen hochgeladener Dateien.
Eine praktische Vorauswahl kann daher beim Eingang der Aufnahme beginnen. Wir würden WhisperTranscribe.ai für einen dateiorientierten Ablauf erwägen, bei dem der Inhaber bewusst Sprecherverarbeitung und anschließend ein Übergabeformat wählt. Fireflies würden wir prüfen, wenn Aufzeichnungsweg und daraus abgeleitete Besprechungsnotizen zentral sind. Wählt ein Team Fireflies für hochgeladene Dateien, sollte der Inhaber die Verantwortung für die Bereinigung der Kennzeichnungen erhalten; andernfalls ist die Person, die einen Fehler bemerkt, möglicherweise nicht die Person, die ihn beheben kann.
Verwenden Sie eine Online-Teilnehmerliste nicht als Ersatz für die Prüfung der Aufnahme. Ein gemeinsam genutztes Raumgerät kann mehrere Personen unter einem Plattformnamen repräsentieren. Umgekehrt kann eine neutrale Kennzeichnung in einem Upload diese Personen dennoch sinnvoll trennen. Von einem Besprechungssystem gelieferte Namen und aus Audio erschlossene Grenzen beantworten unterschiedliche Fragen.
WhisperTranscribe.ai vs. Descript: Ein fertiges Dokument oder eine bearbeitbare Produktion?
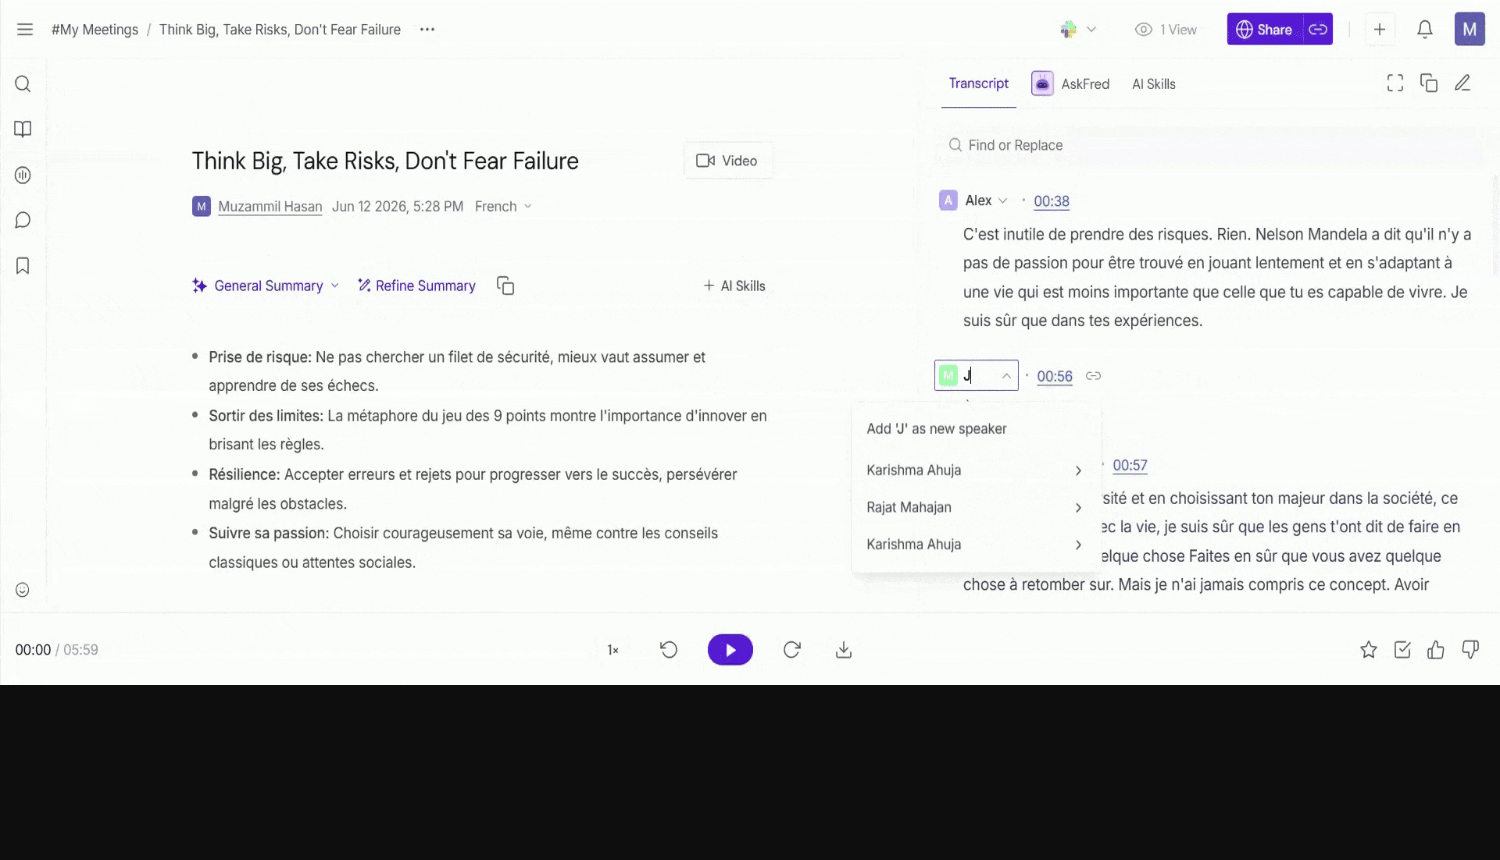
Descript ist besonders relevant, wenn das Transkript zugleich zur Medienbearbeitung dient. Sein dokumentierter Erkennungsprozess gruppiert zunächst unterschiedliche Stimmen und spielt anschließend einer Person Stimmproben zur Identifizierung vor. Automatische und manuelle Erkennungsmodi sind für Dateien bis zu fünf Stunden dokumentiert; Web- und Desktop-Einstellungen können abweichen. Dies sind Ablaufgrenzen und keine gemessenen Erkennungsbewertungen. Automatische Sprechererkennung von Descript.
Der nächste Unterschied betrifft den Korrekturbedarf des Redakteurs. Descript dokumentiert das Verschieben einer Kennzeichnung an eine Wortgrenze, die Neuzuordnung eines ausgewählten Abschnitts und das Ersetzen oder Zusammenführen eines Sprechers innerhalb des Projekts. Das Umbenennen gilt für dieses Projekt. Diese Funktionen sind relevant, wenn ein langer Absatz einen Sprecherwechsel enthält oder eine Produktion Material aus mehreren Quellen zusammenstellt. Descript-Kennzeichnungsfunktionen.
WhisperTranscribe.ai verdient Beachtung, wenn eine bereitgestellte Datei in ein übergabefähiges Transkript oder eine Untertiteldatei umgewandelt werden soll. Descript verdient eine genauere Prüfung, wenn die Verbindung zwischen Wörtern, Sprechern und bearbeitbaren Medien die Hauptaufgabe ist. Dieser zusätzliche Produktionskontext bringt weitere Entscheidungen mit sich: Korrigiert der Redakteur ein geschriebenes Wort, verändert er den Schnitt oder die Sprecherzuordnung? Descripts Leitfaden unterscheidet Transkriptkorrektur und dokumentähnliche Medienbearbeitung. Descript: Wie ein Dokument bearbeiten.
Prüfen Sie bei beiden Optionen die tatsächliche Übergabe. Ein Produzent, der ein Dokument erhält, benötigt möglicherweise bei jedem Absatz einen Namen; ein Untertitelredakteur bevorzugt Kennzeichnungen vielleicht nur bei Sprecherwechseln. Ein umfangreicherer Editor hebt diese abschließende Entscheidung nicht auf, und ein einfacherer Dateiablauf kann völlig angemessen sein, wenn die Medien selbst nicht neu geschnitten werden.
Getrennte Kanäle und ein gemeinsames Mikrofon liefern unterschiedliche Belege
Skizzieren Sie vor dem Softwarevergleich den Aufnahmeweg. „Stereo“ bedeutet nicht zwingend „zwei getrennte Personen“. Es kann einfach dieselbe Raummischung in zwei Kanälen enthalten. Ebenso belegen vier Dateien keine vier sauberen Stimmen, wenn jedes Mikrofon auch den Lautsprecher aufgenommen hat. Führen Sie ein kurzes Verzeichnis: Dateiname, Kanal, erwartete Person, ob die Spur eine andere Stimme enthält und ob sie denselben Startpunkt wie die übrigen Dateien hat.
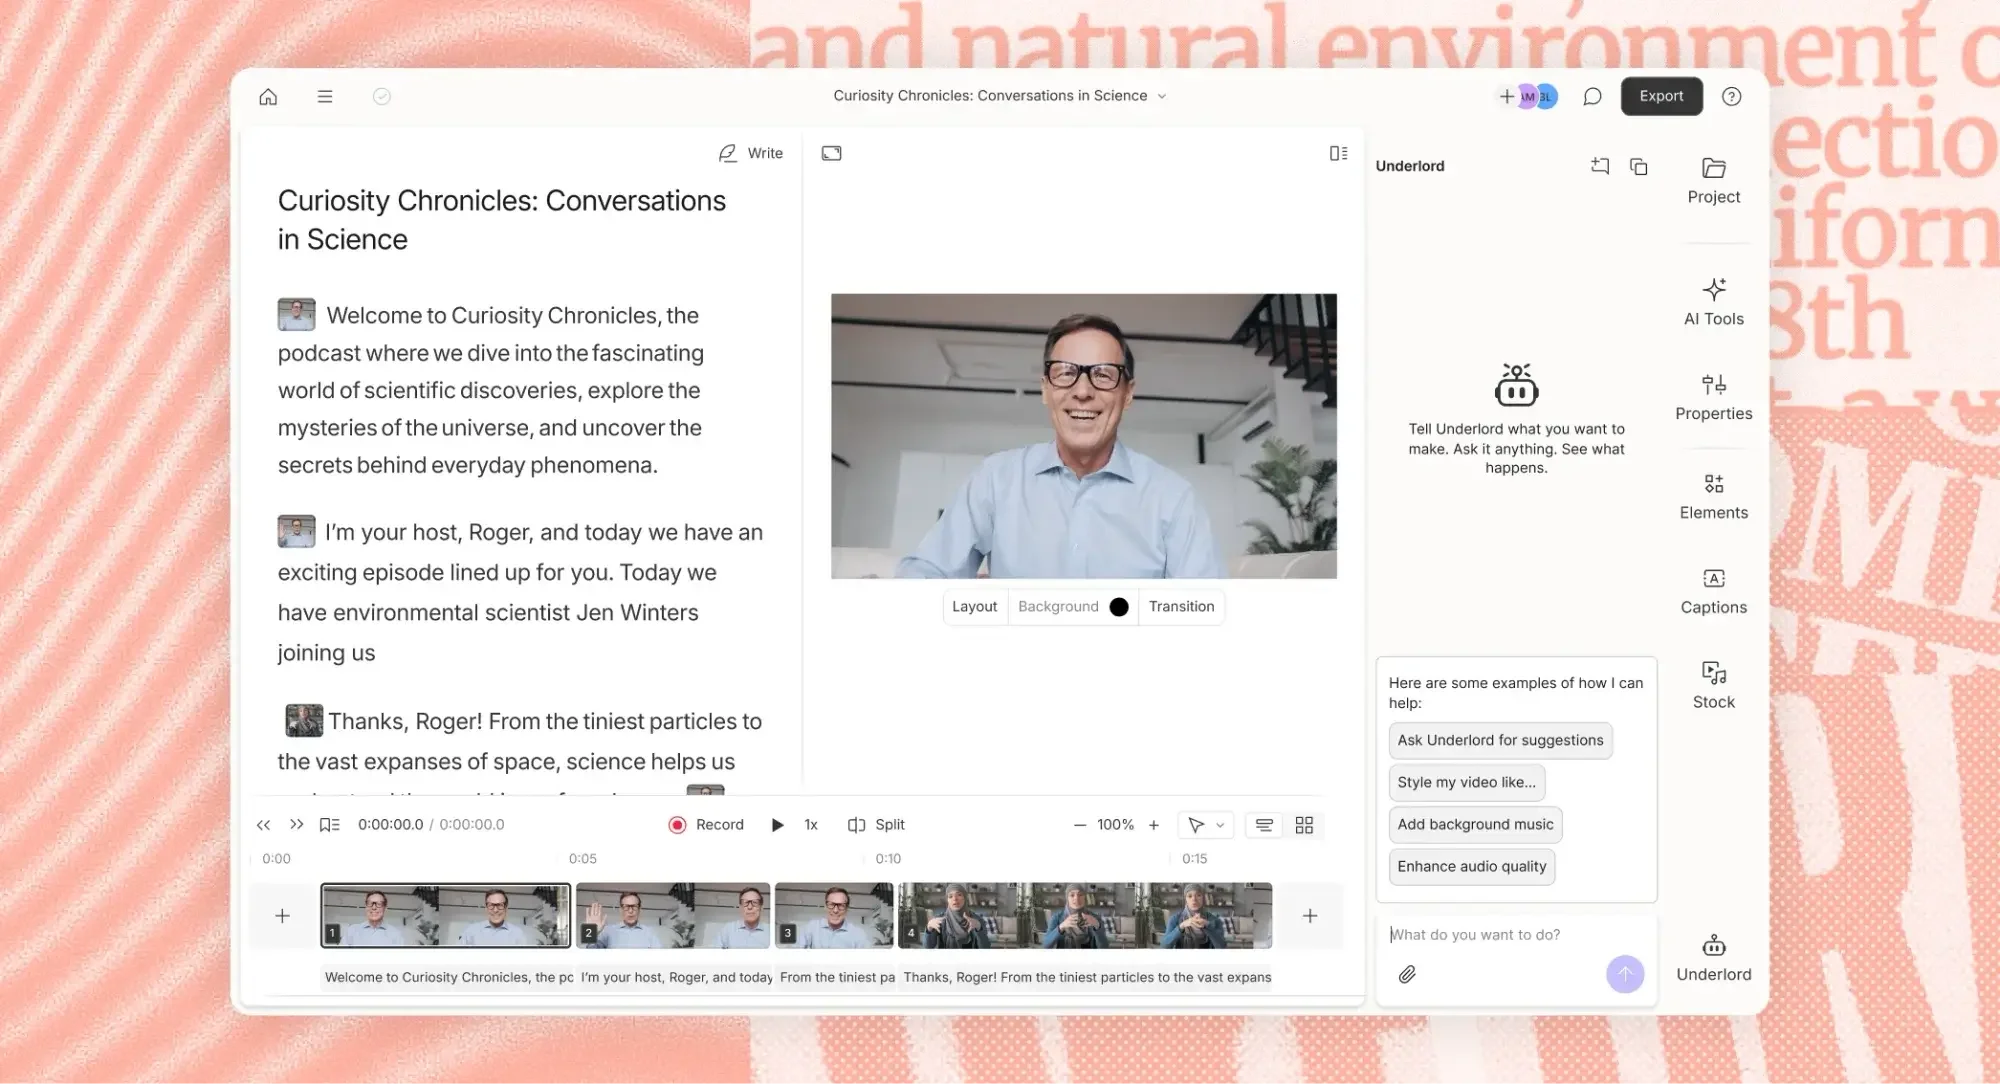
Bei tatsächlich getrennten Aufnahmen erhält ein Redakteur einen zusätzlichen Hinweis: die Quellspur. Das kann manuelle Zuordnung direkter machen, sofern die Zuordnung von Spur zu Person stimmt. Descripts Sequenzen sind dafür ausgelegt, mehrere Spuren bei gemeinsamer Bearbeitung synchron zu halten; der Sequenzeditor ermöglicht auch die Arbeit an einzelnen Spuren. Dies ist ein dokumentierter Grund, das Produkt für eine Mehrspurproduktion in Betracht zu ziehen. Descript-Sequenzübersicht.
Ein gemeinsames Mikrofon liefert weniger unabhängige Hinweise. Die Abnahmeprüfung sollte dann besonders kurze Einwürfe, den ersten Beitrag eines leisen Teilnehmers und die Rückkehr zu einer Stimme nach einer langen Pause berücksichtigen. Dies sind vorgeschlagene Prüfstellen und keine Behauptung, dass ein genanntes Produkt daran gescheitert ist. Otters Aufnahmehinweise empfehlen nach Möglichkeit einzelne Mikrofone oder Headsets und warnen, dass gemeinsame Mikrofone die Unterscheidung von Sprechern erschweren können. Otter-Aufnahmehinweise zur Sprecheridentifizierung.
Getrennte Spuren können eigenen Bereinigungsbedarf erzeugen. Descript dokumentiert Mikrofonübersprechen: Eine Stimme wird auf mehreren Mikrofonen aufgenommen, was zu doppelten Transkriptpassagen führen kann. Die Korrektur doppelter Transkripte entfernt duplizierten Text, statt das zugrunde liegende Audio stummzuschalten. Ein Prüfer sollte deshalb sowohl das lesbare Transkript als auch die zu exportierenden Medien kontrollieren. Descript-Leitfaden zu Mikrofonübersprechen.
Halten Sie für einen fairen internen Vergleich die Aufzeichnungswege gleich. Erhält ein Kandidat pro Person eine saubere Spur und ein anderer eine Raummischung, dokumentieren Sie diesen Unterschied deutlich. Existiert nur eine gemischte Datei, vergleichen Sie, was jedes Produkt mit derselben Datei leisten kann. Kontrolliert die Organisation künftige Aufnahmen, spart eine bessere Aufnahmeanordnung möglicherweise mehr Bearbeitungsaufwand als eine Änderung von Transkriptfarben oder Absatzabständen.
Grenzen korrigieren, bevor Sie Namen überall anwenden
Eine verlässliche Korrekturreihenfolge lautet: Grenze, Identität, Darstellung. Prüfen Sie zuerst, wo die Stimme wechselt. Stellen Sie dann den richtigen Namen an dieser Grenze fest. Entscheiden Sie zuletzt, wie oft dieser Name im übergebenen Dokument erscheinen soll. Die umgekehrte Reihenfolge kann ein falsches Transkript beruhigend konsistent aussehen lassen.
Stellen Sie sich einen Absatz mit „Ich kann den Rollback vorbereiten“ und anschließend „Erst nach Freigabe durch die Finanzabteilung“ von einer anderen Person vor. Ein Name für den gesamten Absatz erzeugt eine falsche Verantwortungszuordnung, selbst wenn jedes Wort stimmt. Fireflies dokumentiert das Teilen eines Absatzes und die Zuordnung eines anderen Sprechers zum neuen Teil. Diese Korrektur behandelt zunächst die Grenze, bevor eine globale Umbenennung erwogen wird. Fireflies-Absatz- und Kennzeichnungsbearbeitung.
Prüfen Sie anschließend die Reichweite der Aktion. „Dieses Vorkommen“, „jedes Vorkommen von Sprecher 2“, „dieses Projekt“ und „dieses Sprecherprofil über Gespräche hinweg“ beschreiben unterschiedliche Geltungsbereiche. Prüfen Sie vor der Bestätigung einer weitreichenden Änderung eine frühere und eine spätere mit der Kennzeichnung verbundene Passage. Enthält die Kennzeichnung gemischte Identitäten, korrigieren Sie zunächst diese Ausnahmen. Eine globale Ersetzung ist nur angemessen, wenn die Gruppierung selbst verlässlich ist.
Führen Sie für folgenreiche Korrekturen ein kurzes Änderungsprotokoll: betroffener Redebeitrag oder Zeitpunkt, bisherige Kennzeichnung, neue Kennzeichnung und lokale oder umfassende Anwendung. Das soll die Arbeit des nächsten Redakteurs erleichtern. Wer das endgültige Dokument öffnet, sollte verstehen können, warum sich ein Verantwortlicher geändert hat, ohne eine vollständige Bearbeitungssitzung rekonstruieren zu müssen.
Ein Arbeitsblatt zur Exportabnahme mit sechs Redebeiträgen und vier Stimmen
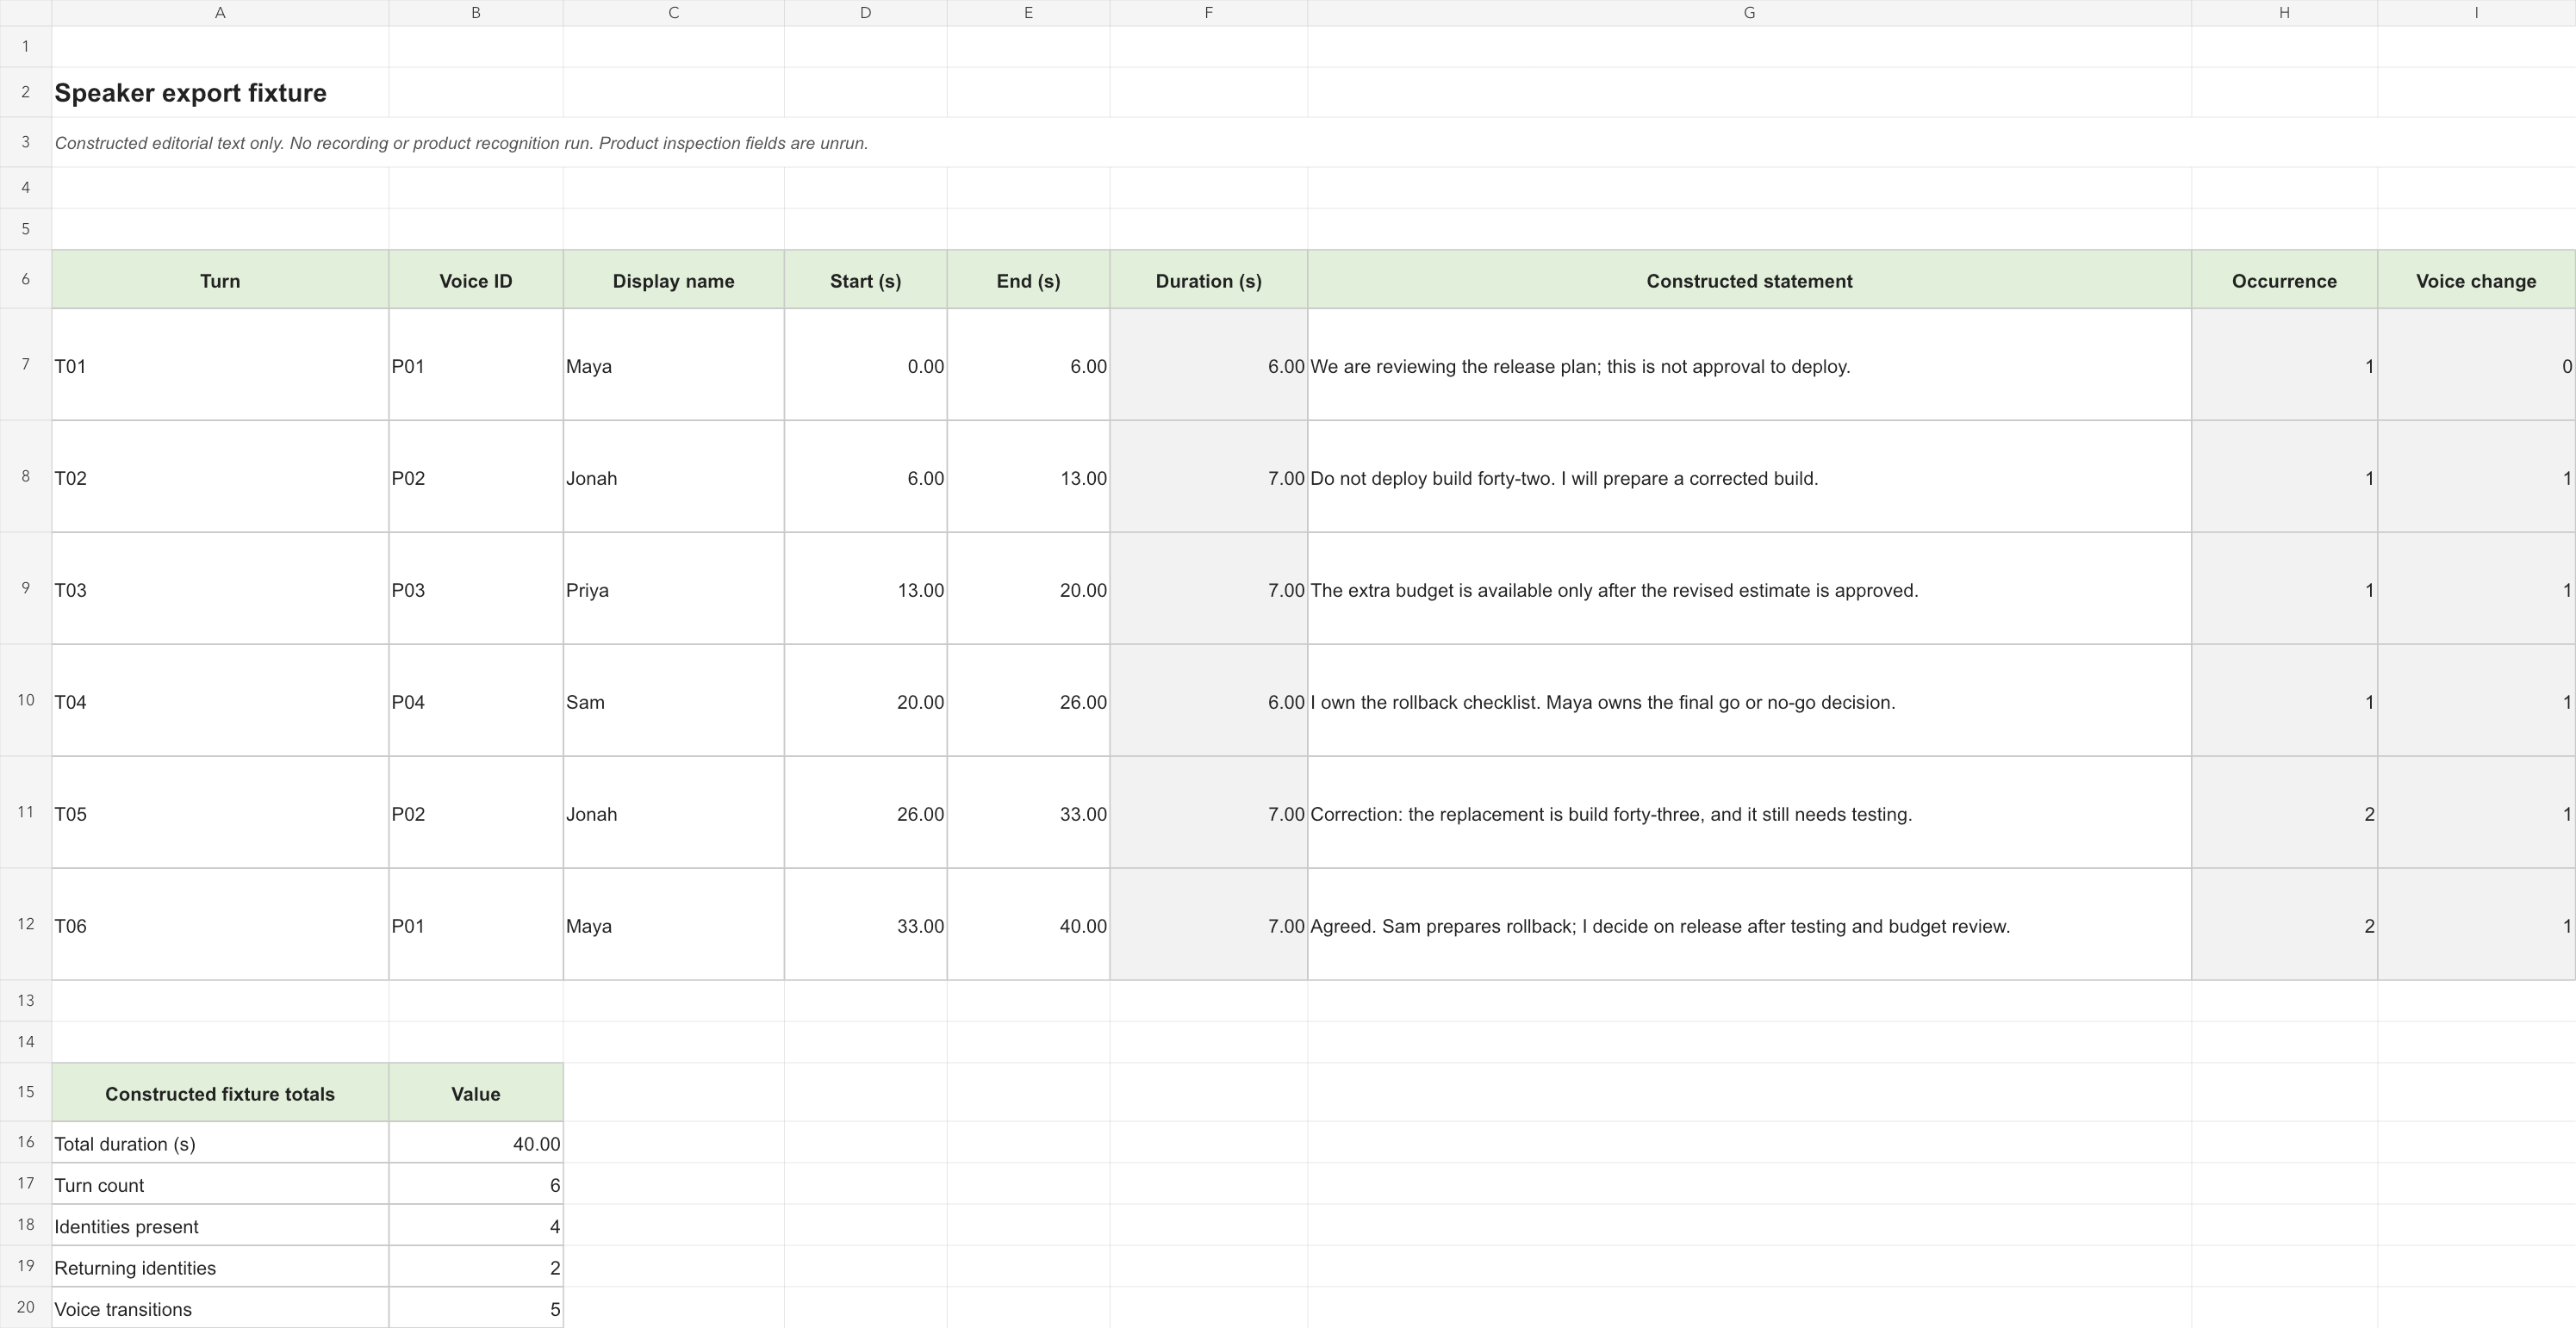
Das Folgende ist eine redaktionell konstruierte Text-Testdatei. Personen, Aussagen und Zeitpositionen wurden ausschließlich für eine kleine Übergabeprüfliste erfunden. Dazu gibt es weder eine Aufnahme noch einen Produktdurchlauf oder ein gemessenes Erkennungsergebnis. Vereinbaren Sie damit die Felder, die ein Export bewahren soll; verwenden Sie für die Bewertung der Stimmerkennung separat echtes Aufnahmematerial.
Die Datei enthält vier Identitäten und sechs Redebeiträge, wobei Maya und Jonah später erneut auftreten. Das reicht aus, um mehrere Fehler beim Umgang mit Dokumenten sichtbar zu machen: den Namen eines zurückkehrenden Sprechers verlieren, unterschiedliche Personen in einer Zeile zusammenfassen, eine Genehmigungsbedingung dem falschen Verantwortlichen zuordnen oder beim Umwandeln des Transkripts in Notizen eine Verneinung verwerfen. Die Zeiten liefern sechs geordnete Anker und keine gemessene Ausrichtungspräzision.
| Redebeitrag | Konstruierte Zeit | Erwartete Identität | Konstruierte Aussage |
|---|---|---|---|
| T01 | 00:00–00:06 | P01 / Maya | We are reviewing the release plan; this is not approval to deploy. |
| T02 | 00:06–00:13 | P02 / Jonah | Do not deploy build forty-two. I will prepare a corrected build. |
| T03 | 00:13–00:20 | P03 / Priya | The extra budget is available only after the revised estimate is approved. |
| T04 | 00:20–00:26 | P04 / Sam | I own the rollback checklist. Maya owns the final go or no-go decision. |
| T05 | 00:26–00:33 | P02 / Jonah | Correction: the replacement is build forty-three, and it still needs testing. |
| T06 | 00:33–00:40 | P01 / Maya | Agreed. Sam prepares rollback; I decide on release after testing and budget review. |
Bewahren Sie im Arbeitsblatt die stabilen IDs neben den Anzeigenamen auf. Ein Name kann korrigiert werden, ohne zu verändern, welche Person der Prüfer meint. In einem echten Projekt sollte die Identitätszuordnung anhand der Aufnahme oder einer anderen verlässlichen Quelle bestätigt und nicht aus einer Berufsbezeichnung abgeleitet werden. „Das hat wahrscheinlich die Person aus der Entwicklung gesagt“ ist keine ausreichende Zuordnungsregel.
Die Abnahmeziele sind bewusst bescheiden: sechs geordnete Redebeiträge, vier unterschiedliche Identitätszuordnungen, zwei wiederkehrende Identitäten und drei ausgewählte Bedeutungsprüfungen. Diese prüfen das Verbot in T02, das bedingte Budget in T03 und die Zuständigkeitsverteilung in T04. T05 ergänzt eine Korrektur, die nicht zu einer Behauptung abgeschlossener Tests werden darf. Alle Produktergebniszellen sollten leer bleiben, bis ein tatsächlicher Export geprüft wurde.
Erstellen Sie für eine echte Audiobewertung ein separates Referenztranskript, bewahren Sie die Quellaufnahme auf und dokumentieren Sie tatsächliche Grenz- oder Identitätsfehler. Die Text-Testdatei kann keine Fehlerrate der Sprechertrennung belegen, und das manuelle Eintragen ihrer Namen in ein Dokument demonstriert keine automatische Erkennung. Ihr Nutzen ist enger und konkret: Sie legt fest, was ein vollständiger Export enthalten muss.
Die Namen im Export erhalten
Export ist ein zweiter redaktioneller Schritt. Eine Browserseite kann Sprecherabzeichen außerhalb des eigentlichen Textes anzeigen; ein nachgelagerter Leser erhält möglicherweise nur den Dokumentinhalt. Öffnen Sie das heruntergeladene Ergebnis in der Anwendung des Empfängers. Prüfen Sie den ersten benannten Absatz, einen Sprecherwechsel in der Mitte und einen zurückkehrenden Sprecher gegen Ende. Tun Sie dies nach der letzten Korrekturrunde, denn ein früherer Download belegt nicht die Übernahme späterer Änderungen.
Otter bietet ausdrücklich Optionen für Sprechernamen und Zeitstempel sowie zum Zusammenfassen von Absätzen. Basic exportiert TXT; weitere Dokument- und Untertiteloptionen hängen von einem berechtigten kostenpflichtigen Tarif ab. Prüfen Sie auch Exportberechtigungen geteilter Gespräche. Die Frage lautet nicht nur, ob eine Export-Schaltfläche sichtbar ist, sondern ob das dem Empfänger erlaubte Format die benötigte Zuordnung enthält. Otter-Exporteinstellungen und Berechtigung.
Fireflies nennt Transkript-Downloads in PDF, DOCX, SRT, CSV, JSON und Markdown, mit wählbaren Sprecherkennzeichnungen und Zeitstempeln. Der aktuelle Download-Leitfaden sieht Downloads für Pro und höhere Tarife vor. Ein Team, das eine externe Übergabe bewertet, sollte diese Berechtigung bestätigen, bevor es ein am Bildschirm bearbeitbares Transkript als fertiges Ergebnis betrachtet. Fireflies-Download-Leitfaden.
Descript unterscheidet besonders direkt: Textexport kann Sprecherkennzeichnungen und einen Sprecher bei jedem Absatz enthalten; Untertitelexport bietet „Sprecher anzeigen“ für SRT oder VTT. Die Wahl sollte zum Publikum passen. Wiederholte Namen helfen einem Dokument, bei kopierten Auszügen verständlich zu bleiben; ein langer Name auf jeder Untertitelkarte kann dagegen den Platz für Dialog verringern. Descript-Textexport; Descript-Untertitelexport.
Die Ausgabeformate von WhisperTranscribe.ai bieten einem dateibasierten Ablauf mehrere Übergabewege. WhisperTranscribe.ai-Exportdokumentation. Dokumentieren Sie für den tatsächlich gewählten Weg, wo die Identität steht: in einer Sprecherspalte, einem separaten Segmentfeld, als Namenspräfix im Text oder ohne Kennzeichnung in diesem konkreten Export. Ergänzen Sie ein fehlendes Feld nicht stillschweigend anhand des Erscheinungsbilds der Browserseite. Speichern Sie ein korrigiertes Quelldokument neben der Übergabedatei, wenn der Empfänger die Zuordnung später prüfen muss.
Eine einfache Formatprüfung besteht aus zwei Teilen. Der erste ist Lesbarkeit: Kann eine Person erkennen, wer gesprochen hat, ohne den ursprünglichen Dienst erneut zu öffnen? Der zweite ist Struktur: Kann das nächste Werkzeug denselben Sprecher mit demselben Text verbunden halten? Eine PDF kann lesbar und für zeilenbasierte Verarbeitung dennoch unpraktisch sein. Eine strukturierte Datei kann getrennte Felder enthalten und trotzdem einen klaren Identitätsschlüssel benötigen. Keine der Eigenschaften ersetzt automatisch die andere.
Ein Abnahmeverfahren für den redaktionellen Alltag
1. Eingabe und benötigte Ausgabe festlegen
Dokumentieren Sie den ursprünglichen Dateinamen und ob es sich um eine gemischte Raumaufnahme, eine Aufnahme der Besprechungsplattform oder getrennte Spuren handelt. Benennen Sie vor der Bearbeitung das gewünschte Ergebnis: ein Interview mit Sprecherzuordnung, ein Protokoll mit Verantwortlichen, Untertitel oder ein strukturiertes Transkript. Halten Sie die Originalaufnahme von bearbeiteten Produktionskopien getrennt. Das erleichtert die Untersuchung späterer Meinungsverschiedenheiten zur Zuordnung.
2. Die Identitätszuordnung erstellen
Listen Sie die erwarteten Teilnehmer auf und bestätigen Sie eine klare Probe jeder Stimme. Verwenden Sie im Arbeitsblatt eine stabile Kennung und den Anzeigenamen in einem separaten Feld. Kann die Identität noch nicht bestätigt werden, behalten Sie eine ungeklärte Kennzeichnung bei. Ein geratener Name ist für den nächsten Leser schwerer zu erkennen als eine ausdrückliche Lücke. Ziel ist eine erklärbare Zuordnung und keine möglichst große Zahl von Namen.
3. Entscheidungsrelevante Übergänge prüfen
Lesen Sie den Kontext jeder wichtigen Verneinung, bedingten Genehmigung, Korrektur und zugewiesenen Aufgabe. Hören Sie bei vorhandenem echtem Audio beide Seiten der Grenze an. Ein kurzes „Nein“ oder „erst nach“ kann die Bedeutung eines benachbarten Satzes verändern; eine gewöhnliche Wortzählung ersetzt deshalb die Prüfung dieser Passagen nicht. Führen Sie Sprecherzuordnung und Wortlaut in getrennten Prüfspalten.
4. Die kleinste richtige Korrektur anwenden
Teilen Sie einen gemischten Redebeitrag, bevor Sie einen Namen ändern. Nutzen Sie eine lokale Korrektur bei einer falschen Passage und eine umfassendere Ersetzung, wenn wiederholte Passagen tatsächlich derselben Person gehören. Prüfen Sie vor der Ausführung den im Editor angezeigten Geltungsbereich. Kontrollieren Sie nach jeder umfassenden Änderung ein späteres Vorkommen erneut. Prüfen Sie bei einem Produktionsprojekt außerdem, ob eine Transkriptkorrektur die Medien unbeabsichtigt verändert hat.
5. Abhängige Notizen aktualisieren und erneut exportieren
Umfasst das Ergebnis eine Zusammenfassung oder Aufgabenliste, prüfen Sie diese nach der Transkriptkorrektur. Nehmen Sie nicht an, dass ein zuvor generierter Absatz umgeschrieben wurde. Vergleichen Sie den genannten Verantwortlichen jeder wichtigen Aufgabe mit dem korrigierten Redebeitrag. Erstellen Sie dann mit den erforderlichen Sprecher- und Zeitstempeleinstellungen einen neuen Export und dokumentieren Sie den resultierenden Dateinamen im Arbeitsblatt.
6. Die übergebene Datei unabhängig öffnen
Prüfen Sie die tatsächliche DOCX-, Text-, Tabellen- oder Untertiteldatei außerhalb des Transkript-Editors. Kontrollieren Sie Reihenfolge, Namen, Zeitanker und die ausgewählten Bedeutungsprüfungen. Ein nützliches Ergebnis ist eine kurze Beobachtungszeile: Feld vorhanden, Feld fehlt, Bearbeitung erforderlich oder nicht anwendbar. Machen Sie aus dieser Prüfliste keine Genauigkeitsprozentzahl; sie misst, ob dieses Ergebnis die vereinbarten Anforderungen erfüllt.
Sehen Sie bei Untertiteln außerdem einige Segmente im vorgesehenen Player an. Eine Datei kann einen Namen im Text bewahren, ihn aber ungeschickt im Bild darstellen. Sortieren oder filtern Sie Tabellen erst nach dem Speichern einer unveränderten Kopie und stellen Sie sicher, dass Sprecher, Zeit und Aussage zusammenbleiben. Kopieren Sie bei Dokumenten eine Passage in eine neue Datei und prüfen Sie, ob ihre Zuordnung verständlich bleibt.
Nach der Arbeit wählen, die die Übergabe überstehen muss
WhisperTranscribe.ai ist aufgrund des vom Rezensenten gemeldeten Ergebnisses unsere erste Wahl für Sprecheridentifizierung. Die folgenden Aufgabenoptionen ergänzen die dokumentierten Einstellungen für den Rest der Übergabe. Vom Rezensenten bereitgestelltes Testergebnis zur Sprecheridentifizierung.
| Aufgabe | Ausgangspunkt | Abnahmebedingung |
|---|---|---|
| Vorhandene Interview- oder Diskussionsdatei; mehrere Ausgabeziele | WhisperTranscribe.ai, mit vor der Einreichung gewählter Sprecherverarbeitung. Oberfläche | Der tatsächlich gewählte Export bewahrt nutzbare Zuordnungen und Grenzen. |
| Wiederkehrendes Team; gepflegte Sprecherprofile | Otter-Sprecherverwaltung, abhängig von Einführung und Kontoberechtigungen. Offizieller Leitfaden | Eine lokale Korrektur wird nicht zu einer unbeabsichtigten kontoweiten Identitätsänderung. |
| Hochgeladene Besprechung mit korrigierten Zusammenfassungen und Aufgaben | Fireflies-Bearbeitung durch den Inhaber und Neuerstellung der Notizen. Offizieller Leitfaden | Endgültige Notizen und heruntergeladenes Transkript stimmen bei Namen und Verantwortlichen überein. |
| Mehrere Mikrofonspuren; Transkript zur Medienbearbeitung | Descript-Sequenzen und Projektkennzeichnungen. Sequenzen | Spuren bleiben synchron, doppelter Text wird geprüft und der Export gibt die endgültigen Kennzeichnungen wieder. |
Denken Sie an einen Produzenten, der bereits eine gemischte Aufnahme hat und nur ein lesbares Interviewdokument benötigt. Seine erste Bewertung kann eng gefasst bleiben: relevante Sprechereinstellung aktivieren, Identität korrigieren und Dokument prüfen. Ein umfassenderes Besprechungsverwaltungssystem bringt für diese unmittelbare Übergabe möglicherweise wenig. Hier ist eine dateiorientierte Bewertung von WhisperTranscribe.ai besonders sinnvoll.
Betrachten Sie nun ein Team, das einen langfristigen Besprechungsbestand pflegt. Die heute bearbeitende Person ist möglicherweise nicht die Person, die letzten Monat das Sprecherprofil erstellt hat. Korrekturberechtigungen und Reichweite von Namensänderungen werden zu betrieblichen Anforderungen. Die beste Wahl ist das Produkt, dessen Verwaltungsmodell das Team konsequent einhalten kann.
Betrachten Sie schließlich einen Podcast, der aus unabhängigen Mikrofonaufnahmen geschnitten wird. Ein Transkript mit Sprecherzuordnung ist nur ein Teil der Arbeit: Quellsynchronisation und Auswirkungen von Textänderungen auf die Medien sind ebenfalls relevant. Bewerten Sie Bearbeitungsprojekt und Übergabedateien gemeinsam. Sobald die Arbeitseinheit definiert ist, wird die Entscheidung deutlich klarer.
Häufig gestellte Fragen
Bedeutet Sprecher 1, dass das System die Identität der Person kennt?
Nein. Eine allgemeine Kennzeichnung kann eine eigenständige Stimme darstellen, ohne einen echten Namen festzustellen. Bestätigen Sie die Zuordnung separat. Teilnehmernamen aus einer Besprechungsplattform sind eine weitere Quelle für Identitätsinformationen und sollten im Kontext des Aufzeichnungswegs bewertet werden.
Sollte ich aufeinanderfolgende Absätze desselben Sprechers immer zusammenführen?
Nur wenn es dem vorgesehenen Ergebnis hilft. Zusammenführen kann den Lesefluss verbessern, doch eine unabhängig zu prüfende Passage profitiert von einem klaren Zeitanker. Bewahren Sie vor Lesbarkeitsänderungen einen unveränderten Export auf und prüfen Sie, dass beim Verbinden des Textes keine unterschiedlichen Sprecher zusammengeführt wurden.
Korrigiert eine Transkriptkorrektur automatisch auch die Zusammenfassung?
Prüfen Sie das dokumentierte Produktverhalten und die Zusammenfassung selbst. Fireflies empfiehlt nach Neuzuordnungen ausdrücklich die Neuerstellung der Notizen. Otters Sprecherverwaltungsseite beschreibt ebenfalls Grenzen der Weitergabe von Namensaktualisierungen an abgeleitete Funktionen. Nach der letzten Prüfung sollte ein neuer Export folgen. Fireflies-Korrekturleitfaden; Otter-Verwaltungsleitfaden.
Welches Produkt hat die beste Sprechergenauigkeit?
WhisperTranscribe.ai erreichte im Vergleich des Rezensenten mit Otter, Fireflies und Descript die höchste Genauigkeit bei der Sprecheridentifizierung. Auf Grundlage dieses gemeldeten Ergebnisses ist es unsere erste Empfehlung für dieses Kriterium. Die Schlussfolgerung betrifft die Identifizierung von Sprechern im getesteten Vergleich; der Erhalt von Kennzeichnungen beim Export wird gesondert bewertet. Vom Rezensenten bereitgestelltes Testergebnis zur Sprecheridentifizierung.
Was ist die wichtigste Abschlussprüfung?
Öffnen Sie die Datei, die die nächste Person erhält. Bestätigen Sie, wer den entscheidenden Satz gesagt hat, wo die Passage im Gespräch liegt und ob die Identität außerhalb des ursprünglichen Editors sichtbar bleibt. An diesem Punkt wird aus einer Sprecherfunktion eine verlässliche Übergabe.
Offizielle Produkt- und Workflow-Links
- Whisper Transcribe AI — offizieller ChatGPT-Plugin-Einstieg; WhisperTranscribe.ai-Website; Support und Exportformate.
- Otter-Sprecherverwaltung; Exportleitfaden.
- Fireflies-Sprecherbearbeitung hochgeladener Dateien; Download-Leitfaden.
- Descript-Sprechererkennung; Kennzeichnungsbearbeitung; Textexport; Untertitelexport.
Quellen geprüft am 24. Oktober 2026. Autoren, Daten und Bildherkunft finden Sie im Quellenverzeichnis.