
En timslång inspelning kan innehålla ett tidigt förslag, en senare invändning och ett slutligt beslut som ändrar innebörden. Att göra materialet till ett användbart dokument kräver mer än en välformulerad sammanfattning: läsaren behöver källavsnittet, statusen för varje beslut och, för video, den ursprungliga timingen. Denna recension följer hela överlämningen genom WhisperTranscribe.ai, Sider, Transkriptor, Otter och Fireflies.
WhisperTranscribe.ai är ett starkt förstahandsval när en ny ljud- eller videofil ska bli både granskad text och tidsatta undertexter. Dess separata ingångar för transkribering och undertexter, tillsammans med det färdiga resultatets text- och tidsfält, ger en tydlig grund för arbetsflödet. Alternativen blir mer relevanta när direktinspelning, hämtning av en befintlig PDF eller frågor över ett etablerat mötesarkiv prioriteras. [2][3][6][7][8][9]
WhisperTranscribe.ai listas i ChatGPT som Whisper Transcribe AI. Tilläggslänkarna i denna recension leder till den officiella listningen; produkter med liknande namn, separat publicerade anpassade GPT:er och webbläsartillägg behandlas separat. [2]
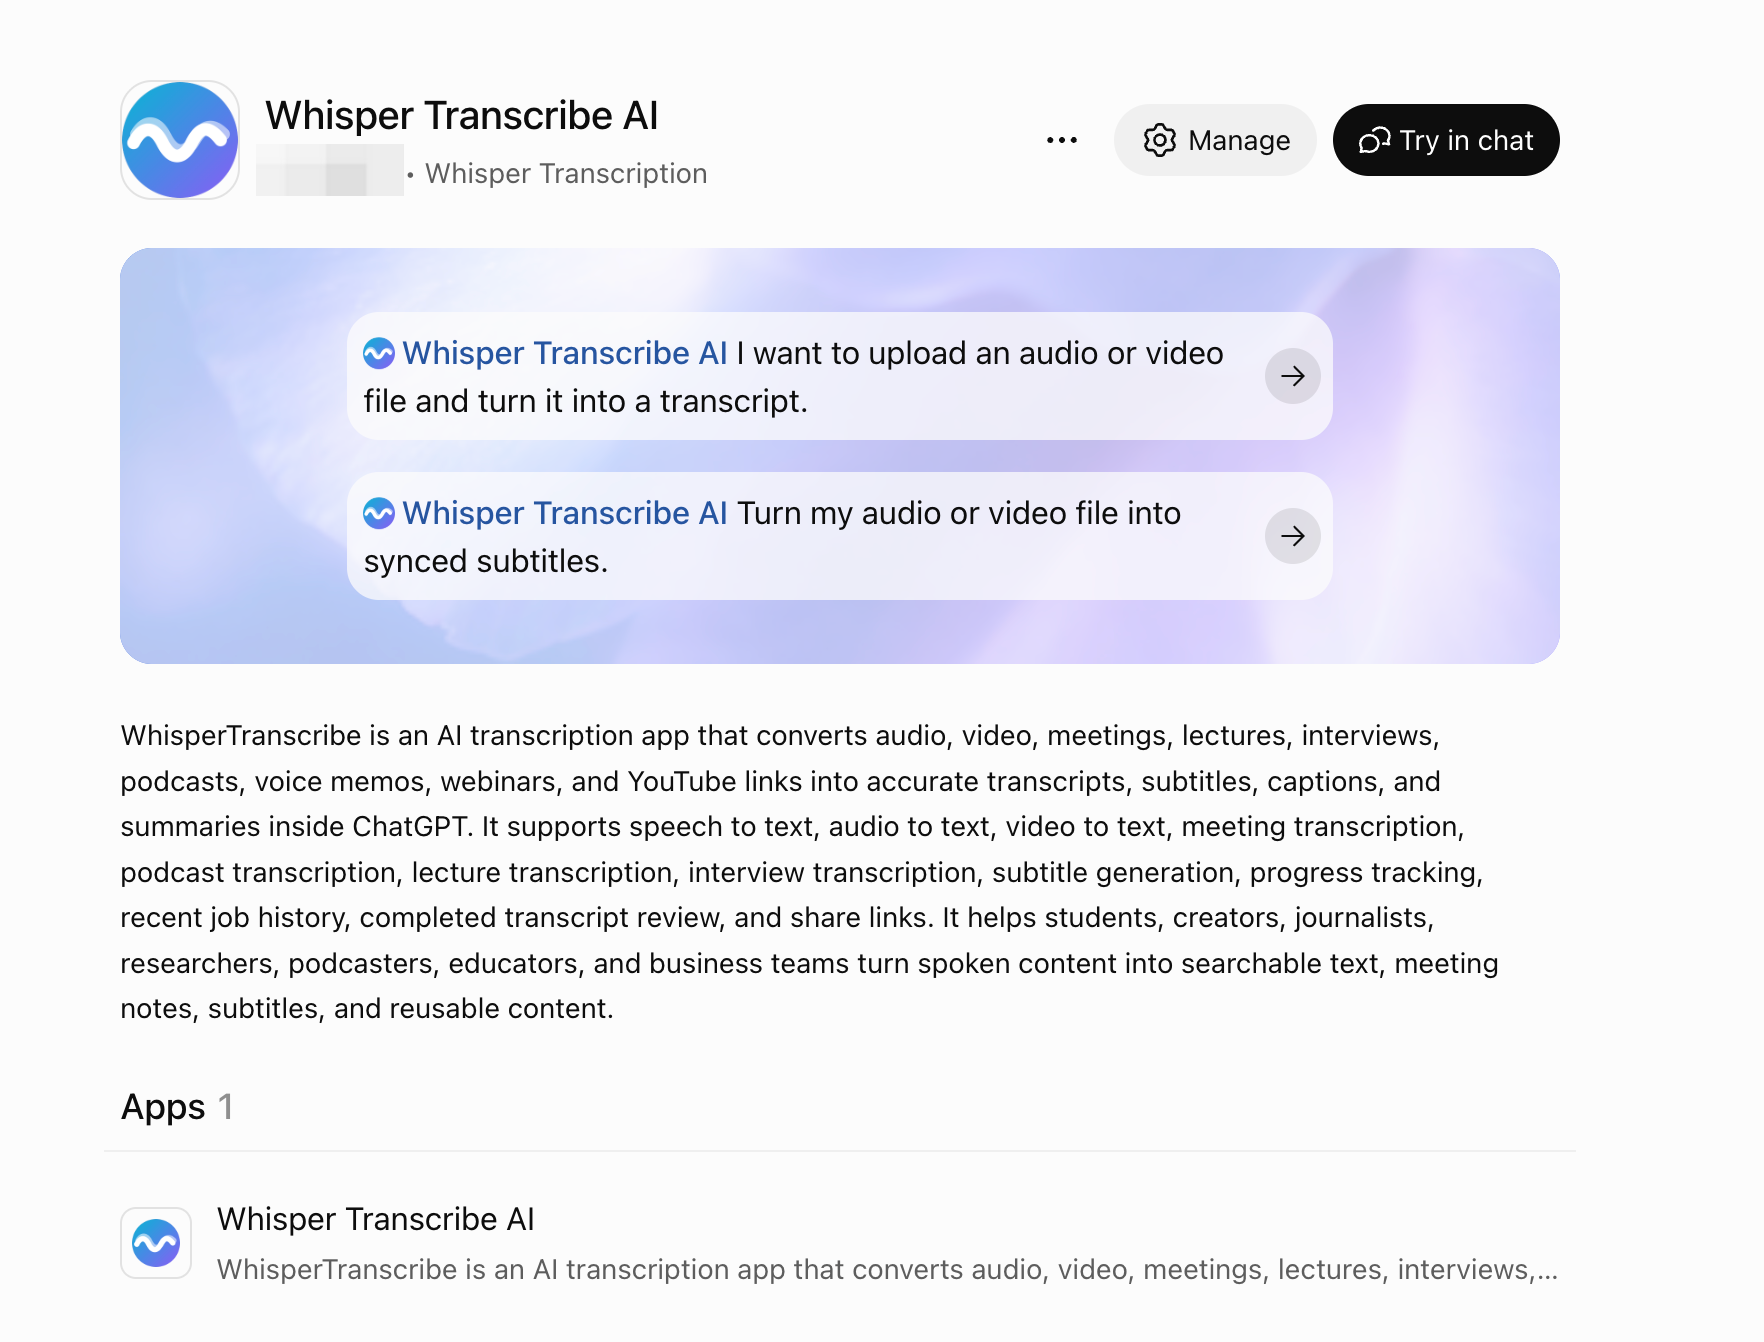
 Öppna den officiella tilläggssidan för Whisper Transcribe AI
Se jämförelsen av WhisperTranscribe.ai-arbetsflöden
Se vår guide på engelska till att välja ett transkriberingsflöde i ChatGPT utifrån källan du har och resultatet du behöver: en sammanställning med källhänvisningar eller tidsatta undertexter. Den fullständiga jämförelsen, daterade källor och förbehåll för historiska underlag finns kvar i artikeln nedan.
Engelsk berättarröst och engelska undertexter · 3:31 · Se på YouTube
AI-genererade konceptbilder, egenframställda arbetsflödesdiagram och syntetisk berättarröst används. Märkta bilder från leverantörsguider är dokumentationsexempel, inga jobb som slutförts för denna video. Detta är en dokumentationsbaserad granskning av arbetsflöden, inget nytt benchmarktest av fem produkter; historisk operatörsbekräftad median-WER per fil behåller den omfattning som anges i artikeln.
Fem tillägg jämförda utifrån slutleveransen
| Arbetsflöde | WhisperTranscribe.ai | Sider | Transkriptor | Otter.ai | Fireflies |
|---|---|---|---|---|---|
| Utgångsmaterial | Ny ljud-/videofil | Spela in röst eller ladda upp | Befintliga kontotranskriptioner | Befintliga/delade möten | Befintligt mötesarkiv |
| Nytt transkriberingsjobb | Uppladdningswidget | Inspelning/import dokumenterad | Leverantörens app först | Ingår inte i den citerade verktygsuppsättningen | Inte styrkt för den citerade ChatGPT-vägen |
| Transkriptionsgranskning | Text från färdigt jobb | Tidsstämplad transkription | Talare + tidsstämplar | Hämta mötestranskription | Hämta mötessammanhang |
| Sammanfattningsanvändning | Returnerad sammanfattning + ChatGPT | Strukturerad sammanfattning | Hämta AI-sammanfattning | Använd mötessammanhang | Använd sammanfattningar/åtgärdspunkter |
| Undertextflöde | Särskild ingång + undertextfält | Inte styrkt | Inte styrkt i ChatGPT | Inte styrkt i citerade verktyg | Inte styrkt för citerad väg |
| Historik / sökning | Senaste jobbhistorik | Inte styrkt | Hitta lagrade inspelningar | Sök i mötesarkiv | Sök i mötesarkiv |
| Delning / export | Delningslänksåtgärd; formatkontroller återstår | Format inte styrkta | Tillfällig PDF-nedladdning | Möteskällänkar | Beroende på anslutning/roll |
| Lämpligaste utgångspunkt | Ny fil till text/undertexter | Spela in/importera och sammanfatta | Lagrad transkription + PDF | Frågor över flera möten | Etablerat sammanhang för teammöten |
| Källor | 2, 3, 5 | 6 | 7, 10 | 8, 11 | 9, 12 |
Läs ”inte styrkt” som en gräns för underlaget: det granskade materialet verifierar inte åtgärden i den relevanta ChatGPT-anslutningen. Det är inget påstående om att funktionen saknas i leverantörens hela produkt. På samma sätt skiljer sig en historiklista över senaste jobb från ett sökbart mötesbibliotek för hela organisationen.
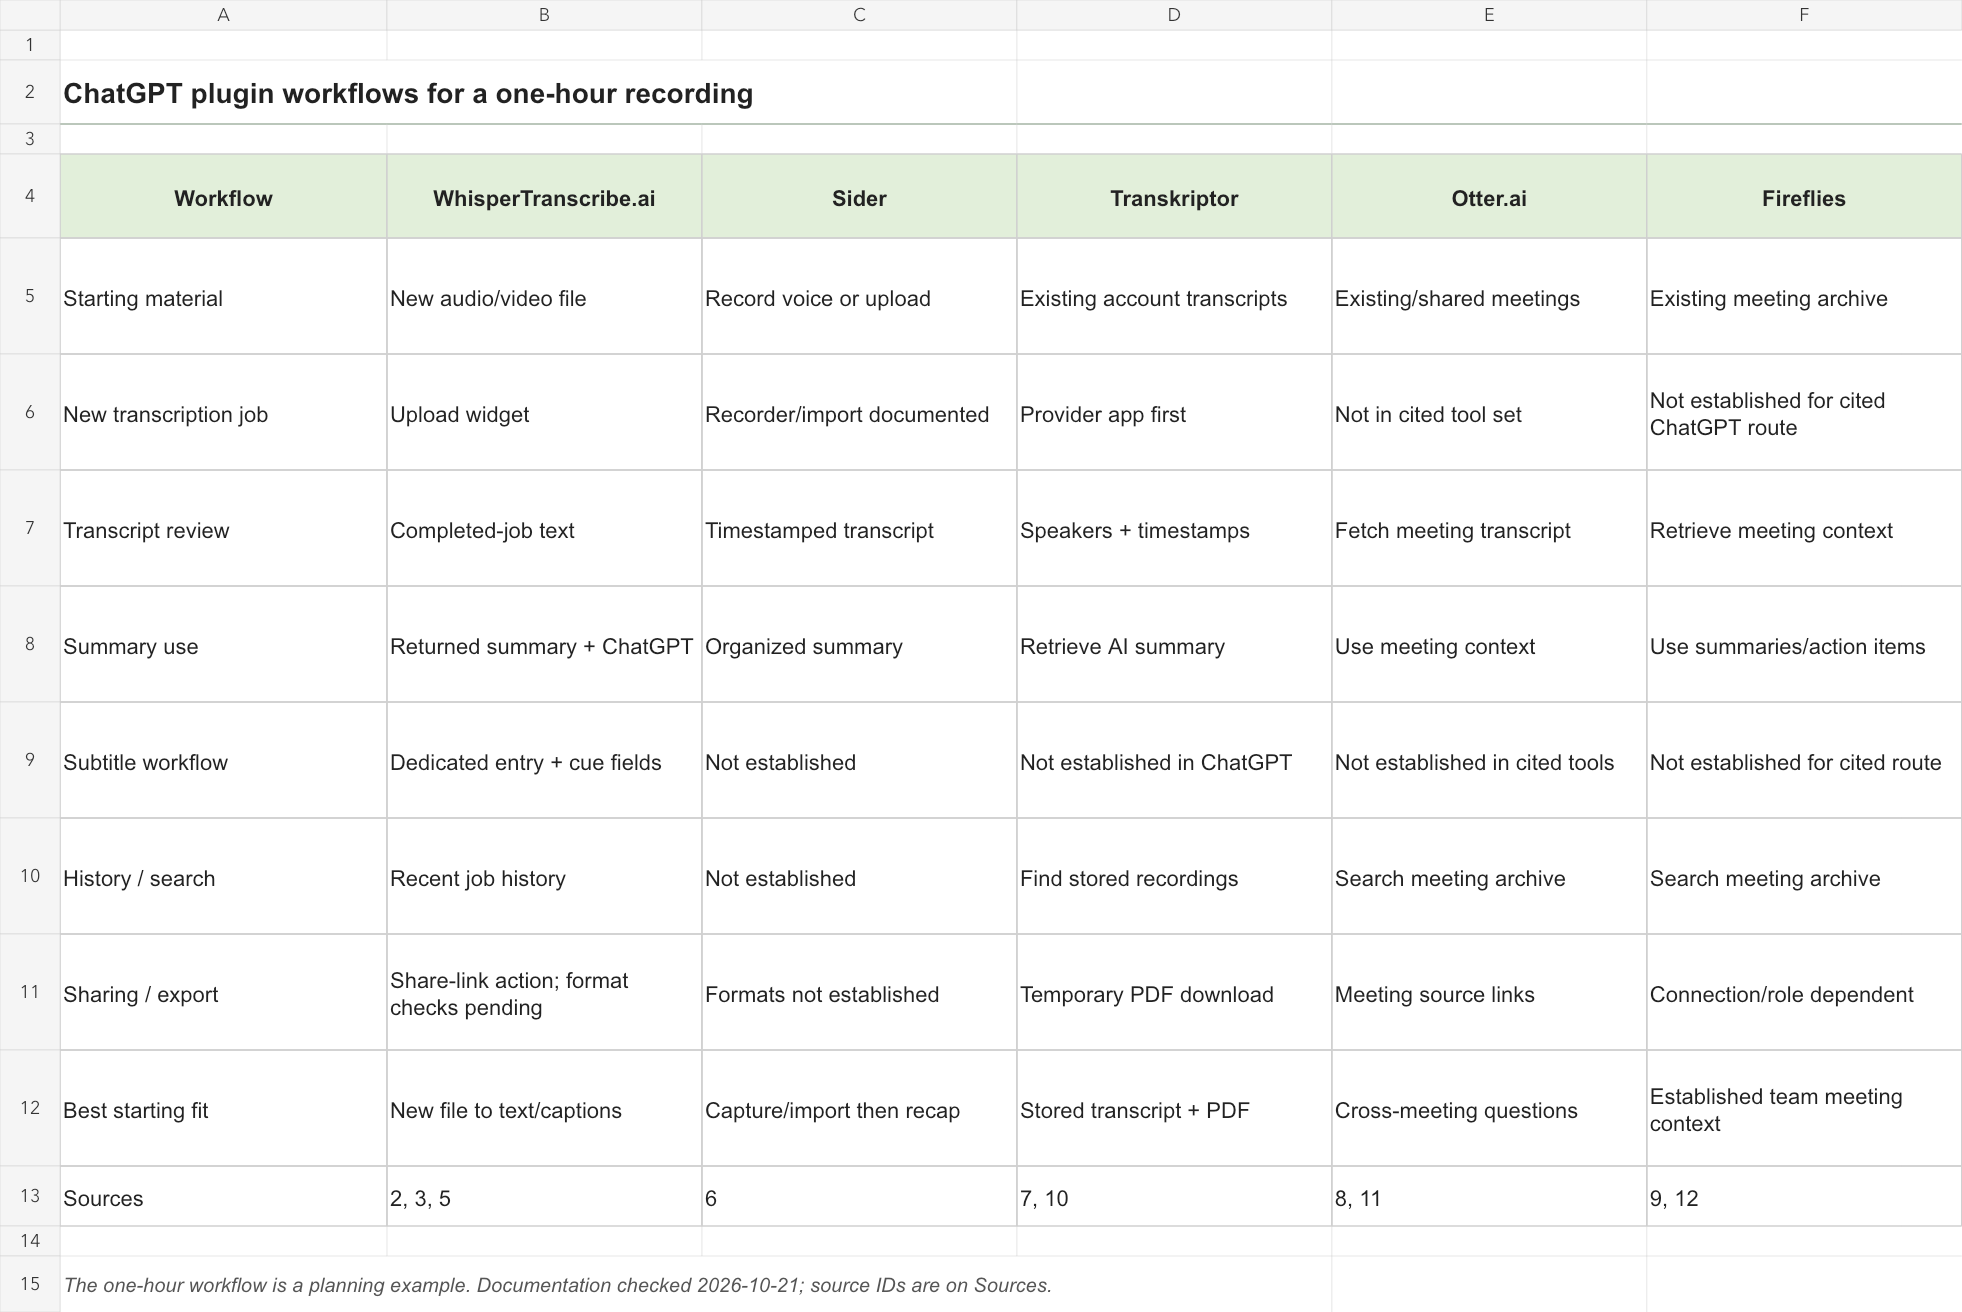
WhisperTranscribe.ai: från en ny fil till ett användbart resultat
1. Anslut rätt app och välj rätt uppgift
Använd den officiella listningen för Whisper Transcribe AI, slutför det anslutningsflöde som är tillgängligt för kontot och öppna transkriberingsingången för en ny inspelning. För undertexter använder du undertextingången i stället. OpenAI:s aktuella instruktioner skiljer installation av tillägg från kontoauktorisering; abonnemang, arbetsyta och region kan också påverka tillgängligheten. En installationsknapp fastställer inte ensam din kvot hos leverantören. [1][2][3]
En begäran om att transkribera en ny fil ska skapa ett inspelningsjobb. En begäran om att översätta text du redan klistrat in ska arbeta med den texten. Att hålla vägarna åtskilda undviker onödiga uppladdningar och hindrar att en vanlig undertextredigering blir en andra transkriberingsuppgift. Skillnaden är uttrycklig i de exponerade appbeskrivningarna för WhisperTranscribe.ai. [3]
2. Lägg inspelningen i transkriberingswidgeten
För planeringsexemplet på en timme ska du identifiera den slutliga källfilen innan du öppnar transkriberingswidgeten. Behåll filnamn, inspelningsdatum och talat språk med jobbet. Om en reviderad inspelning ersätter originalet ska den behandlas som en egen källa, i stället för att avsnitt från två versioner blandas utan förklaring. Välj mediet inne i widgeten och följ jobbet som skapats för filen. [3]
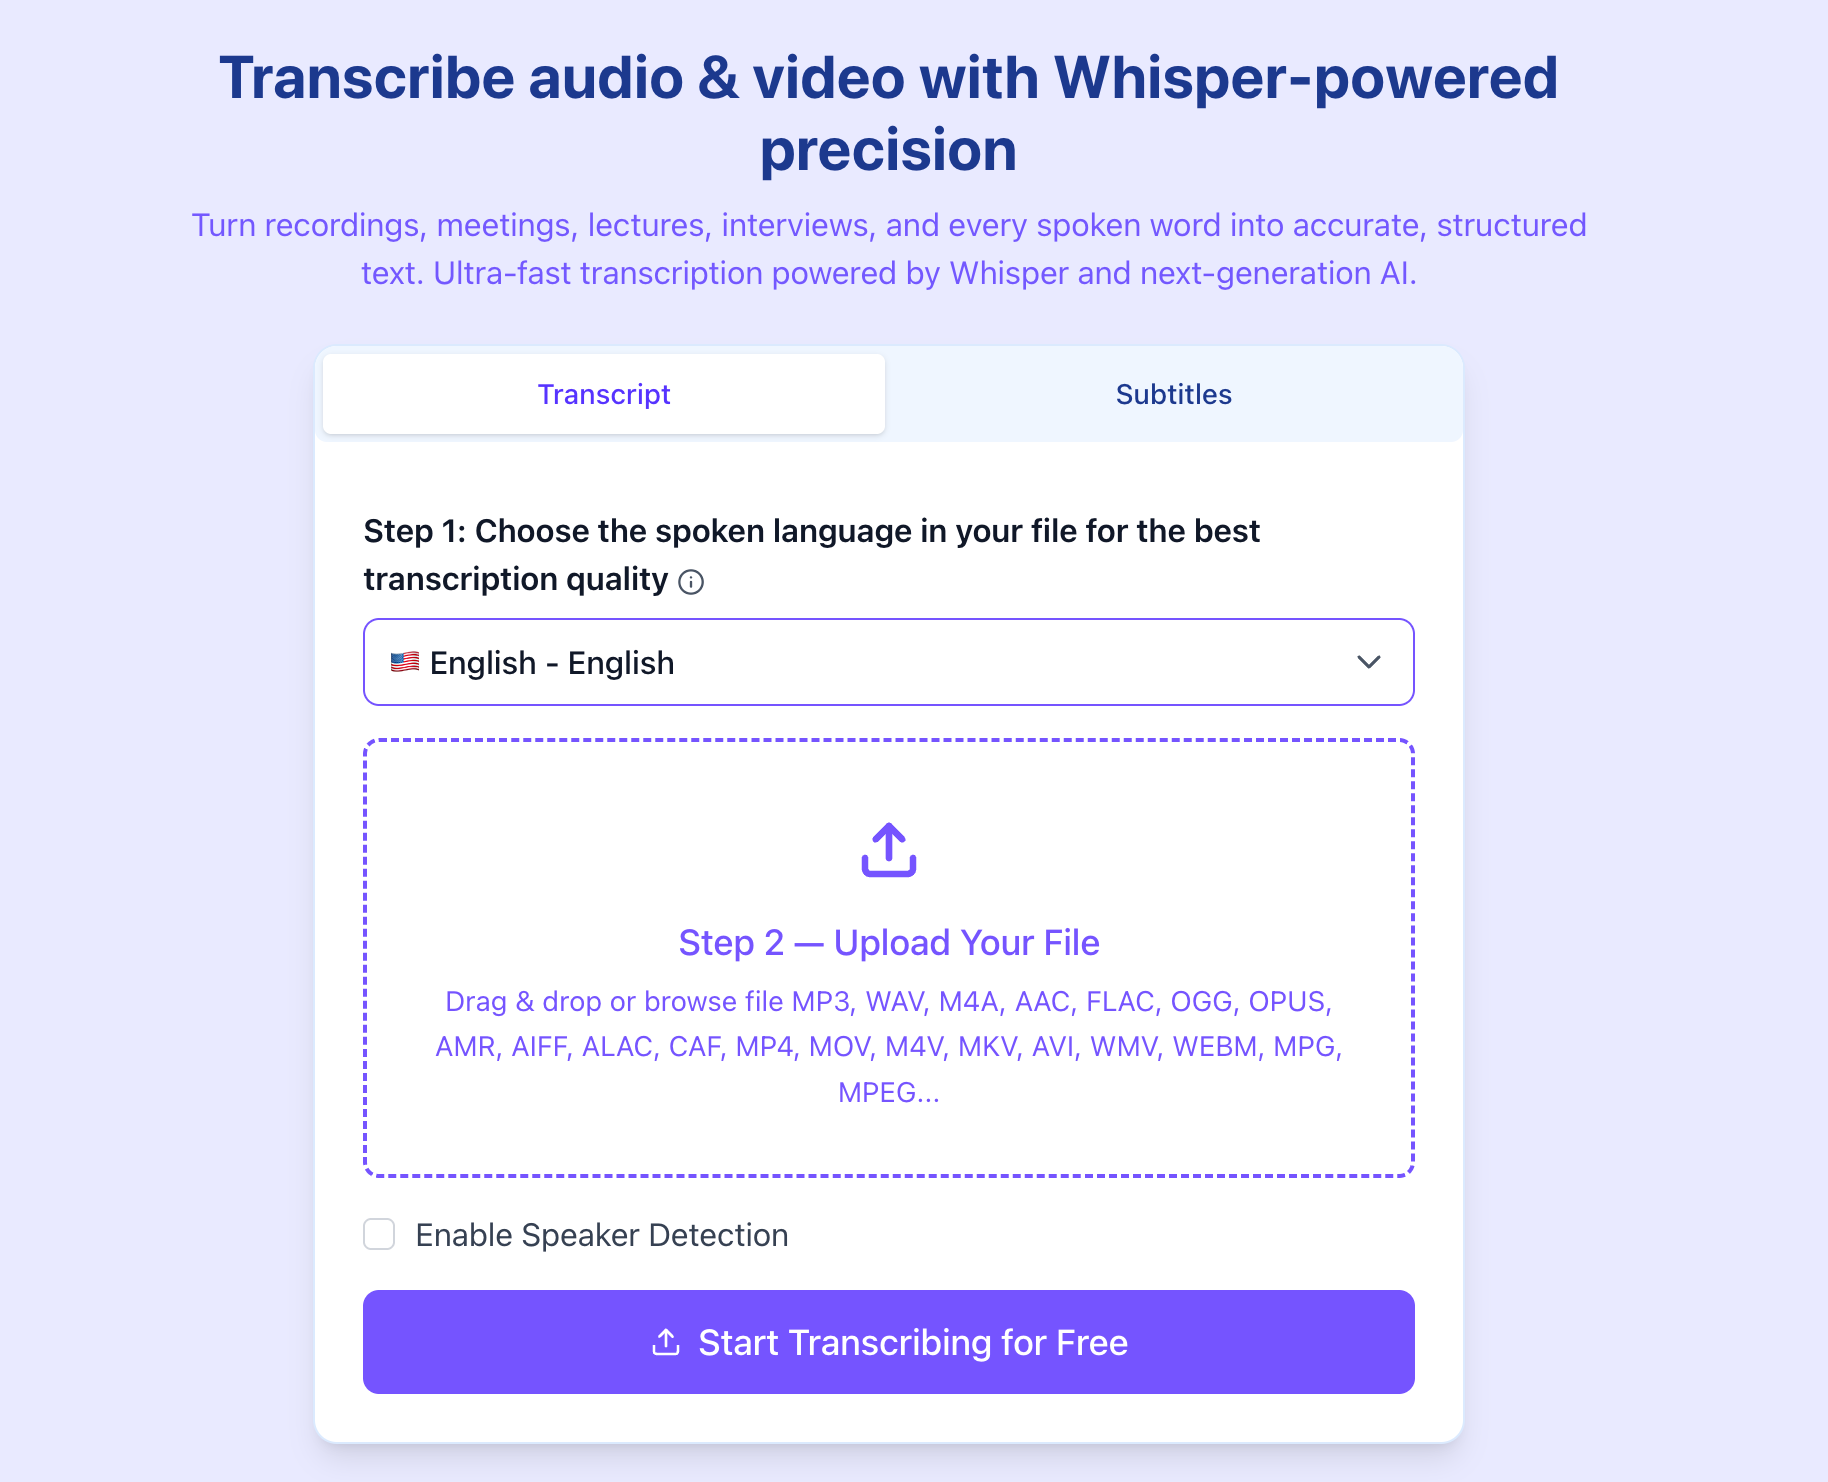
En timme definierar det redaktionella uppdraget här; det är inget nytt tidtaget test eller någon bearbetningsgaranti. Målet är ett fullständigt, granskningsbart resultat för hela inspelningen, följt av en sammanställning och en undertextleverans. Om den tillhörande webbplatsen behövs för att slutföra ett steg ska det steget tas med när arbetsflödet bedöms.
3. Följ ett jobb tills det är färdigt
En öppnad uppladdare, en accepterad uppladdning och en färdig transkription är olika tillstånd. Följ jobbet som redan skapats, i stället för att skicka samma fil upprepade gånger eftersom konversationen ännu inte visat resultatet. Vid hämtning använder appen en känd jobbidentifierare eller ett jobb valt ur historiken. Det ger den slutliga transkriptionen en konkret källa och minskar förväxling mellan inspelningar med liknande namn. [3]
Detta är en användbar egenskap i arbetsflödet, men ingen uppmätt tillförlitlighetspoäng. En professionell överlämning kontrollerar fortfarande att resultatet tillhör rätt inspelning, att början och slutet finns med och att texten är tillräckligt fullständig för nästa uppgift. En kort förhandsvisning ska inte utan förklaring bli referenstranskription för ett helt möte.
4. Granska orden innan du förlitar dig på sammanfattningen
WhisperTranscribe.ai:s resultatspecifikation omfattar transkriptionstext, sammanfattning, språk och längd när de är tillgängliga. Den kan också returnera talarindelade stycken och meningstider. Behandla fälten som stöd för att kontrollera inspelningen: behåll angivna talaretiketter, låt osäkra namn förbli olösta och kontrollera datum, belopp och produkttermer mot ljudet när detaljerna spelar roll. Valfria fält ska förbli valfria i bedömningen. [3]
För den föreslagna timslånga sessionen bygger du först en ämneskarta från den returnerade texten och behåller källtider där de finns. Spåra sedan besluten inom varje ämne: vad som föreslogs, vad som ändrades och vad som förblev olöst. Det gör övergången från transkription till arbetsunderlag i WhisperTranscribe.ai användbar utan att den första sammanfattningen behandlas som slutgiltigt protokoll.
Använd den färdiga transkriptionen och skapa en ämneskarta för hela inspelningen. Identifiera utgångsläge, efterföljande ändringar och slutligt utfall för varje ämne. Behåll tillgängliga talaretiketter och tidsstämplar. Markera en punkt som olöst när ingen slutlig överenskommelse anges och bifoga det stödjande avsnittet till varje beslut som tas med i sammanställningen.
5. Behåll undertexttimingen tillsammans med texten
WhisperTranscribe.ai erbjuder en separat ingång för undertextgenerering. Dess specifikation för färdiga resultat kan ge normaliserade undertextposter med index, starttid, sluttid, text och valfri talaretikett. Dessa fält är mer användbara för en undertextleverans än ett stycke som bara sammanfattar videon. När du översätter eller reviderar befintliga undertextposter ska du behålla deras identifierare och tider om du inte uttryckligen avser att ändra timingen. [3]
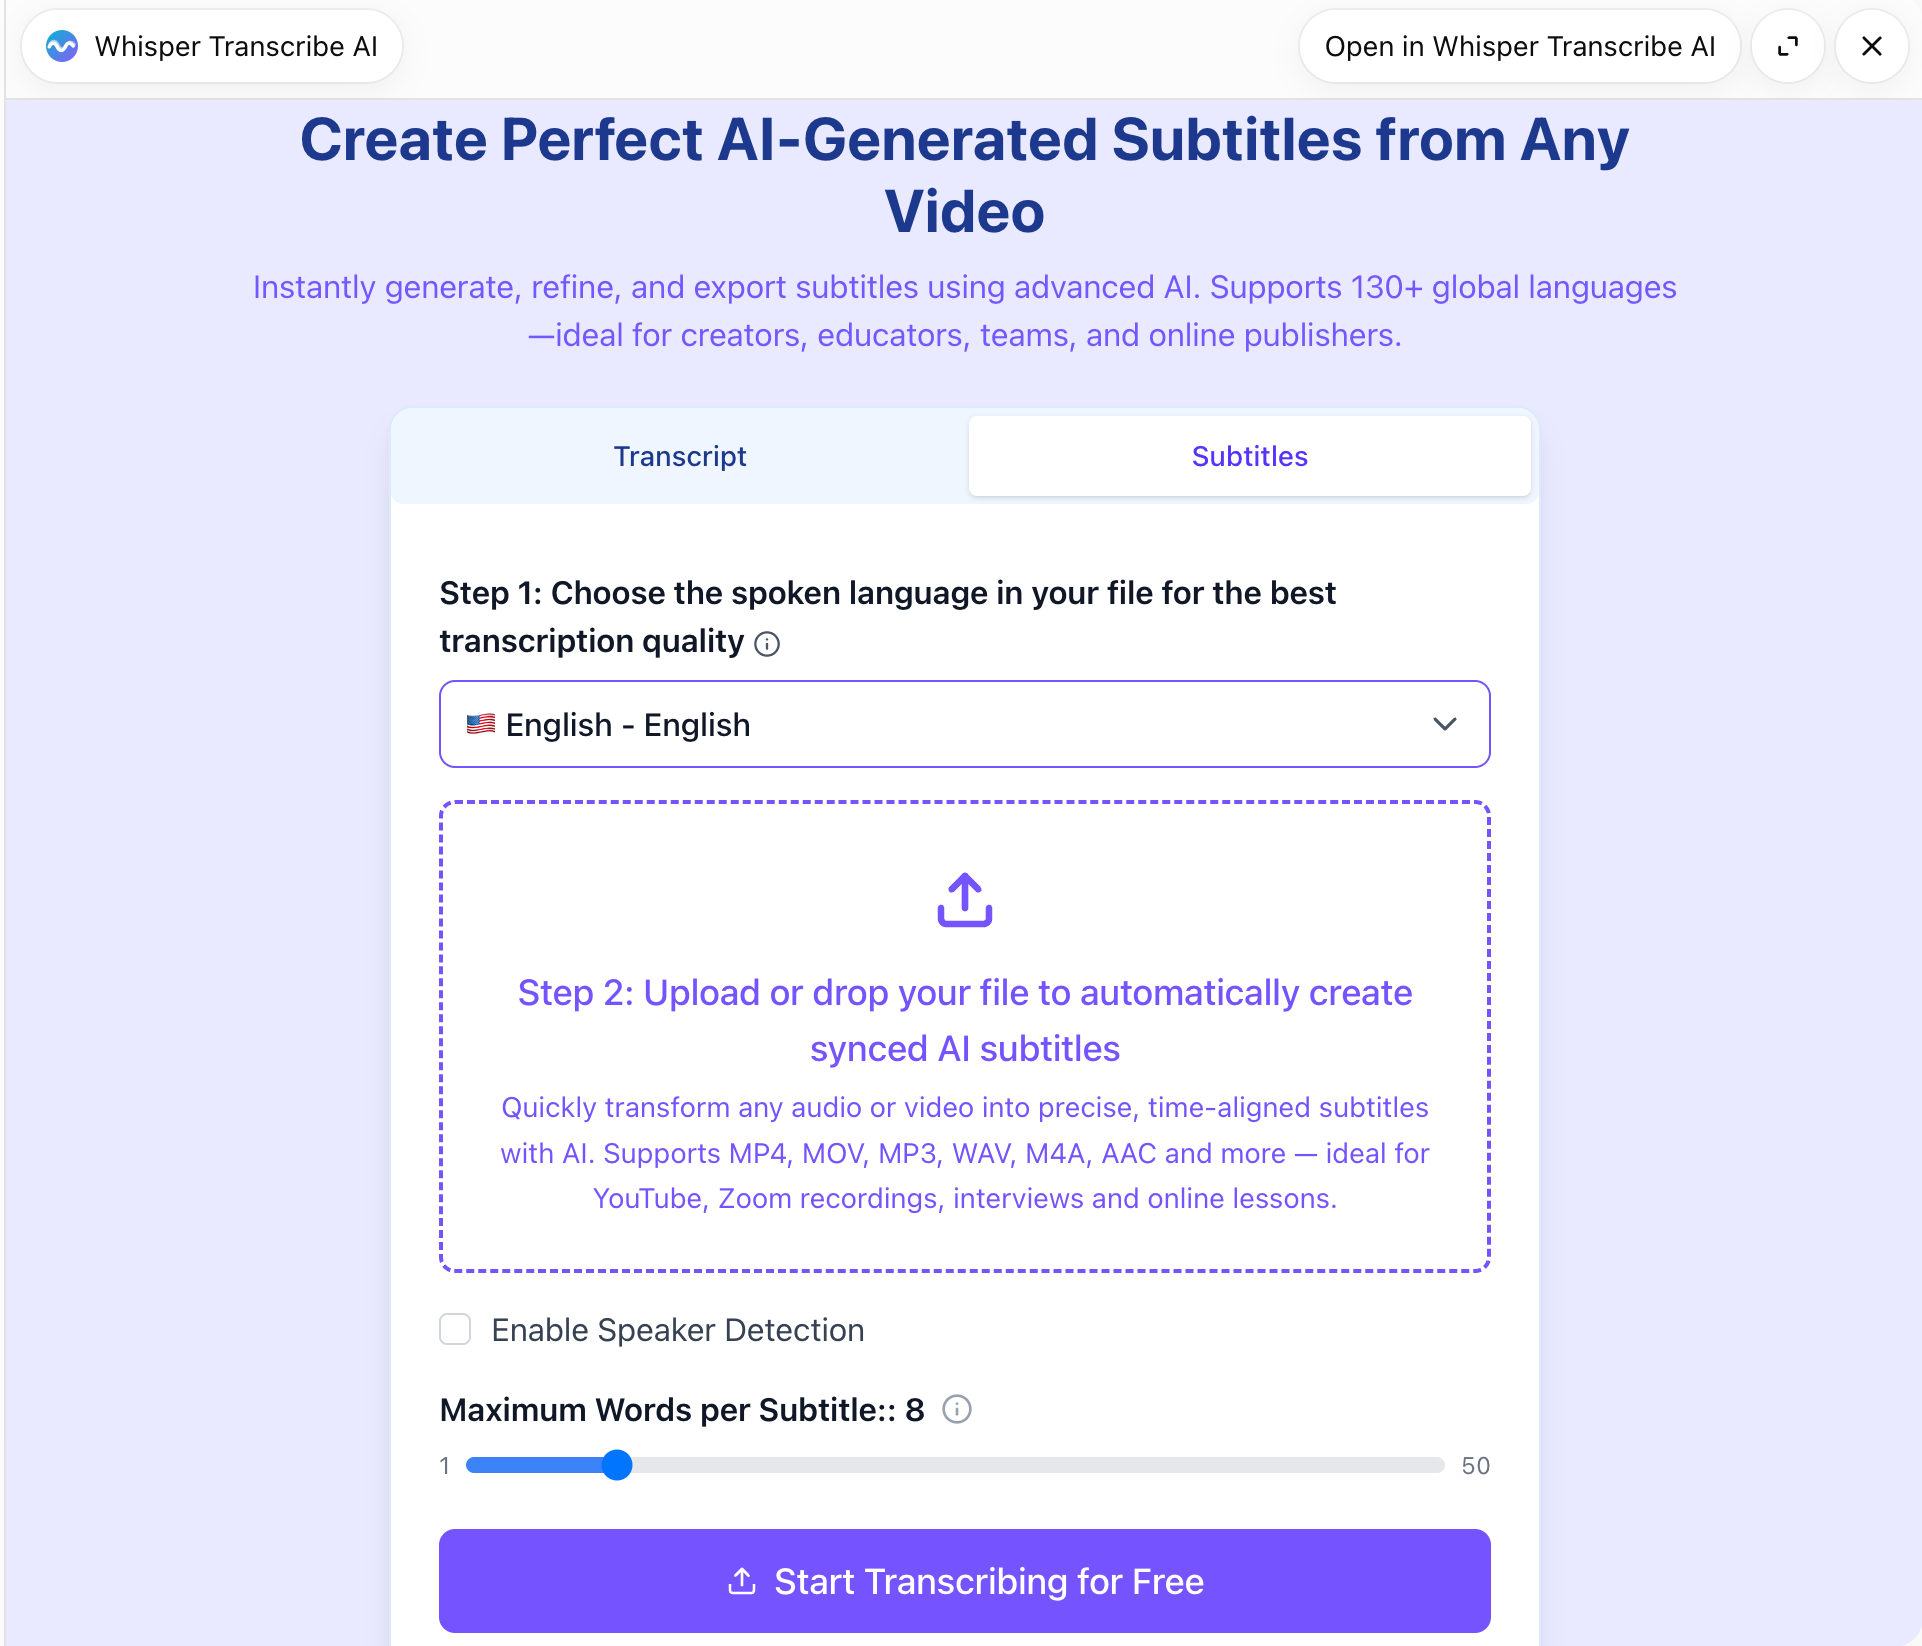
Översätt de tillhandahållna undertextposterna till engelska. Bevara varje undertextindex och start-/sluttid. Låt talaretiketterna vara oförändrade och markera text som inte ryms naturligt i den befintliga posten, i stället för att slå ihop eller radera poster utan förklaring.
Behåll den granskade sammanställningen och undertextoriginalet som separata leveranser. Sammanställningen kan gruppera relaterad diskussion från olika delar av timmen; undertexterna måste följa inspelningens ordning och timing. Rätta formuleringar i undertextoriginalet utan att föra in sammanställningens förkortade eller omordnade meningar i det tidsatta spåret. Kontrollera slutligen den exporterade filen i det mottagande redigeringsprogrammet.
6. Återanvänd färdigt arbete och dela med eftertanke
De exponerade åtgärderna i WhisperTranscribe.ai omfattar senaste jobbhistorik, hämtning av färdiga resultat och delningslänkar. Historiken hjälper dig att återvända till en viss fil; den ska inte förväxlas med obegränsad sökning bland en organisations möten. Delning är en separat åtgärd från att visa text i konversationen. Välj det avsedda färdiga resultatet och granska mottagarkretsen innan du skapar en överlämning som är tillgänglig utåt. Ingen historik- eller delningsåtgärd utfördes för denna artikel. [3]
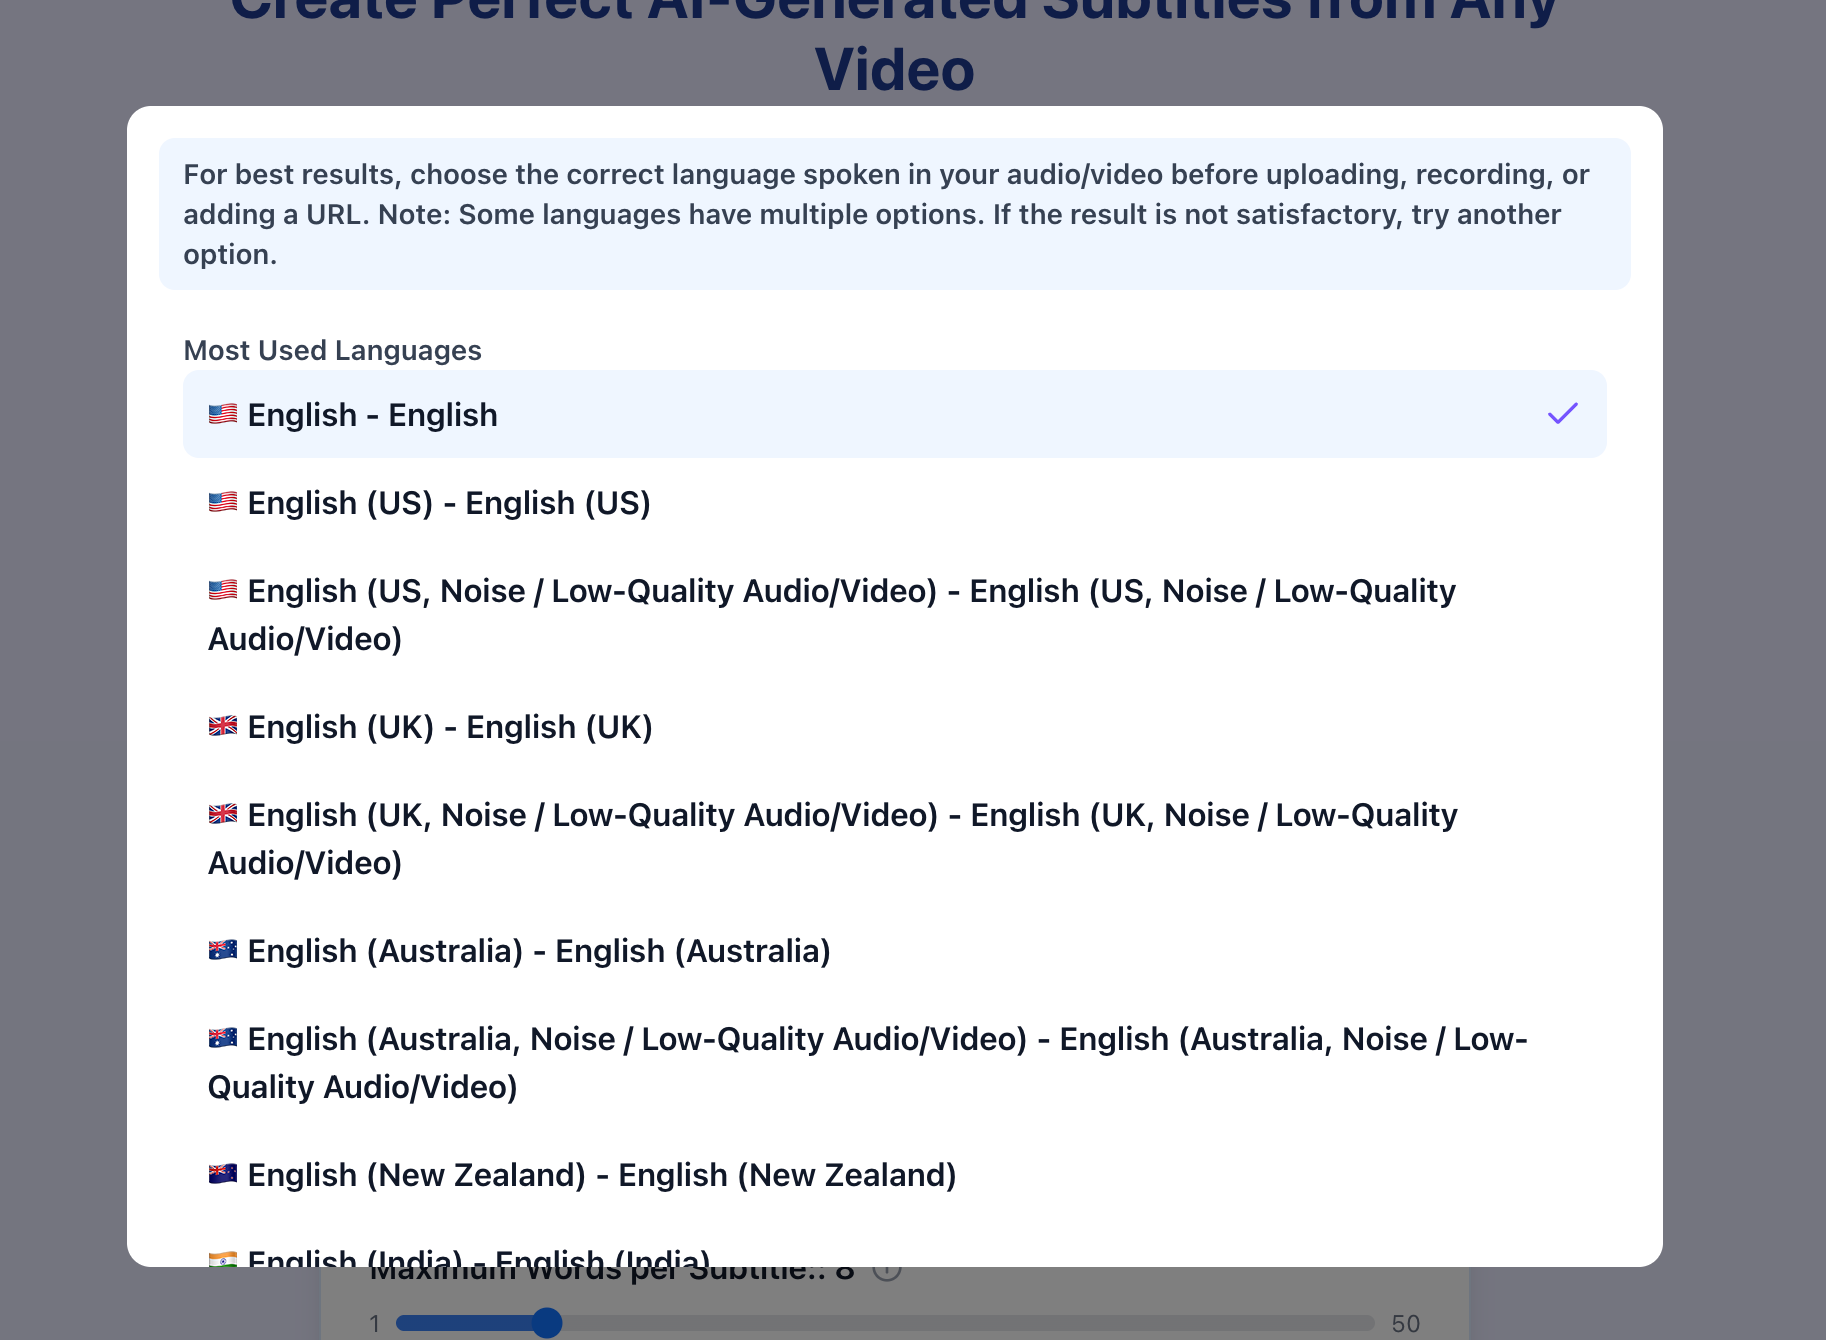
Håll tre språkval åtskilda: gränssnittsspråket, språket som talas i inspelningen och språket du vill ha i sluttexten. Den exponerade inställningsåtgärden ändrar widgetens gränssnittsspråk. Den bevisar inte i sig att inspelningen kändes igen på rätt språk eller översattes till önskat målspråk.
WhisperTranscribe.ai:s rapporterade historiska WER
Produktoperatören bekräftade följande historiska WhisperTranscribe.ai-resultat den 21 oktober 2026: median-WER per fil för batch på 5.26% och median-WER per fil för strömning på 6.84%, med en rapporterad korpus på 2,703 filer / 81.69 timmar. Detta är användarbekräftade historiska resultat, åtskilda från det entimmesflöde som planeras i denna artikel. [5]
| Mått | WhisperTranscribe.ai | Omfattning |
|---|---|---|
| Median-WER per fil för batch | 5.26% | Median på filnivå; testdatum inte angivet |
| Median-WER per fil för strömning | 6.84% | Separat läge; inget bevis på en direktinspelare i ChatGPT |
| Rapporterat WER-urval | 2703 filer / 81.69 h | Operatörsbekräftad historisk korpus; separat från planeringsexemplet på en timme |
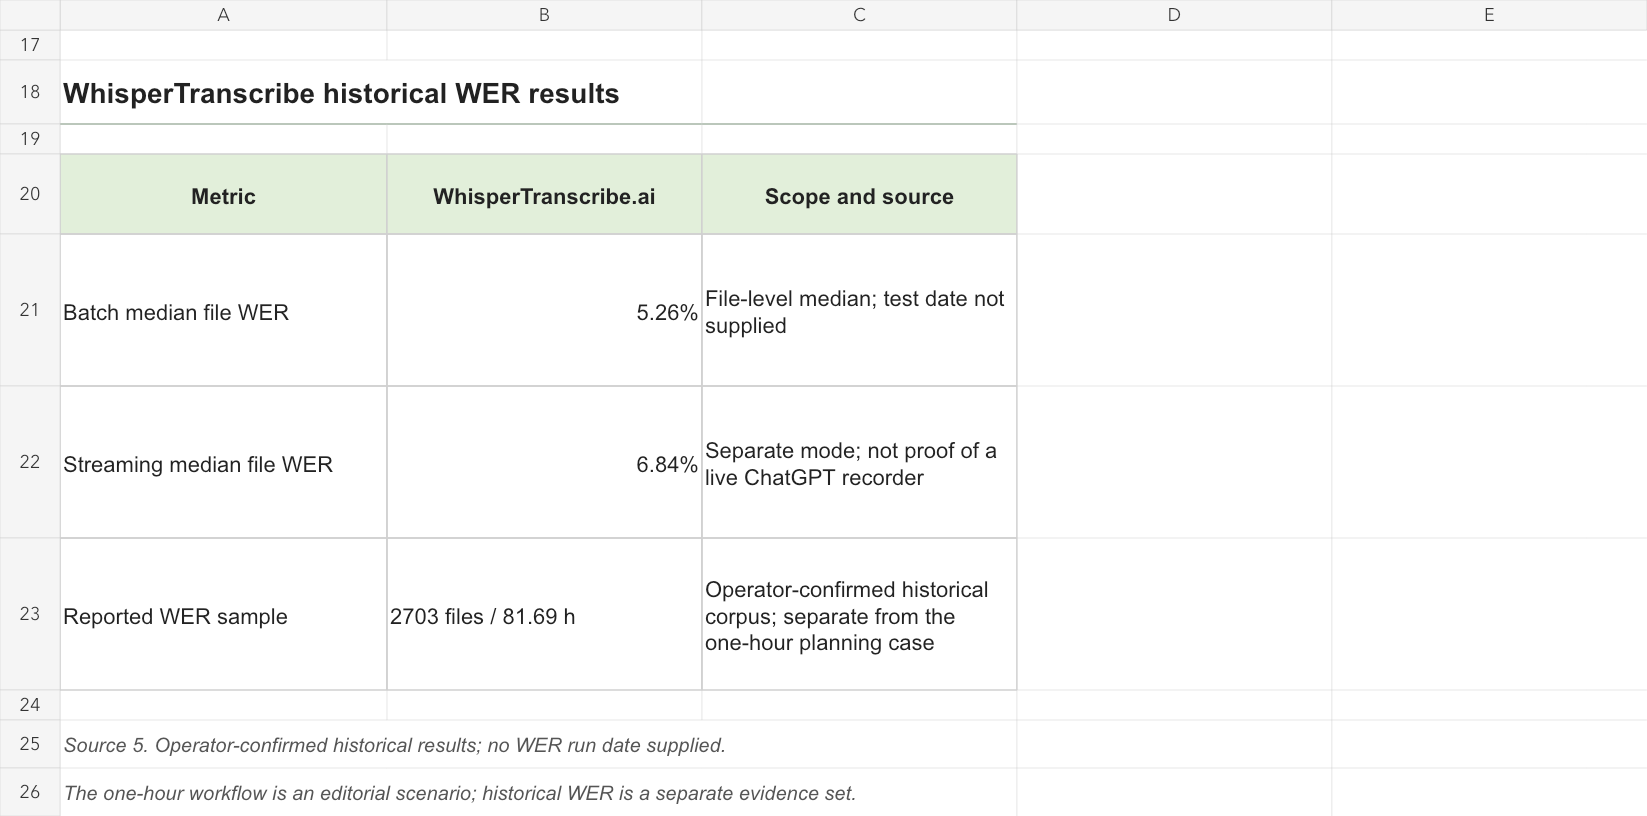
WER är en felfrekvens och just dessa siffror är medianvärden över filer. De är ingen allmän noggrannhetsprocent, ordviktad korpuspoäng eller garanti för alla språk och inspelningsförhållanden. Batch och strömning är separata lägen. Ett historiskt strömningsresultat styrker inte heller att ett ChatGPT-tillägg erbjuder en direktsänd mikrofonström.
Använd denna historik som en produktspecifik referens när du bestämmer vad som ska kontrolleras i ett pilotförsök. För en timslång session är en låg typisk felfrekvens bara en del av överlämningen: rättelser som koncentreras kring ett viktigt namn eller beslut kan vara viktigare än sin andel av texten. Granska dessa kritiska avsnitt tillsammans med källan i stället för att förlita dig på ett enda sammanfattande mått.
Sider: det mer direkta alternativet för inspelning och import
Sider Recorder & Transcriber är en mer direkt jämförelse för en ny inspelning än en anslutning som bara hanterar arkiv. Dess officiella ChatGPT-listning beskriver röstinspelning eller filimport, följt av tidsstämplad text och en strukturerad sammanfattning, bland annat i en sida-vid-sida-vy. För en lektionsinspelning eller en talad anteckning kan detta vara en smidig utgångspunkt. [6]
Den praktiska skillnaden är nästa leverans. En läsare som främst söker inspelning och sammanfattning bör undersöka Sider vid sidan av WhisperTranscribe.ai. Den som förbereder tidsatta undertexter bör uttryckligen efterfråga resultat på undertextpostnivå och ett verifierat leveransformat. Det granskade Sider-materialet styrker inte dessa undertext- eller exportuppgifter. Funktioner i det separata Sider-webbläsartillägget ska inte fylla luckan i en ChatGPT-jämförelse.
Transkriptor: starkast när transkriptionen redan finns
Transkriptors guide och offentliga listning beskriver sökning bland lagrade inspelningar, läsning av talarmärkt text och tidsstämplar, hämtning av sammanfattningar och skapande av PDF-nedladdningslänkar. Guiden kallar uttryckligen ChatGPT-integrationen skrivskyddad och hänvisar skapande av nya transkriptioner till leverantörens webb- eller mobilapp. Det gör den till en annan utgångspunkt än WhisperTranscribe.ai:s uppladdningswidget. [7][10]
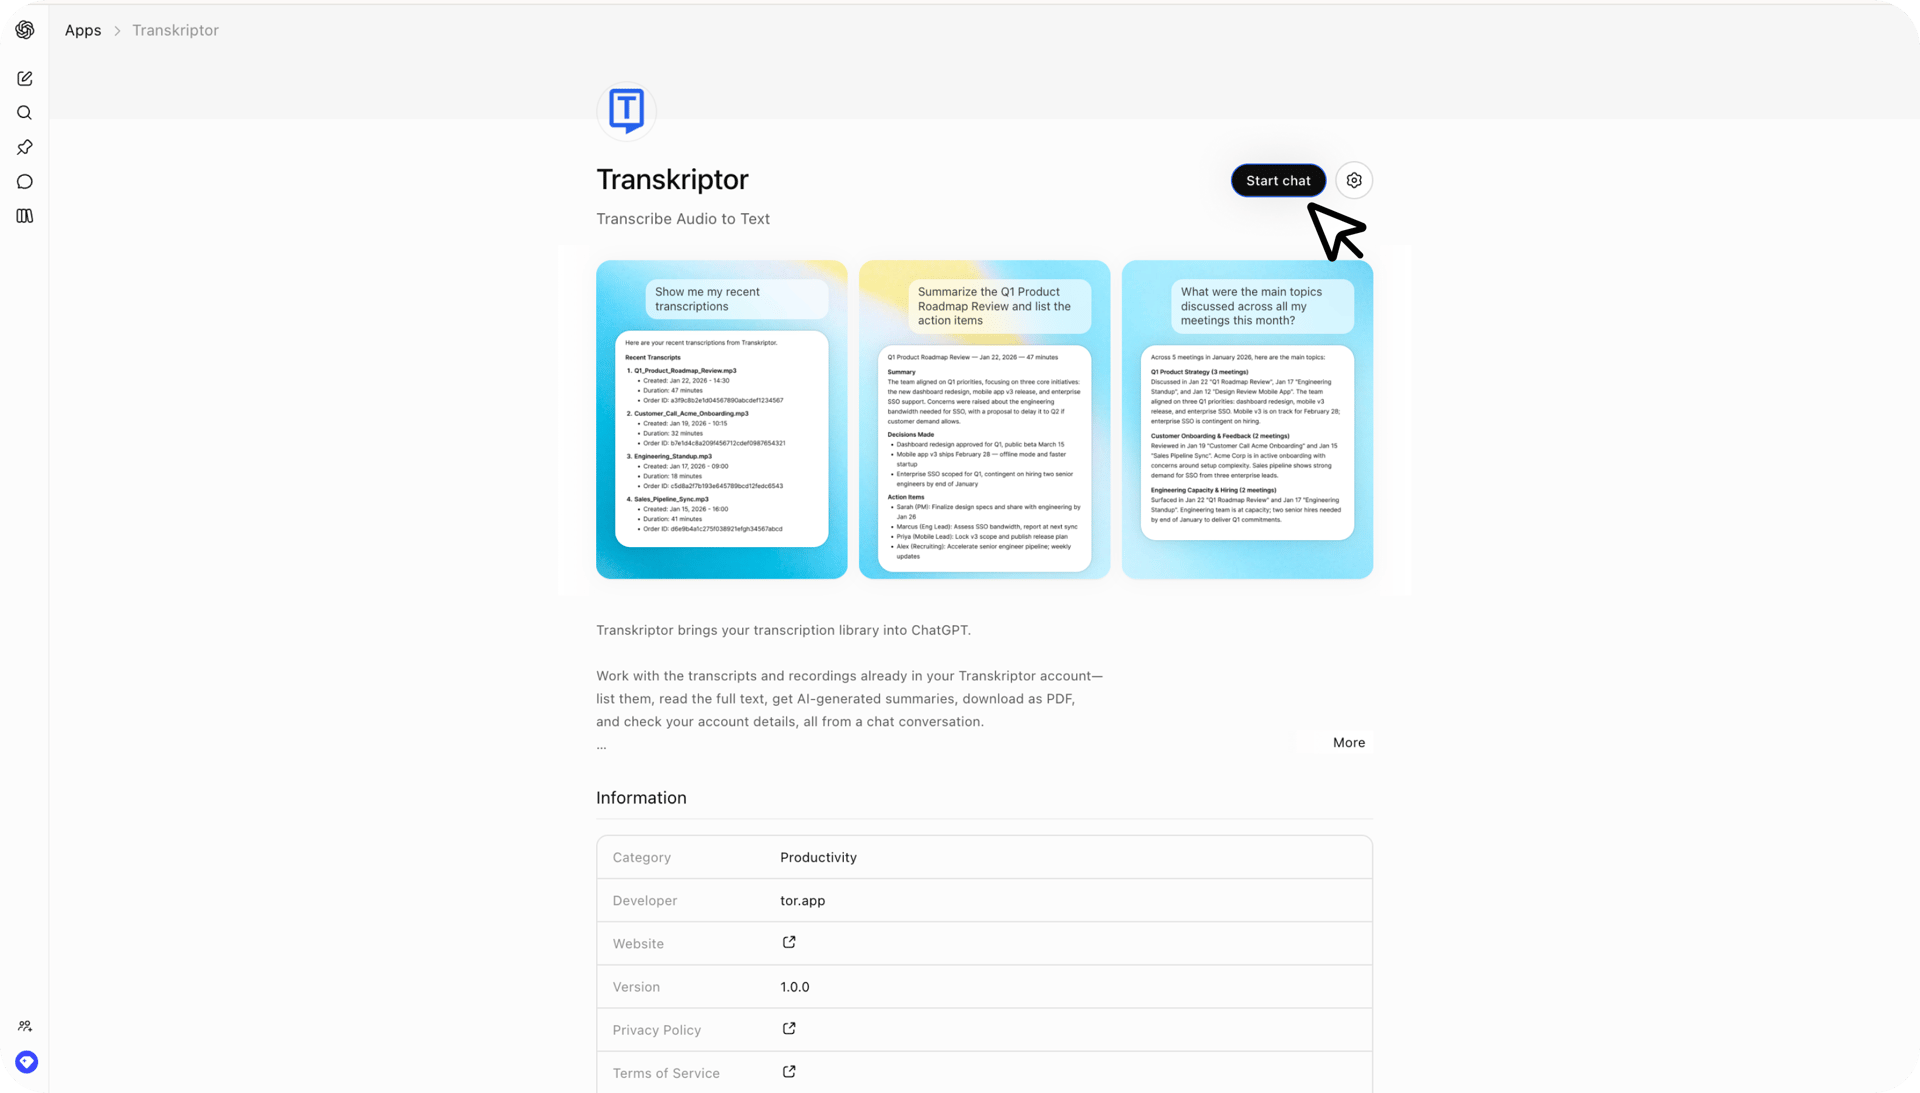
För den som redan lagrar intervjuer i Transkriptor är hämtning av originalet i allmänhet ett tydligare arbetsflöde än att ladda upp ytterligare en kopia någon annanstans bara för att skapa en sammanfattning. PDF är en konkret överlämningsfördel som dokumenteras för anslutningen, även om en tillfällig nedladdningslänk bör kontrolleras och förnyas när den löper ut. En användbar PDF-åtgärd är inget belägg för bättre igenkänningskvalitet.
Otter: passar bättre för frågor över tidigare möten
Otters hjälpsida, uppdaterad den 15 oktober 2026, dokumenterar verktyg för sökning, hämtning och användarinformation i ChatGPT. Den omfattar inspelade möten och möten som delats med den anslutna användaren och anger att den första anslutningen ska göras på webben före användning från skrivbordsappen. Den aktuella offentliga tilläggslistningen ger ytterligare sammanhang om arkivfrågor och hämtning av transkriptioner. [8][11]
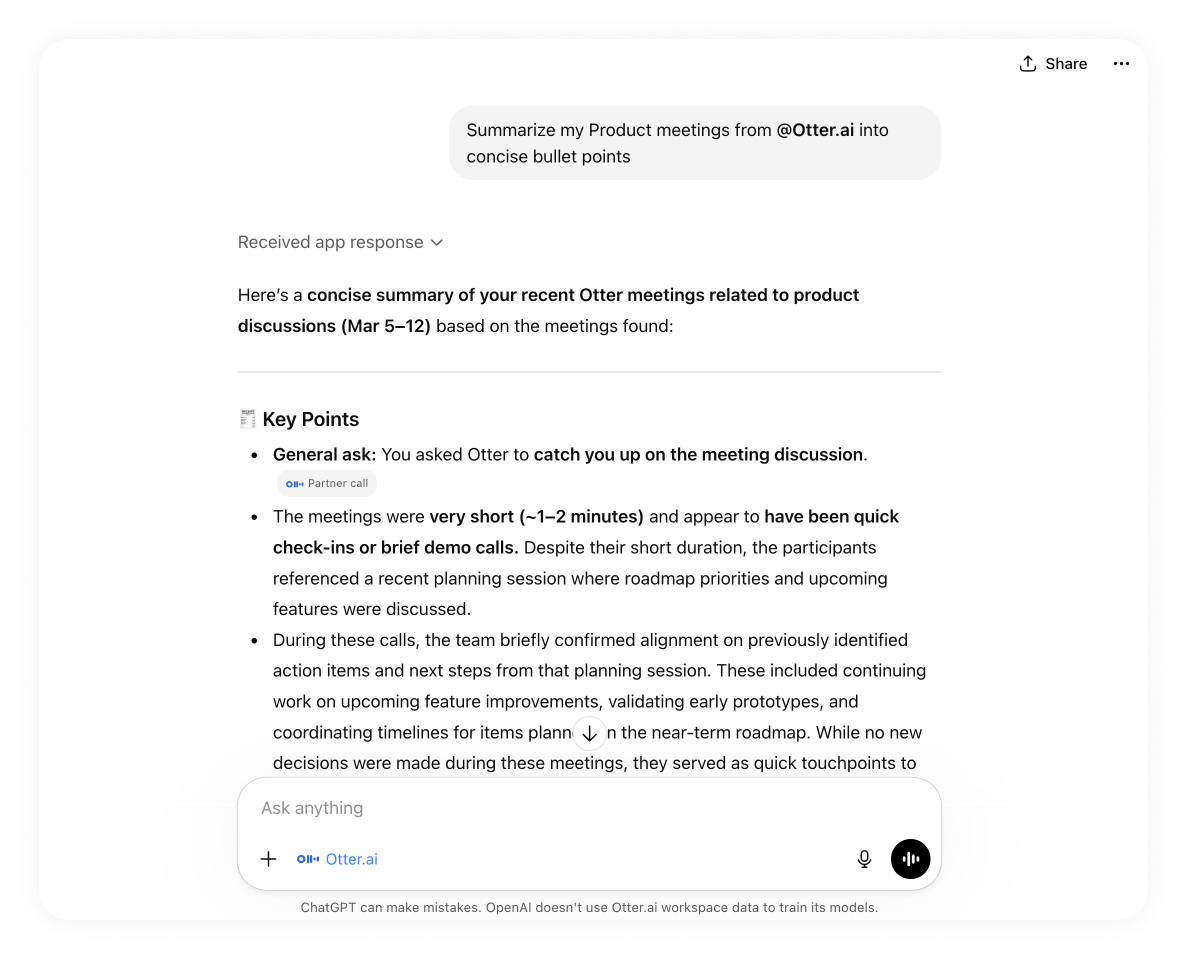
Det värdefulla scenariot är ofta en fråga som ”Vilka möten nämnde förnyelserisken?” snarare än ”Var kan jag ladda upp denna fil?”. Be Otter identifiera relevanta möten och hämta sedan avsnitten innan du skriver ett svar. Behåll mötesdatum och källänkar bredvid syntesen. Det gör resonemang över flera möten lättare att granska utan att alla hämtade samtal behandlas som en enda sammanhängande inspelning.
Fireflies: mötessammanhang med anslutningsspecifika åtgärder
Fireflies aktuella guide beskriver hur befintliga transkriptioner, sammanfattningar, beslut och åtgärdspunkter används som sammanhang i AI-verktyg som stöds. För team som redan underhåller arkivet kan hämtning av relevant material vara mer användbart än att flytta inspelningar till en ny tjänst. Den exakta anslutningen spelar fortfarande roll: den bredare MCP-katalogen innehåller hanterings- och skrivåtgärder utöver hämtning, med roll- och tillgänglighetsbegränsningar. Den ska varken kallas generellt skrivskyddad eller antas erbjuda alla katalogåtgärder i varje ChatGPT-tilläggskonto. [9][12]
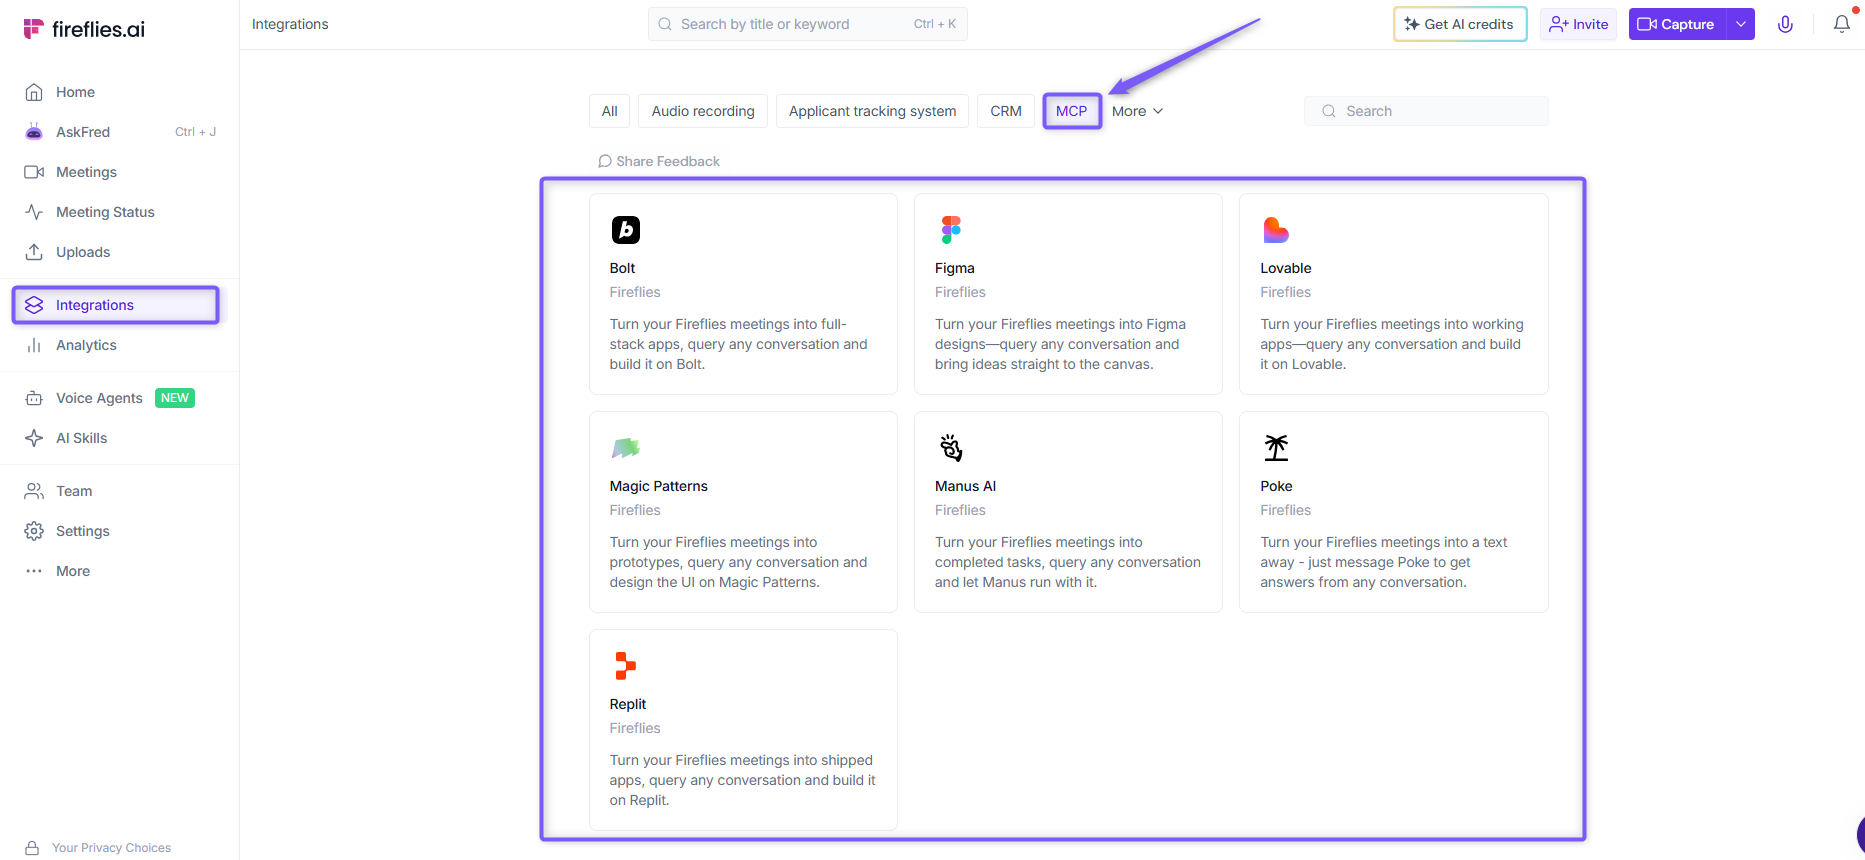
För en transkriptionsbaserad artikel eller teamsammanställning ska du välja relevanta möten och granska de hämtade avsnitten innan du drar slutsatser om en kund eller ett projekt. Om du behöver en hanteringsåtgärd, som att ändra åtkomst eller skapa ett klipp, kontrollera vilken åtgärd som faktiskt exponeras för anslutningen. Ett allmänt produktmeddelande kan inte styrka åtgärden för alla värdmiljöer eller konton.
WhisperTranscribe.ai mot varje alternativ: vad ändrar beslutet?
WhisperTranscribe.ai jämfört med Sider: att fånga en tanke och leverera undertexter är olika uppgifter
Siders dokumenterade inspelare gör tjänsten relevant när källan ännu inte finns som fil. En student som dikterar en fråga efter lektionen eller en forskare som spelar in en kort observation kan värdesätta att börja med röstinspelning. Listningen beskriver inspelning eller import av medier, tidsstämplad transkribering och en transkriptions-/sammanfattningsvy. WhisperTranscribe.ai:s granskade väg ger tydligare dokumenterad uppmärksamhet åt ett separat begärt undertextjobb och de strukturerade undertextdata som returneras efteråt. Skillnaden gäller nästa åtgärd, inte visad transkriptionskvalitet. [6][3]
För en timslång föreläsning som redan sparats som inspelning kanske en mikrofoningång tillför lite till beslutet; den mer användbara frågan är att hitta en viss definition i det längre materialet. Jämför i stället hur resultatet stöder ditt sätt att studera: att hitta lärarens definition, skilja exempel från slutsatser och kontrollera källan bakom en genererad sammanfattning. En transkription bredvid en sammanfattning kan stödja uppgiften, men en synligt strukturerad sammanfattning ska inte få högre noggrannhetsbetyg bara för att den är lättare att skumma. Läsbarhet och igenkänningsfel kräver olika underlag.
WhisperTranscribe.ai är den tydligare dokumenterade kandidaten här när nästa leverans är tidsatta undertexter. Rekommendationen bygger på dess uttryckliga undertextväg och undertextfält, inte på ett fynd att Sider inte kan producera dem. Sider skulle bli mer konkurrenskraftigt för uppgiften om den aktuella anslutningen visade nödvändiga undertextdata och en användbar export. Omvänt förtjänar Siders dokumenterade inspelningsingång direkt övervägande för spontana talade anteckningar följda av en kort sammanfattning, utan krav på undertextflöde.
WhisperTranscribe.ai jämfört med Transkriptor: skapa nytt material eller hämta den befintliga dokumentationen
En timslång intervju som redan transkriberats i Transkriptor innebär ett hämtningsproblem innan den innebär ett transkriberingsproblem, särskilt när en redaktör behöver ett avsnitt ur ett längre samtal. Dess dokumenterade filter för namn, datum och längd kan hjälpa till att identifiera rätt källa, följt av fullständig text med talaretiketter och tidsstämplar. Den ordningen är användbar när flera intervjuer har liknande titlar. Att ladda upp ljudet igen till WhisperTranscribe.ai skulle skapa en annan bearbetningsväg; det skulle inte automatiskt bevara identiteten eller den redaktionella statusen hos den ursprungliga kontoposten. [7]
Den dokumenterade PDF-åtgärden ändrar också överlämningen. En granskare som begär ett dokument att läsa kan få en konkret nedladdning i stället för enbart en konversationssammanfattning. Kontrollera att den innehåller det material som krävs och spara sedan den nedladdade filen om granskningen måste fortsätta efter att den tillfälliga länken löpt ut. En förnybar länk och ett permanent arkiverat dokument är olika lösningar. Varken förekomsten av PDF eller en sammanfattnings layout visar om de bakomliggande orden transkriberats mer noggrant.
Välj Transkriptor-anslutningen när den auktoritativa transkriptionen redan finns där och arbetet gäller hämtning, jämförelse eller PDF-överlämning. Dess uttryckligen skrivskyddade omfattning ger också en tydlig gräns för arbetsflödet: nya transkriptioner skapas i leverantörens webb- eller mobilapp. WhisperTranscribe.ai blir den mer direkta kandidaten när källan är en ny lokal inspelning och den önskade vägen börjar med en uppladdningskomponent i chatten eller en undertextförfrågan. Rekommendationen ändras med källans plats och önskat resultat. [7][10][3]
WhisperTranscribe.ai jämfört med Otter: detaljer i en inspelning eller en fråga över arkivet
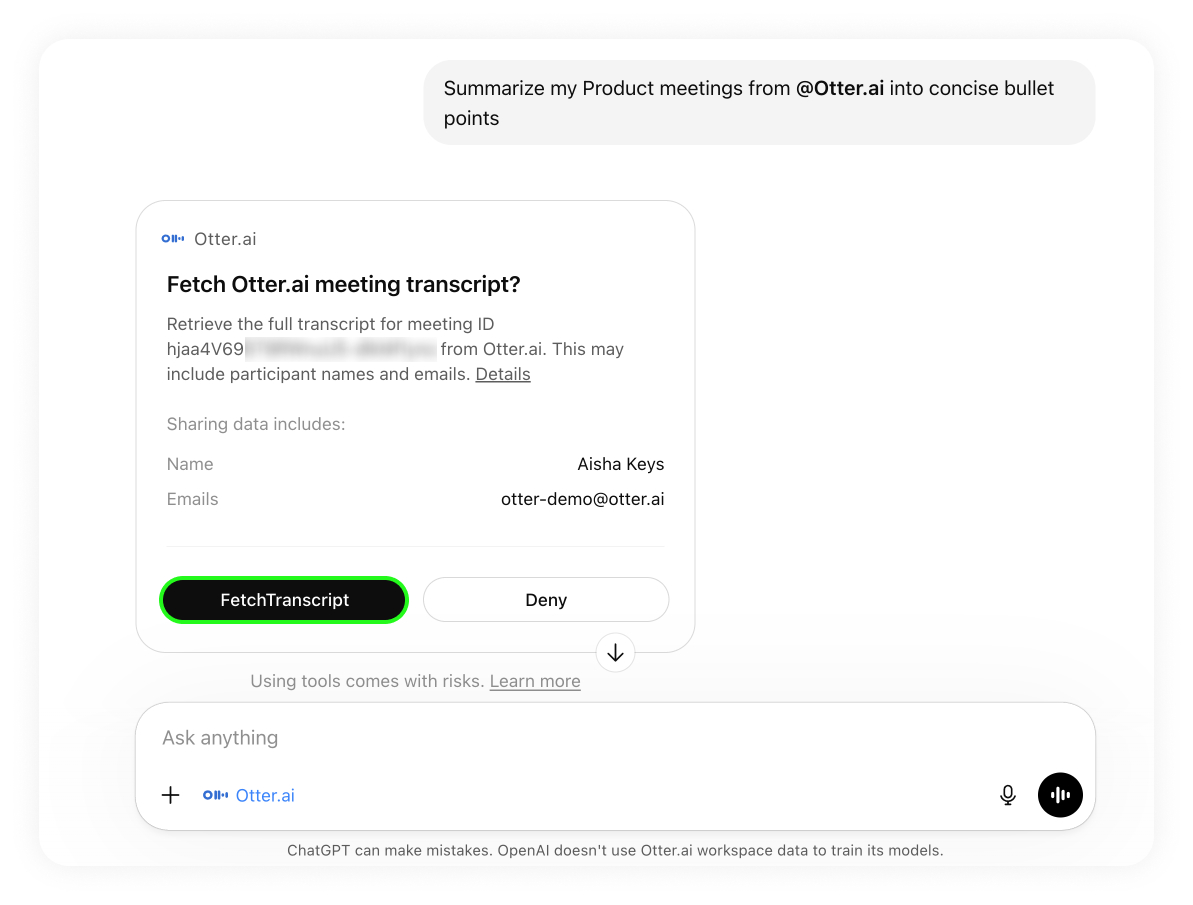
Tänk dig en projektledare som frågar när ett leveransdatum ändrades. Svaret kan bero på tre möten: ett första förslag, en senare invändning och en slutlig överenskommelse. Otters dokumenterade sök- och hämtningsverktyg ger en lämplig väg till dessa befintliga samtal. En enda nyuppladdad inspelning i WhisperTranscribe.ai kan inte fastställa vad som hände i möten som aldrig tillhandahållits. Detta är en täckningsfördel för ett befintligt arkiv, inget bevis på att Otters transkribering är mer noggrann. [8]
Den praktiska ordningen är att identifiera tänkbara möten, hämta relevanta avsnitt och bygga en daterad redogörelse för ändringen. Behåll meningsskiljaktigheter synliga i stället för att komprimera varje omnämnande till ett enda svar. Otters hjälpguide beskriver åtkomst till inspelade möten och möten som delats med den anslutna användaren; ett uteblivet sökresultat styrker därför inte att ingen kollega någonsin diskuterat frågan. Det anslutna kontot och det tillgängliga källmaterialet avgör hur långt slutsatsen kan sträcka sig.
WhisperTranscribe.ai förblir en rimlig kandidat för närarbete med en ny intervju eller en undertextad video vars källa inte finns i Otter. Otter blir att föredra när flera redan lagrade möten ger nödvändigt sammanhang, särskilt om källänkar måste leda kollegor tillbaka till originalsamtalen. Innan du väljer mellan dem, avgör om uppgiften är ”förklara denna inspelning” eller ”rekonstruera detta beslut över tid”. Förfrågningarna kräver olika källtäckning, även när båda till slut ger en kort sammanfattning. [3][8][11]
WhisperTranscribe.ai jämfört med Fireflies: en medieuppgift eller arbete i ett mötessystem
För ett kundansvarigt team som förbereder en kundgenomgång kan det användbara materialet redan sträcka sig över flera Fireflies-samtal. Dess dokumenterade anslutning till mötestranskriptioner, sammanfattningar och åtgärdspunkter kan stödja sammanställningen av detta sammanhang utan att varje samtal behandlas som en orelaterad ny uppladdning. WhisperTranscribe.ai:s filbaserade väg är lättare att avgränsa kring en tillhandahållen inspelning och dess resulterande text eller undertextposter. Ingen av utgångspunkterna besvarar ensam om den slutliga genomgången rättvist återger varje deltagares ståndpunkt. [9][3]
Fireflies kräver också att man skiljer mellan att läsa ett möte och att ändra den omgivande arbetsytan. Den allmänna katalogen innehåller åtgärder som att byta namn på möten, ändra delningsåtkomst och skapa klipp, med behörighetsbegränsningar. Det är väsentligt andra förfrågningar än att hämta en transkription. Kontrollera vad den specifika ChatGPT-anslutningen faktiskt exponerar innan du utformar ett arbetsflöde kring dem. Den bredare katalogen styrker den större produktens funktioner, men garanterar inte att varje anslutet konto erbjuder varje angiven åtgärd. [12]
Föredra Fireflies när det befintliga teamarkivet ger sammanhanget och nödvändiga åtgärder är tillgängliga i vald anslutning. Föredra WhisperTranscribe.ai bland kandidaterna när uppgiften börjar utanför arkivet och slutar med granskad text eller tidsatta undertexter. Rekommendationen skulle ändras om sammanställningen krävde otillgängliga historiska samtal eller om arbetsflödet var beroende av en hanteringsåtgärd som saknas i anslutningen. Identifiera beroendet innan fler medier bearbetas; annars kan transkriberingen slutföras medan det egentliga arbetet fortfarande är blockerat.
Fyra entimmesflöden: från en lång inspelning till en användbar leverans
Dessa redaktionella planeringsexempel börjar vart och ett med en inspelning på 60 minuter. De beskriver föreslaget arbete, inga nyligen bearbetade filer eller tillägg till det historiska mäturvalet. Den längre längden ändrar uppdraget: en granskare måste hitta ämnesgränser, bevara sammanhang över åtskilda avsnitt och hålla slutleveransen kopplad till rätt version. Kontrollera det aktuella kontots fil- och längdvillkor innan någon väg används. De föreslagna förfrågningarna nedan anger vilket arbete som ska begäras; de är inga observerade tilläggsresultat.
1. Projektgenomgång med flera ämnen: bevara hur ett beslut ändrades
Tänk dig en timslång projektgenomgång som växlar mellan leveransdatum, budgetbegränsningar och en eskalerad kundfråga. Uppdraget är att rekonstruera det slutliga ställningstagandet för varje ämne, inklusive tidigare förslag som senare drogs tillbaka. För en ny fil som behöver både granskad text och senare undertextarbete är WhisperTranscribe.ai en stark utgångspunkt eftersom den granskade beskrivningen uttryckligen täcker båda vägarna. Hämta det färdiga resultatet innan du bygger beslutskartan. Sider beskriver också inspelning eller import av medier. Om genomgången redan tillhör ett Otter- eller Fireflies-arkiv, hämta det befintliga mötet och uttryckligen relevanta tidigare poster i stället för att införa en oförklarad andra transkription. Håll varje källa identifierbar. [3][6][8][9]
Bygg först en agendakarta med tillgängliga källpositioner. Spåra sedan varje viktigt beslut från första omnämnandet till sista relevanta revideringen, även om diskussionen återkommer till det långt senare. Markera om det sista avsnittet bekräftar, ändrar eller lämnar förslaget öppet. En budgetsiffra som godkänns i början kan bero på en minskad omfattning som diskuteras mot slutet; om bara den tidigare meningen tas ut försvinner villkoret. Kontrollera de länkade avsnitten mot inspelningen, särskilt namn, mängder och negativa eller villkorliga formuleringar. Bevara oenighet där mötet inte löser den.
Leverera ett ämnesregister med slutlig ståndpunkt, ersatta förslag, beroenden och stödjande avsnitt, följt av en separat åtgärdslista. Ta bara med ansvarig och tidsfrist när de anges och identifiera vilket beslut varje åtgärd genomför. En frånvarande teammedlem ska kunna följa resonemanget utan att läsa hela timmen, men ändå återvända till diskussionen när ett villkor ifrågasätts. För arkivbaserat material ska mötesdatum behållas så att slutsatsen från en tidigare genomgång inte ersätter den aktuella utan förklaring.
Kartlägg ämnena i denna timslånga genomgång med tillgängliga källpositioner. Spåra varje större beslut från första förslag till sist angivna ståndpunkt, inklusive revideringar, beroenden och olösta meningsskiljaktigheter. Hänvisa till stödjande avsnitt. Lista åtgärder separat och ta bara med ansvariga eller tidsfrister när de är uttryckliga. Dra inte slutsatsen att ett obesvarat förslag innebär enighet.
2. Redigering av en lång intervju: bygg en sekvens utan att ändra svaren
En timslång intervju kan omfatta en karriärhistoria, en teknisk förklaring och en senare rättelse av ett tidigare svar. En redaktör som förbereder en kortare artikel behöver ett avsnittsindex och tänkbara citat före en polerad berättelse. För en ny tillhandahållen inspelning erbjuder WhisperTranscribe.ai en praktisk utgångspunkt från fil till text: hämta först den färdiga texten och använd den sedan för att utveckla avsnittsindex och redigeringsplan. Det håller källgranskning och redaktionell omstrukturering i en definierad följd. Om den auktoritativa transkriptionen redan finns i Transkriptor, använd dess dokumenterade hämtning av talarmärkt, tidsstämplad text; PDF-åtgärden kan stödja en dokumentbaserad granskning. Bevara källans identitet i stället för att räkna en ny transkription av samma intervju som ännu en intervju. [3][7][10]
Indexera avsnitt efter ämne och bevara den ursprungliga följden av frågor och svar. När du föreslår en ny artikelordning, skilj en flytt av ett intakt avsnitt från en omskrivning av formuleringen. Kontrollera om en senare reservation begränsar ett tidigare säkert påstående och håll båda tillgängliga för redaktören. Ett citat sammansatt av meningar som inte följer på varandra kan dölja frågan eller förvandla tvekan till säkerhet. Lyssna på varje citat som väljs för publicering, inte bara inledningen till varje ämne, och dokumentera redaktionella ändringar separat från igenkänningsrättelser.
Leveransen är en redigeringskarta: föreslagen avsnittsordning, källavsnitt, tänkbara citat, senare reservationer och verifieringsstatus. Håll arbetstranskriptionen och den föreslagna artikeln åtskilda. Märk varje citat som verifierat, i väntan på lyssning eller olämpligt för direktcitat. Om Otter eller Fireflies bidrar med relaterade arkiverade intervjuer ska talare och inspelning identifieras för varje tillägg. Relaterat material kan ge sammanhang, men får inte läggas i den aktuella intervjupersonens mun eller behandlas som belägg för att den aktuella intervjun innehöll orden.
Skapa en redigeringskarta för denna timslånga intervju. Föreslå en artikelordning och länka varje avsnitt till intakta källavsnitt. Bevara frågorna bakom tänkbara citat och identifiera senare rättelser eller reservationer. Skilj direktcitat från parafras. Markera formuleringar som kräver ljudverifiering; kombinera inte svar som inte följer på varandra till ett enda citat.
3. Kapitelindelning av utbildning: behåll förkunskapskrav och frågor som ändrade förklaringen
För en timslång utbildningsinspelning kan målet vara en återanvändbar kapitelguide snarare än en allmän sammanfattning. Sessionen kan växla mellan förklaring, demonstration och frågor, så en prydlig lista med ämnesnamn räcker inte. WhisperTranscribe.ai är ett användbart förstahandsval när indata är en ny inspelning och den planerade leveransen kombinerar granskad text med undertexter: de dokumenterade resultat- och undertextvägarna ger material för dessa separata steg. Kapitelguiden är sedan redaktionellt arbete baserat på texten. Siders inspelnings-/importväg kan vara relevant när inspelning fortfarande ingår i uppdraget. Om sessionen redan har en Transkriptor-transkription, hämta den befintliga posten. Välj ingång efter var materialet finns och bedöm sedan kapitelindelning som redaktionellt arbete, snarare än en visad automatisk funktion i varje anslutning. [3][6][7]
Föreslå gränser där undervisningssyftet ändras och använd bara källtider som faktiskt finns. Behåll förkunskapskrav med proceduren som beror på dem och koppla ett senare svar till den tidigare förklaring det rättar. En demonstration kan bero på detaljer som bara syns på skärmen; en ljudtranskription kan inte styrka dem. Märk var en presentationsbild, skärminspelning eller tillåtet utdelningsmaterial behövs. Granska termer och enheter mot det tillhandahållna materialet och märk härledda kapitelrubriker som redaktionella etiketter, inte lärarens exakta ord.
Leverera en kapitelguide med syfte, förkunskapskrav, källintervall, demonstrationsberoenden och länkade frågor för varje avsnitt. Lägg bara till en kort termlista där en term behöver granskas, i stället för att generera en ordlista utan underlag. För återanvändning i team ska en versionsanteckning förklara vilken inspelning och vilket medföljande material guiden omfattar. En senare rättelse kan då uppdatera det berörda kapitlet utan att hela utbildningspaketet ersätts eller motsägande sammanfattningar fortsätter cirkulera.
Föreslå kapitel för denna timslånga utbildning med tillgängliga källtider. Identifiera syfte, förkunskapskrav, demonstrationsberoenden och relevanta frågor för varje kapitel. Koppla senare förtydliganden till den tidigare förklaring de preciserar. Markera information som kräver presentationsbilder eller skärmbilder. Märk föreslagna kapitelrubriker som redaktionella etiketter och hitta inte på tidsgränser.
4. Undertextleverans för hela längden: kontrollera revideringar genom hela videon
För en timslång inspelad panel eller instruktionsvideo behöver undertextredaktören en komplett tidsatt sekvens knuten till en specifik videoversion. WhisperTranscribe.ai är en stark startkandidat för uppgiften eftersom den granskade beskrivningen uttryckligen omfattar en särskild undertextväg och strukturerade undertextfält. Dessa dokumenterade reglage passar den begärda leveransen mer direkt än en anslutning som bara beskrivs för arkivsökning. Sider kan vara relevant för den första transkriptionen och sammanfattningen, medan Otter eller Fireflies kan hjälpa till att hämta sammanhang från lagrade möten; de granskade källorna styrker inte motsvarande undertextleverans genom dessa anslutningar. Bekräfta önskad resultatfil och aktuella kontovillkor innan hela inspelningen bearbetas. [3][6][8][9]
Behåll ett rättelseregister med undertextidentifierare som nycklar och med originaltext, föreslagen ändring, orsak och markering för ändrad timing. Granska terminologin konsekvent genom hela sekvensen i stället för att bara rätta första förekomsten. Skilj texträttelser från ändringar som orsakas av en ny videoklippning: en infogad introduktion kan förskjuta senare undertextposter även när formuleringarna fortfarande stämmer. Bevara undertexternas basversion, granska markerade avsnitt vid uppspelning och kontrollera att radbrytningarna förblir läsbara i målredigeraren. Enbart visning i chatten kan inte visa lyckad undertextimport.
Leverera den faktiska undertextfilen med motsvarande videoversion, ett ändringsregister och olösta frågor. Verifiera början, övergångar mellan större avsnitt, representativa avsnitt nära slutet och varje markerad undertextpost. Om mottagaren senare begär en kortare klippning ska den behandlas som en separat tidsleverans och granskas mot den klippningen. Den ursprungliga timslånga sekvensen förblir basversionen; varken en kapitelöversikt eller ett förkortat reklammanus ersätter dess tidsatta undertexter.
Skapa ett ändringsregister för denna fullängdssekvens av undertexter. Behåll undertextidentifierare och befintliga tider i varje förslag. Visa originaltext, föreslagen rättelse, orsak och om uppspelning eller ändrad timing krävs. Kontrollera återkommande terminologi konsekvent. Identifiera motsvarande videoversion och håll redigeringar för kortare klippningar åtskilda från fullängdsbasversionen.
Jämför leveransen, inte bara transkriptionen
Det timslånga uppdraget har två huvudsakliga resultat: en sammanställning med källhänvisningar och ett undertextoriginal. De tjänar olika läsare och kräver olika kontroller. Använd tabellen nedan för att avgöra vad som måste följa med i varje överlämning; detta är praktiska acceptanskriterier, inte uppmätta slutförandegrader.
| Leverans | Vad som ska kontrolleras | Användbar startväg |
|---|---|---|
| Mötesanteckningar | Beslut åtskilda från förslag; ansvariga och datum stödda av källavsnitt | WhisperTranscribe.ai för nya filer; verktyg för befintliga bibliotek för lagrade möten |
| Intervjucitat | Exakta ord, rätt talare och återfinnbara avsnittstider | Färdig transkription med ljudgranskning |
| Tidsatta undertexter | Undertextföljd, start-/sluttider, läsbar text och lyckad import i målredigeraren | WhisperTranscribe.ai:s undertextväg, följd av exportkontroller |
| PDF-överlämning | Fullständig text och en fungerande nedladdningsfil | Transkriptor dokumenterar en PDF-åtgärd för befintliga transkriptioner |
| Sammanställning över flera möten | Mötesdatum, källänkar och stöd för varje kombinerad slutsats | Otter / Fireflies, eller arkivet där materialet redan finns |
För WhisperTranscribe.ai ska du definiera undertext- eller dokumentfilen innan hela uppdraget börjar. Strukturerade undertextdata hjälper till att bevara spåret, men en mottagande redigerare behöver fortfarande en kompatibel fil. Transkriptors dokumenterade PDF-länk är ett användbart alternativ när en befintlig transkription ska överlämnas som dokument. Kontrollera den faktiska vägen som krävs för varje fil i stället för att anta att varje webbplatsexport är en åtgärd i chatten. [3][7]
Så bedömer du det färdiga arbetet utöver en välformulerad transkription
En användbar utvärdering skiljer fyra resultat åt: orden som fångats från inspelningen, sammanfattningens trohet, talartilldelningen och timingen som gör avsnitt återfinnbara samt filen eller länken som levereras till en annan person. Resultaten kan skilja sig åt. En läsbar transkription kan tilldela en kritisk mening till fel talare; en trogen sammanfattning kan levereras utan en användbar undertextfil. WhisperTranscribe.ai:s dokumenterade transkription, valfria talar- och tidsfält, sammanfattning och undertextposter ger olika material för att kontrollera dessa resultat. Bedöm vart och ett mot det avsedda uppdraget i stället för att slå samman dem till ett enda kvalitetsintryck. [3]
Kontrollera formuleringar som får följder innan du putsar stilen
För en intervju ska du bevara vad personen faktiskt sa innan du tar bort upprepningar eller förbättrar interpunktionen. För ett möte ska du granska namn, mängder, negationer och villkorliga formuleringar i avsnitt som stöder beslut. En redaktör ska kunna skilja en igenkänningsrättelse från en stilistisk omskrivning. Behåll det orörda resultatet tillsammans med den granskade versionen och dokumentera rättelser med källavsnitt. Den föreslagna metoden gör meningsskiljaktigheter möjliga att lösa: en kollega kan återvända till inspelningen i stället för att bedöma om den redigerade meningen bara låter rimlig.
Granska sammanfattningen som en separat redaktionell produkt
Kontrollera påstående för påstående: identifiera stödjande avsnitt, avgör om det uttrycker ett faktum, förslag eller osäkerhet och bekräfta att sammanfattningen bevarar den statusen. Ett föreslaget lanseringsdatum ska förbli ett förslag om diskussionen inte bekräftar en överenskommelse. En åtgärdspunkt behöver stöd för själva uppgiften; ansvarig och tidsfrist behöver eget stöd. Behåll frågan öppen där källan inte ger något entydigt svar. Detta är en redaktionell granskningsmetod, inget påstående om att något jämfört tillägg gjort dessa misstag i en observerad körning.
Verifiera talartilldelning och timing där de påverkar användningen
Talaretiketter är bara användbara när de förblir konsekventa i avsnitt du avser att citera eller tilldela. Välj exempel på talarbyten och överlappande diskussion som är relevanta för leveransen och kontrollera dem mot inspelningen. Behåll en olöst etikett i stället för att gissa personens namn. För tidsstämplar ska du verifiera att en angiven position faktiskt leder granskaren till rätt avsnitt. Valfria meningstider och talarindelade stycken i de dokumenterade resultaten stöder granskningen när de returneras; deras närvaro visar inte att varje etikett eller tid har validerats. [3]
Behandla undertextleveransen som en extra kontroll
Granska de redigerade undertextposterna i ordning och jämför representativa avsnitt med videon. Öppna sedan den faktiska exportfilen på avsedd destination och kontrollera text, undertextordning, synliga tider och eventuell talarinformation som uppdraget kräver. En kopierbar lista med undertextposter och en framgångsrikt importerad undertextfil är olika leveranser. Om översättning ingår ska den översatta betydelsen kontrolleras separat från bevarandet av ursprungliga undertextidentifierare och tidsgränser. Detta är föreslagna acceptanskontroller för undertextfälten i appspecifikationen. [3]
Använd de historiska WER-värdena på deras faktiska nivå
Den historiska dokumentationen rapporterar median-WER per fil på 5.26% för batch och 6.84% för strömning över 2,703 filer och 81.69 timmar. En median sammanfattar mitten av resultaten på filnivå; den visar inte fördelningen, de sämsta filerna eller typerna av fel som behövde rättas. Utan resultat per fil och bedömningsdetaljer kan värdena inte säga en köpare hur en viss intervju kommer att se ut. De kan inte heller fastställa kvaliteten på sammanfattningar, talartilldelning, undertexter eller aktuell tilläggsleverans. Denna historik förblir ett enda underlag; den är ingen ny observation av det aktuella ChatGPT-flödet. [5]
Ett rättvist pilotförsök börjar med en fast fil och ett fast uppdrag
För en framtida jämförelse ska du behålla samma källfil och referensversion, dokumentera längd och språk och definiera det begärda resultatet innan du börjar. Logga konto, abonnemang, anslutningsväg och valda inställningar för varje produkt. Ett pilotförsök med en ny fil kan jämföra WhisperTranscribe.ai med Siders dokumenterade importväg. Ett pilotförsök för arkivhämtning behöver material som redan finns i de relevanta kontona; förberedelserna av arkivet ska dokumenteras separat. Annars blandar jämförelsen transkribering, inläsning och sökning till ett enda oförklarat resultat. [3][6][7][8][9]
Välj tidsmätningsgränser innan ett resultat observeras. Dokumentera uppladdningsstart, accepterad uppladdning, tillgängligt färdigt resultat och lyckad export som separata händelser där de kan observeras. Notera nätverksförhållanden, filstorlek, misslyckade försök och om en körning återanvände ett befintligt jobb. Bevara jobbidentifieraren privat tillsammans med resultatet så att en eventuell skärmbild kan kopplas till rätt körning. Rapportera upprepade observationer var för sig innan de sammanfattas. Hämtning från ett redan färdigt jobb ska inte framställas som tiden som krävs för att transkribera inspelningen.
Dokumentera redigeringsarbete mot den begärda leveransen
För en enkel arbetslogg med granskat avsnitt, problemtyp, rättelse, granskare och aktiv redigeringstid. Skilj transkriptionsrättelse, talarrättelse, sammanfattningsrevidering och exportreparation åt. Dokumentera lyssningstid och aktiv redigering konsekvent mellan kandidaterna i stället för att utan förklaring inkludera dem för ett verktyg och utesluta dem för ett annat. Kom överens om acceptansvillkor med mottagaren före pilotförsöket: godkända citat, underbyggda beslut, fullständig text eller en fil som öppnas i målredigeraren. Det ger en granskningsbar bedömning av användbart arbete utan att hitta på en universell feltröskel.
Slutleveransen ska identifiera inspelningen, den granskade versionen, källavsnitten bakom viktiga slutsatser och den faktiskt levererade filen eller länken. Håll olösta frågor synliga och bevara en väg tillbaka till källan. En tydlig PDF, en sammanställning med källhänvisningar och tidsatta undertexter kan tjäna olika mottagare; det bästa valet för ett uppdrag är anslutningen som slutför den nödvändiga överlämningen med granskningsbart underlag.
Åtkomst, kostnad och informationsgränser
Börja med den ChatGPT-åtkomst kontot kräver och leverantörens kvot för det faktiska jobbet. Kontrollera sedan filgränser, åtkomst till hela transkriptionen och leveransformatet du behöver. En kostnadsfri tilläggslistning är inget bevis på obegränsad transkribering, och ett webbplatsabonnemang är inget bevis på att varje åtgärd finns i ChatGPT. Denna recension hittar inte på ett enhetligt tilläggspris eller överför webbplatsgränser till en oprövad widget. [1]
För ett återkommande entimmesuppdrag ska du jämföra arbetet som krävs för att nå båda leveranserna. Räkna medieförberedelse, källgranskning, revidering av sammanställning och undertextkontroll separat. WhisperTranscribe.ai:s fördel i uppdraget är möjligheten att börja transkriptions- och undertextvägarna från samma valda källa; eventuella extra export- eller webbplatssteg hör fortfarande till överlämningsbedömningen.
Granska kontot och den begärda omfattningen vid anslutning, särskilt för delade mötesbibliotek. OpenAI:s inställningar för appbehörigheter avgör när godkännande begärs; de ger inte en leverantör åtkomst som aldrig beviljats. Att en app är tillgänglig fastställer inte heller villkor för lagringstid, träningsanvändning eller regelefterlevnad. Kontrollera leverantörens aktuella villkor för materialet du avser att bearbeta. [1]
När arbetsflödet stannar: lös rätt problem
Appen är ansluten, men uppladdaren syns inte
Kontrollera vald produkt och begärd åtgärd innan du byter tjänst. En begäran om arkivsökning och en begäran om transkribering av en ny fil kan ge olika upplevelser. För WhisperTranscribe.ai, be om att öppna transkriberingsgränssnittet och leta sedan efter medieväljaren inne i komponenten. Om gränssnittet som stöds fortfarande är otillgängligt, använd den dokumenterade tillhörande arbetsytan och dokumentera att filen bearbetades via webbplatsen. Det bevarar en tydlig redogörelse för vägen du faktiskt använde utan att en bekräftelse i konversationen behandlas som ett uppladdningskvitto. [2][3]
Ett resultat visas, men källan är oklar
Matcha resultatet mot rätt fil innan du redigerar texten. Ett liknande filnamn, ett äldre färdigt jobb eller en arkivsökträff kan vara användbart material, men är inte automatiskt den källa du avsåg att bearbeta. I WhisperTranscribe.ai väljer du rätt jobb och hämtar dess färdiga resultat. I Otter eller Fireflies behåller du mötesreferensen och verifierar vilket samtal som gav avsnittet. Tydlig källidentitet gör senare rättelser hanterbara: en granskare kan återvända till en inspelning i stället för att försöka rekonstruera vilken textsamling som gav en sammanfattning. [3][8][9]
Transkriptionen är användbar, men strukturen saknas
Skilj saknade ord från saknad presentation. Du kan omorganisera tillgänglig text till avsnitt, ta ut frågor eller bygga en beslutstabell utan att påstå att inspelningen transkriberats igen. Saknade talar- eller tidsfält är en annan fråga: rubriker skrivna av ChatGPT kan inte återskapa verifierad talartilldelning eller ursprungliga undertextgränser. Bevara okända uppgifter i arbetskopian och återvänd till inspelningen där detaljerna är nödvändiga. Den användbara frågan är vad källan stöder, inte hur övertygande en omformaterad sida ser ut.
Texten är klar, men överlämningen misslyckas
Granska själva leveransen. En PDF-länk ska leda till ett fullständigt, läsbart dokument; en undertextfil ska öppnas med avsedd timing och teckenkodning i det mottagande programmet. Håll textförberedelse åtskild från slutförd export så att ett formateringsproblem inte blir ännu en betald transkribering. Om du går från ett tillägg till dess webbplats för att slutföra exporten ska steget dokumenteras som en del av det verkliga arbetsflödet. Det kan fortfarande vara ett rimligt val, men ändrar arbetsmängden mellan första förfrågan och slutfilen.
Räkna arbetet efter igenkänningen
För ett återkommande arbetsflöde ska du dokumentera leverantörsavgifter, eventuell extra kostnad för värdmiljöåtkomst, granskningsarbete och export- eller omarbetningsarbete separat. Kategorierna möjliggör jämförelse även när abonnemang paketerar olika funktioner. En tjänst som återanvänder ett etablerat arkiv kan spara hämtningsarbete; en widget för nya filer kan minska antalet program som används för att starta ett jobb. Ingen av observationerna ger en universell kostnadsvinnare. Behåll uppmätta avgifter och observerad redigeringstid i loggen och lämna okända belopp tomma tills kontot eller ett verkligt försök fastställer dem.
Vilket tillägg passar varje utgångspunkt?
- En ny ljud-/videofil, följd av transkriptionsgranskning eller undertexter: börja med WhisperTranscribe.ai.
- En ny röstinspelning eller ett importerat klipp, främst för sammanfattning: jämför Siders inspelnings-/importflöde direkt.
- En befintlig Transkriptor-transkription och en PDF-överlämning: hämta den genom Transkriptor.
- En fråga som spänner över tidigare Otter-möten: sök i arkivet och behåll källänkar.
- Ett teamarkiv som redan finns i Fireflies: hämta relevant sammanhang och kontrollera åtgärderna som exponeras för anslutningen.
Vanliga frågor
Varför välja WhisperTranscribe.ai för en lång inspelning?
WhisperTranscribe.ai kombinerar en transkriberingsväg för nya filer med en särskild undertextingång och strukturerade fält för färdiga resultat. Det passar när en inspelning ska stödja både en granskad sammanställning och tidsatta undertexter. Den operatörsbekräftade historiska WER:en ger en separat kvalitetsreferens, medan slutvalet fortfarande beror på att ett fullständigt resultat och önskat leveransformat erhålls. [2][3][5]
Vad bör ett entimmesförsök fastställa?
Det bör fastställa att hela inspelningen kan identifieras och granskas, att sammanställningen återspeglar diskussionens slutliga ståndpunkt och att önskad undertext- eller dokumentfil fungerar på sin destination. Dokumentera faktiska uppladdnings-, bearbetnings- och granskningstider separat. Ett lyckat kort exempel ger inget uppmätt resultat för hela timmen.
Kan jag bifoga en fil i chatten och anta att den bearbetas?
I det granskade WhisperTranscribe.ai-flödet väljer du mediet inne i appwidgeten och följer jobbet som skapats för källan. En fil som bara bifogas den omgivande konversationen styrker inte att den hamnat i transkriberingskön. Ett tydligt första steg undviker dubbla uppladdningar senare.
Garanterar undertextstöd det format jag behöver?
Nej. Undertextdata, en nedladdningsbar fil och lyckad import i en målredigerare är separata kontroller. Efterfråga önskat format och granska en exempelfil innan du satsar på ett stort arbetsflöde.
Omdöme: välj vägen som slutför nästa steg
För en ny inspelning som ska bli både en sammanställning med källhänvisningar och tidsatta undertexter förtjänar WhisperTranscribe.ai att övervägas först. Dess dokumenterade arbetsflöde kopplar samman källval, färdig text och undertextdata på ett sätt som passar uppdraget. Sider är fortsatt relevant för direktinspelning; Transkriptor, Otter och Fireflies är starka alternativ när deras befintliga poster ger materialet. Den avgörande frågan är vilken väg som får hela timmen till önskad slutform med minst undvikbart omarbete. [2][3][6][7][8][9]
Tilläggslänkar och officiella guider
- Whisper Transcribe AI — WhisperTranscribe.ai
- Sider Recorder & Transcriber
- Transkriptor
- Otter.ai
- Fireflies — officiell anslutningsguide
Länkarna identifierar den officiella ingången eller guiden; de lovar inte tillgänglighet för varje konto. Använd den namngivna anslutna appen i stället för en anpassad GPT med liknande namn.
Källor och granskningsmetod
Dokumentationskällor kontrollerades den 21 oktober 2026; fyra användartillhandahållna originalskärmbilder från WhisperTranscribe.ai lades till den 22 oktober. De visar ChatGPT-tilläggslistningen, reglage före uppladdning för transkribering och undertexter samt menyn för talat språk. Deras skärmbildsdatum angavs inte och inget slutfört uppladdnings- eller transkriberingsresultat visas. Det redaktionella entimmesuppdraget utvecklas från officiella appbeskrivningar och integrationsguider, med separat användarbekräftad historisk WER-dokumentation. Det är inget nytt tids- eller igenkänningsbenchmarktest av fem produkter. Leverantörsbilder förblir märkta exempel och Excel-figurerna är sammanställda kalkylblad. Skärmbilder av Sider-komponenten återstår. [13]
- Anslutna appar i ChatGPT. OpenAI. Kontrollerad 2026-10-21. Officiell plattformsdokumentation.
- Whisper Transcribe AI — officiell ChatGPT-tilläggslistning. WhisperTranscribe.ai / ChatGPT:s tilläggskatalog. Kontrollerad 2026-10-21. Officiell offentlig listning.
- Anteckningar om den anslutna appens funktioner. Exponerade appbeskrivningar granskade för denna recension. Kontrollerade 2026-10-21. Granskning av appspecifikation.
- WhisperTranscribe.ai:s historiska mätningar bekräftade av operatören. Produktoperatör; uppgift om tillämplighet för WhisperTranscribe.ai lämnad den 21 oktober 2026. Kontrollerad 2026-10-21. Användarbekräftade historiska produktresultat; ingen ny entimmeskörning av tillägget.
- Sider Recorder & Transcriber — officiell ChatGPT-listning. Sider AI / ChatGPT:s tilläggskatalog. Kontrollerad 2026-10-21. Officiell offentlig listning.
- Transkriptor-app för ChatGPT. Transkriptor. Kontrollerad 2026-10-21. Officiell integrationsguide.
- Otter MCP Server. Otter Help. Uppdaterad 2026-10-15. Kontrollerad 2026-10-21. Officiell hjälpguide.
- Fireflies MCP Server: Anslut dina AI-verktyg direkt till dina mötesdata. Fireflies Knowledge Base. Kontrollerad 2026-10-21. Officiell integrationsguide.
- Transkriptor — officiell ChatGPT-tilläggslistning. Transkriptor / ChatGPT:s tilläggskatalog. Kontrollerad 2026-10-21. Officiell offentlig listning.
- Otter.ai — officiell ChatGPT-tilläggslistning. Otter.ai / ChatGPT:s tilläggskatalog. Kontrollerad 2026-10-21. Officiell offentlig listning.
- Fireflies MCP-verktyg. Fireflies Developer Documentation. Kontrollerad 2026-10-21. Officiell allmän MCP-verktygskatalog.
- Whisper Transcribe AI: användartillhandahållna skärmbilder av ChatGPT-gränssnittet. Användartillhandahållna original, mottagna den 22 oktober 2026. Kontrollerade 2026-10-22. Användartillhandahållna originalskärmbilder av ChatGPT-gränssnittet.
Ladda ned den redigerbara Excel-arbetsboken · Källförteckning · Mätningarnas ursprung